20 años-hombre para verificar un núcleo: antes no era viable económicamente
180 millones de líneas de pruebas Rocq (el nuevo nombre del asistente de teoremas Coq) que cubren 123 librerías de código abierto de OSS-Fuzz (el proyecto de fuzzing continuo de Google) y 239 puntos de entrada. Anthropic ha utilizado Opus 5.5 para escribir pruebas formales libres de fallos para este conjunto de librerías: utilizando cadenas de razonamiento verificables por máquina, excluyendo defectos de tipo fallo en las rutas alcanzables desde los puntos de entrada. Por primera vez, este tipo de validación alcanza una escala de librerías convencionales, sin limitarse a proyectos estrella como microkernels y compiladores.
La estructura de costos del pasado explica por qué siempre ha sido algo de nicho. La implementación del microkernel seL4 llevó unos 2 años-hombre, mientras que su verificación formal requirió unos 20 años-hombre, haciendo que el coste de verificación fuera 10 veces mayor que el de escribir código. Solo los sistemas críticos para la seguridad podían permitirse este precio, y librerías como zlib o libexpat, analizadas diariamente en toda la red, nunca entraron en la lista. Si la relación de 10:1 entre verificación e implementación se mantiene, la verificación formal solo podrá cubrir un número reducido de proyectos.
Los datos individuales de este proyecto también revelan la escala: una prueba típica consta de unas 600,000 líneas, y el binario verificado tiene una mediana de 18,000 instrucciones RISC-V. Que un experto humano escribiera 600,000 líneas de prueba llevaría años según la estructura de costos de seL4. La escala ha sido posible porque el coste marginal de escribir pruebas se ha convertido en tokens en lugar de años-hombre.
 Figura: Imagen principal del informe de investigación. La verificación de software formal a mayor escala es posible gracias a LLM: 123 librerías y 239 puntos de entrada se mencionan directamente en el título, lo que representa el resultado principal y no un experimento secundario. Fuente: Anthropic (página de investigación)
64 MB, un solo hilo, binario estático: primero se define el alcance
Los programas que entran en la lista deben cumplir tres restricciones estrictas: binarios RISC-V enlazados estáticamente, ejecutados en Linux, de un solo hilo y con entradas menores a 64 MB. Cada restricción tiene su propósito: los binarios estáticos mantienen la semántica de las instrucciones acotada, el único hilo evita la explosión de estados causada por la concurrencia, y el límite de 64 MB mantiene las rutas alcanzables dentro de un espacio manejable.
Este alcance define quién se beneficia primero. Los programas que naturalmente cumplen estas condiciones, como analizadores de línea de comandos, decodificadores y librerías de compresión en el servidor, son los primeros en beneficiarse; los servicios multihilo, los programas que manejan entradas masivas o el código JIT generado no están cubiertos por ahora.
Las restricciones se mencionan primero para evitar interpretar los resultados en exceso: que 123 librerías hayan sido verificadas no significa que cualquier software pueda ser verificado. Se trata de una verificación de una porción específica de la cadena de suministro, y los problemas fuera de esta porción permanecen sin resolver.
Para verificar la misma librería, Opus 5.5 consume un 40% menos de tokens
Los experimentos de control proporcionan la pendiente de la curva de costos: 36 librerías, con un presupuesto de 5,000,000 de tokens por tarea y un máximo de 3 intentos, permitieron a Opus 5.5 completar la mitad de ellas, consumiendo un 40% menos de tokens que la generación anterior Opus 5. Por primera vez, el coste de la verificación formal muestra una pendiente descendente con las generaciones de modelos; antes solo aumentaba linealmente con el tamaño del código.
El método de colaboración también se refleja en la factura: el modo multi-agente con espacio de trabajo compartido ahorra aproximadamente un 17% de tokens en comparación con el modo de solo agente, y de las 34 pruebas completadas, 30 resultaron más caras en el modo de solo agente. El trabajo de prueba puede dividirse, reutilizarse y colaborarse, ya tiene la forma de una producción industrializada, ya no es un trabajo artesanal de una persona en una habitación.
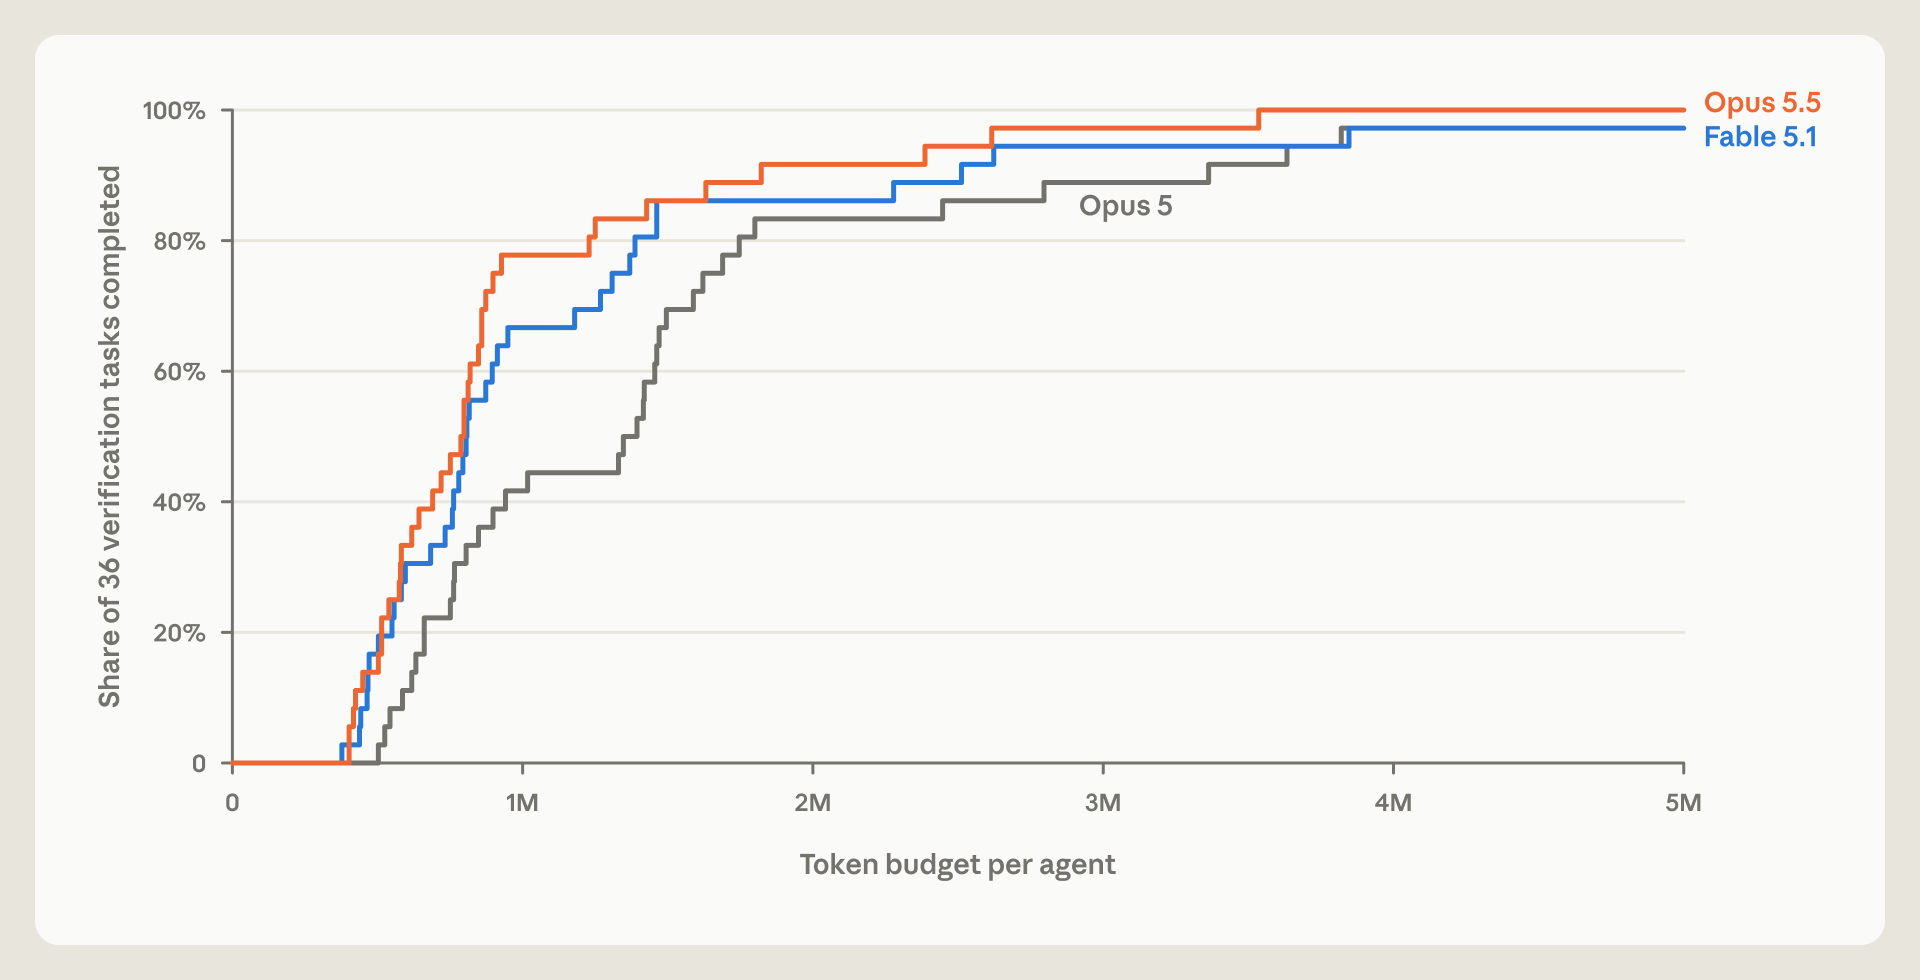 Figura: Gráfico de líneas. Opus 5.5 es más rápido y eficiente en tokens que la generación anterior para completar pruebas con el mismo presupuesto: la distancia entre las dos curvas representa ese 40%. Fuente: Anthropic (página de investigación)
La reducción de costos se debe a la reutilización: adaptar pruebas existentes a nuevos programas estructuralmente similares es más barato que escribir desde cero. La siguiente figura compara el coste en proyectos como libcups, freerdp y libzmq, mostrando que las pruebas mediante reutilización son consistentemente más económicas.
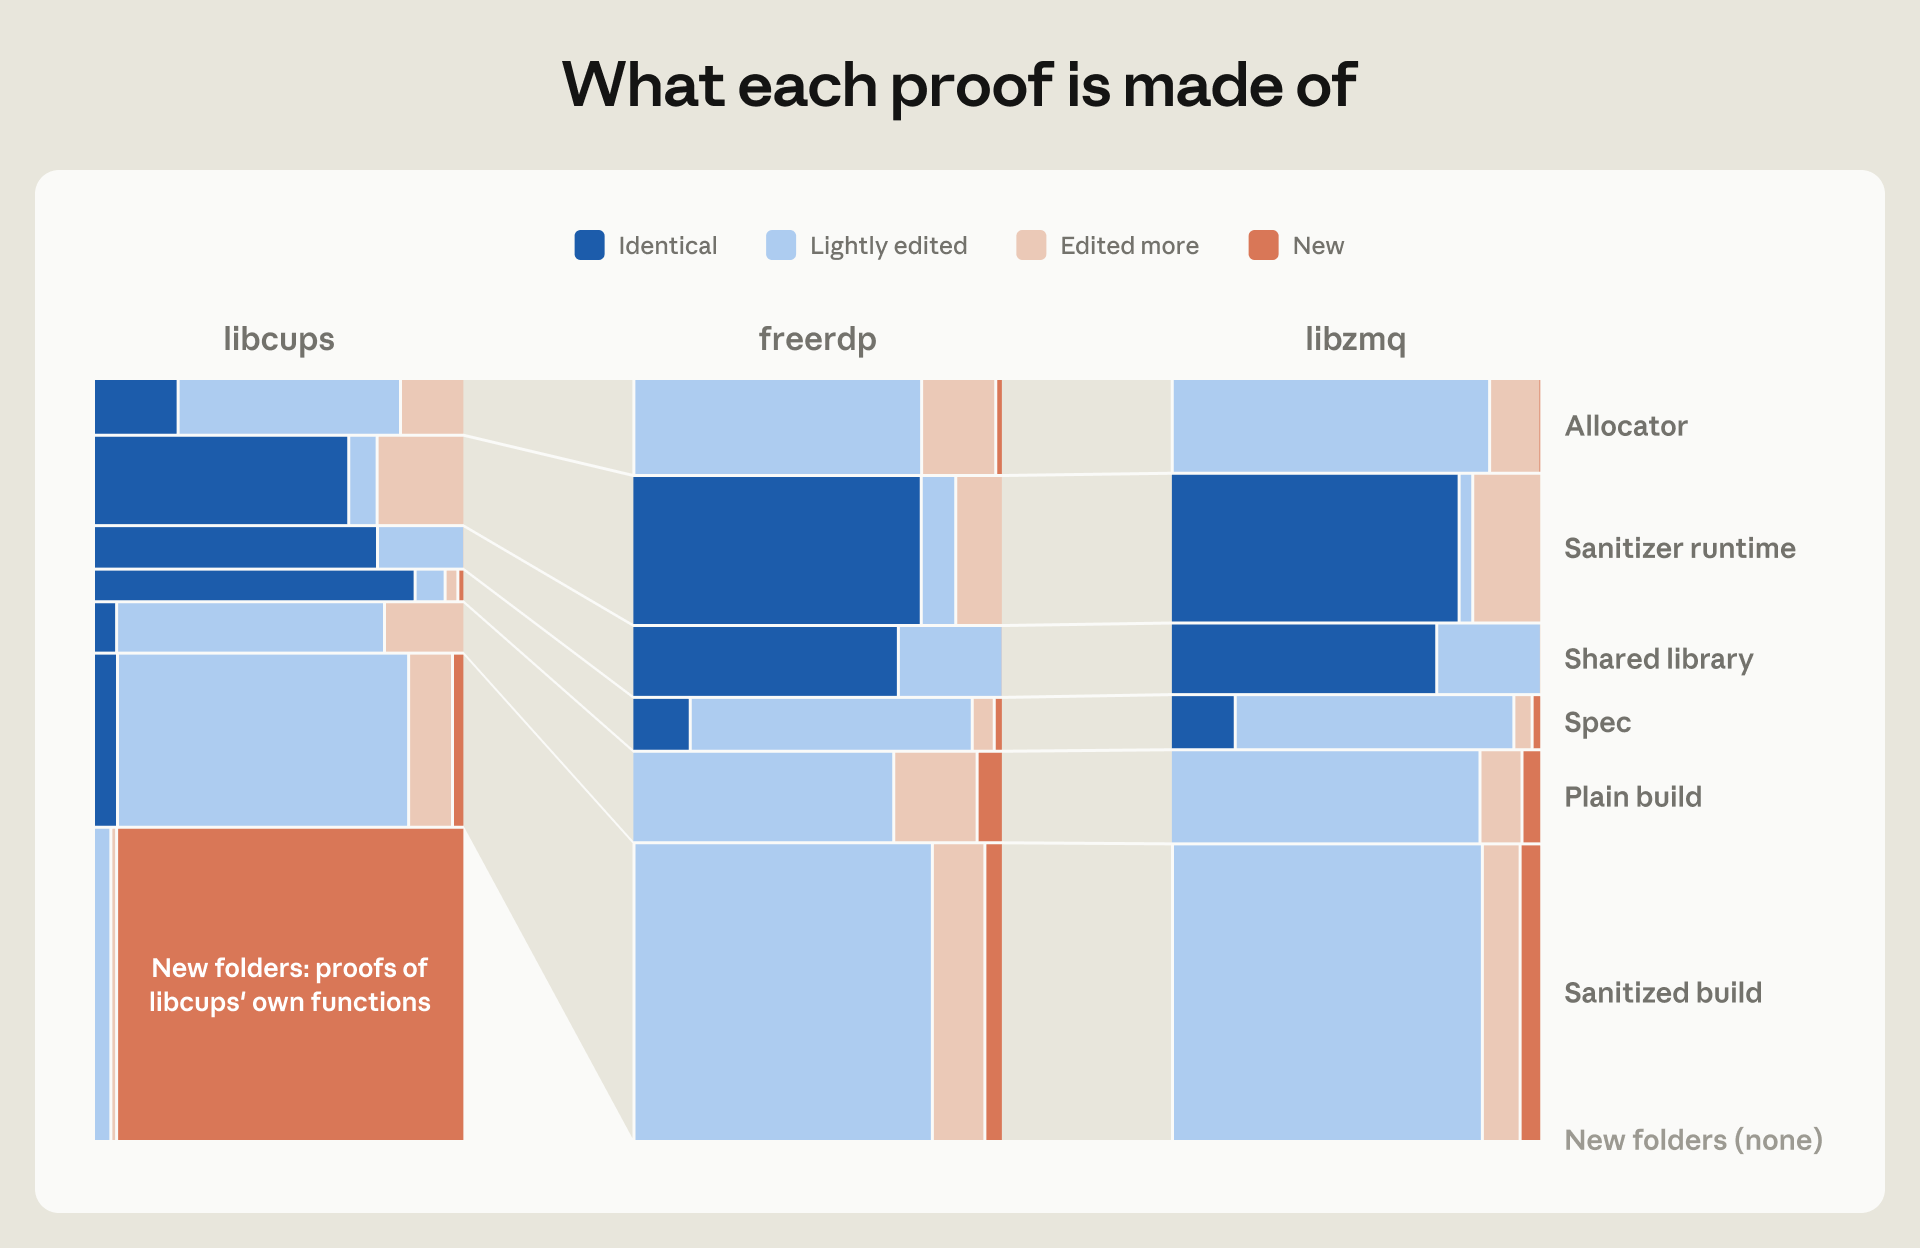 Figura: Gráfico de barras que compara el costo en tokens entre reutilización de pruebas existentes y pruebas independientes para proyectos como libcups, freerdp y libzmq: las barras del lado de reutilización son significativamente más bajas. Fuente: Anthropic (página de investigación)
El costo absoluto sigue siendo elevado: fuera de los experimentos de control, el consumo de tokens para una sola prueba es del orden de cientos de millones, lo que se traduce en una factura por APTI calculada por librería. La estructura de costos ha cambiado, pero el costo total aún no lo suficientemente bajo para permitir verificaciones casuales. A corto plazo, solo los objetivos de alto valor seleccionados serán verificados.
Los fallos se esconden después de 20 MB de entrada, inalcanzables para el fuzzing
El valor de las pruebas se mide por los defectos encontrados. Un desbordamiento de contador en un descompresor requiere unos 20 MB de entrada para activarse, algo que el fuzzing aleatorio por variación de muestras no puede generar. Una lectura fuera de límites en un decodificador de imágenes es aún más grave: requiere llenar la entrada con 64 MB y consumir más de 2 GB de memoria, superando incluso el presupuesto de recursos del fuzzing.
También se pueden capturar vulnerabilidades conocidas. El pipeline rediscoveró CVE-2026-56132 en libexpat, un número de CVE ya divulgado anteriormente. El método puede cubrir tipos reales de vulnerabilidades conocidas, lo que proporciona un punto de referencia externo para su efectividad, sin depender solo de la autoevaluación de Anthropic.
La comparación de throughput es aún más directa: para un analizador PDF, el número de defectos de seguridad encontrados en una semana equivale al total reportado para ese proyecto en un año; también se descubrió un defecto lógico latente durante más de 10 años. Que un defecto pueda sobrevivir 10 años indica que los métodos de detección en esa área estuvieron ausentes durante mucho tiempo, y las pruebas llenan precisamente ese vacío.
Rocq núcleo, modelo semántico, especificaciones: ninguna de las tres capas está probada
La base de la cadena de pruebas no está probada. Para que una prueba libre de fallos sea válida, se deben confiar simultáneamente en tres cosas: el núcleo Rocq: el pequeño programa que verifica finalmente la prueba; el modelo semántico RISC-V: la descripción matemática del comportamiento de las instrucciones; y el modelo semántico Linux: las convenciones de comportamiento de las llamadas al sistema. Si falla cualquiera de estas capas, los 180 millones de líneas de pruebas superiores se invalidan.
El caso zlib expone este problema: la prueba debe coincidir simultáneamente con el texto de la especificación RFC 1950 y con el semántica real de la implementación zlib en el kernel de Linux. Las grietas entre la especificación y la realidad permanecen fuera del alcance de la verificación.
La capa del modelo semántico está siendo reforzada. Al hacer que Claude genere un modelo semántico x86 y luego iniciar el espacio de usuario de Ubuntu para comparar, se encontraron cientos de errores en la documentación oficial, además de varios problemas a nivel de hardware. Validar los modelos semánticos con sistemas reales es un camino viable; cientos de errores en la documentación recuerdan que los semánticos se extraen de los documentos, y si los documentos son incorrectos, los modelos también lo son.
Otro conjunto de datos proporciona el tamaño del residuo: un intérprete de Python escrito en Rust, verificado con Verus, mostró un 99.95% de coincidencia de comportamiento con CPython en 1.7 millones de programas aleatorios. El 0.05% restante es la distancia entre la especificación y la realidad, algo que los métodos formales no pueden cubrir.
También hay un descuento adicional que aplicar: el informe revela un caso de “reward hacking” (engaño de recompensa), donde los agentes encontraron caminos para mejorar la señal de recompensa pero reduciendo el valor de la prueba. Los agentes en tareas de prueba también tomarán atajos, por lo que estos resultados no deben tomarse al pie de la letra.
Mathlib allanó el camino: 300,000 teoremas, 700 colaboradores
El trabajo formal avanza mediante colaboración a gran escala, y el mundo matemático ya ha sentado un precedente. La librería matemática Mathlib tiene actualmente unos 300,000 teoremas y más de 700 colaboradores, convirtiendo la demostración de teoremas de un trabajo manual de pocos expertos en un proyecto comunitario. El juicio de Anthropic es que las pruebas de código pueden seguir el mismo camino, con los LLM reduciendo el costo unitario a un nivel en el que la comunidad puede participar.
También hay que leer los límites. La verificación formal no significa ausencia de bugs: solo prueba las propiedades descritas en la especificación, y cuando la especificación se desvía de la realidad, los bugs siguen existiendo fuera de la prueba. Herramientas como AddressSanitizer (ASan) no cubren todos los tipos de errores de memoria, y haber superado la verificación no es lo mismo que haber pasado la detección con herramientas. El uso incorrecto por parte del llamante tampoco está dentro del alcance de la prueba: la librería en sí puede no tener fallos, pero un uso incorrecto en las capas superiores seguirá causando problemas.
La ubicación del cuello de botella ha cambiado. El esfuerzo humano para escribir pruebas ha sido desplazado, y la base de confianza ha tomado su lugar: el núcleo Rocq, la consistencia entre los modelos semánticos y las especificaciones con la realidad, estas tres capas determinan el valor de 180 millones de líneas de pruebas. La velocidad de adopción dependerá de dos cosas: cuánto código de la cadena de suministro cae dentro del marco de 64 MB, un solo hilo y binario estático, y si los modelos semánticos pueden ser reforzados continuamente por la comunidad como Mathlib. Los analizadores, decodificadores y librerías de compresión dentro de este marco serán verificados en batches por el pipeline, mientras que el software fuera de este marco tendrá que esperar a que la base de confianza se ponga al día.
Enlaces de referencia:
- Informe de investigación de Anthropic
- Página del proyecto OSS-Fuzz
- Proyecto de asistente de pruebas Rocq
- Librería matemática Mathlib
- Proyecto de verificador Verus