カーネル1つを検証するのに20人年—この計算は過去に成り立たなかった
1.8億行に及ぶRocq(Coq定理証明器の新名称)の証明が、OSS-Fuzz(Googleの継続的ファジングテストプロジェクト)からの123のオープンソースライブラリと239のエントリポイントをカバーした。AnthropicはOpus 5.5を用いてこれらのライブラリに対して形式化されたクラッシュフリー証明を生成した—機械検証可能な推論チェーンを用いて、エントリポイントから到達可能な経路上のクラッシュ類の欠陥を排除する。この種の検証は初めて一般的なオープンソースライブラリの規模に到達し、マイクロカーネルやコンパイラといった少数の注目プロジェクトに留まらないようになった。
過去のコスト構造が、なぜ常にニッチな分野であったかを説明している。seL4マイクロカーネルの実装には約2人年、形式検証には約20人年が費やされ、検証コストはコード作成の10倍にのぼった。この価格を負担できるのはセキュリティが重要なシステムのみであり、zlibやlibexpatのような毎日世界中で解析されているライブラリはリストに含まれたことがなかった。実装より10倍も検証が高価—この比率が変わらない限り、形式検証は常にわずかなプロジェクトにしか及ばない。
今回の単一データ点もまた、その規模を読み取れる:典型的な証明1つあたり約60万行、検証されたバイナリの中位数は1.8万のRISC-V命令である。人間の専門家が60万行の証明を手書きするには、seL4のコスト構造では年単位の時間がかかる。規模を拡大できる前提は、証明作成の限界コストを人年からトークンに換算することにある。
 図:研究報告の表紙。LLMにより形式化ソフトウェア検証がより大規模に可能に—123のライブラリ、239のエントリポイントがタイトル層に直接記載され、これは主な結果であって隅々での実験ではない。出典:Anthropic(研究ページ)
64MB、シングルスレッド、静的バイナリ:範囲を明確に定義
検証対象となるプログラムには3つの厳しい制約がある:静的にリンクされたRISC-Vバイナリ、Linux上での実行、シングルスレッド、入力が64MB未満。これらの制約にはそれぞれ理由がある—静的バイナリにより命令セマンティクスが限定され、シングルスレッドは並発による状態爆発を排除し、64MBの入力は到達可能な経路を処理可能な空間に制限する。
この範囲が、誰が最初に恩恵を受けるかを定義している。サーバーサイドのコマンドラインパーサー、デコーダー、圧縮ライブラリのような、自然と条件を満たすプログラムが最初の対象となる。マルチスレッドサービス、超大規模な入力を処理するプログラム、JIT生成のコードは当面のカバー範囲外にある。
制約を先に述べたのは、結果を過大に解釈しないためである:123のライブラリが検証されたからといって、任意のソフトウェアが検証可能というわけではない。これはサプライチェーンの特定のスライスに対する検証であり、スライス外の問題はそのまま存在する。
同じライブラリを検証する場合、Opus 5.5は40%少ないトークンを消費
対照実験がコスト曲線の傾きを示している:36のライブラリ、各タスク500万トークンの予算、最大3回の試行、Opus 5.5はその半数を検証し、トークン消費量は前世代のOpus 5より約40%少ない。形式検証のコストは初めてモデル世代の進化に伴って減少する傾きを示し、過去はコード規模に比例してのみ増加していた。
協働方式も請求書に記載されている:マルチエージェントがワークスペースを共有する方式はシングルエージェントより約17%のトークンを節約し、完了した34の証明のうち30はシングルエージェントモードでより高価であった。証明作業は分割可能、再利用可能、協働可能であり、すでに工業生産の形態を備え、一人一室の職人仕事ではない。
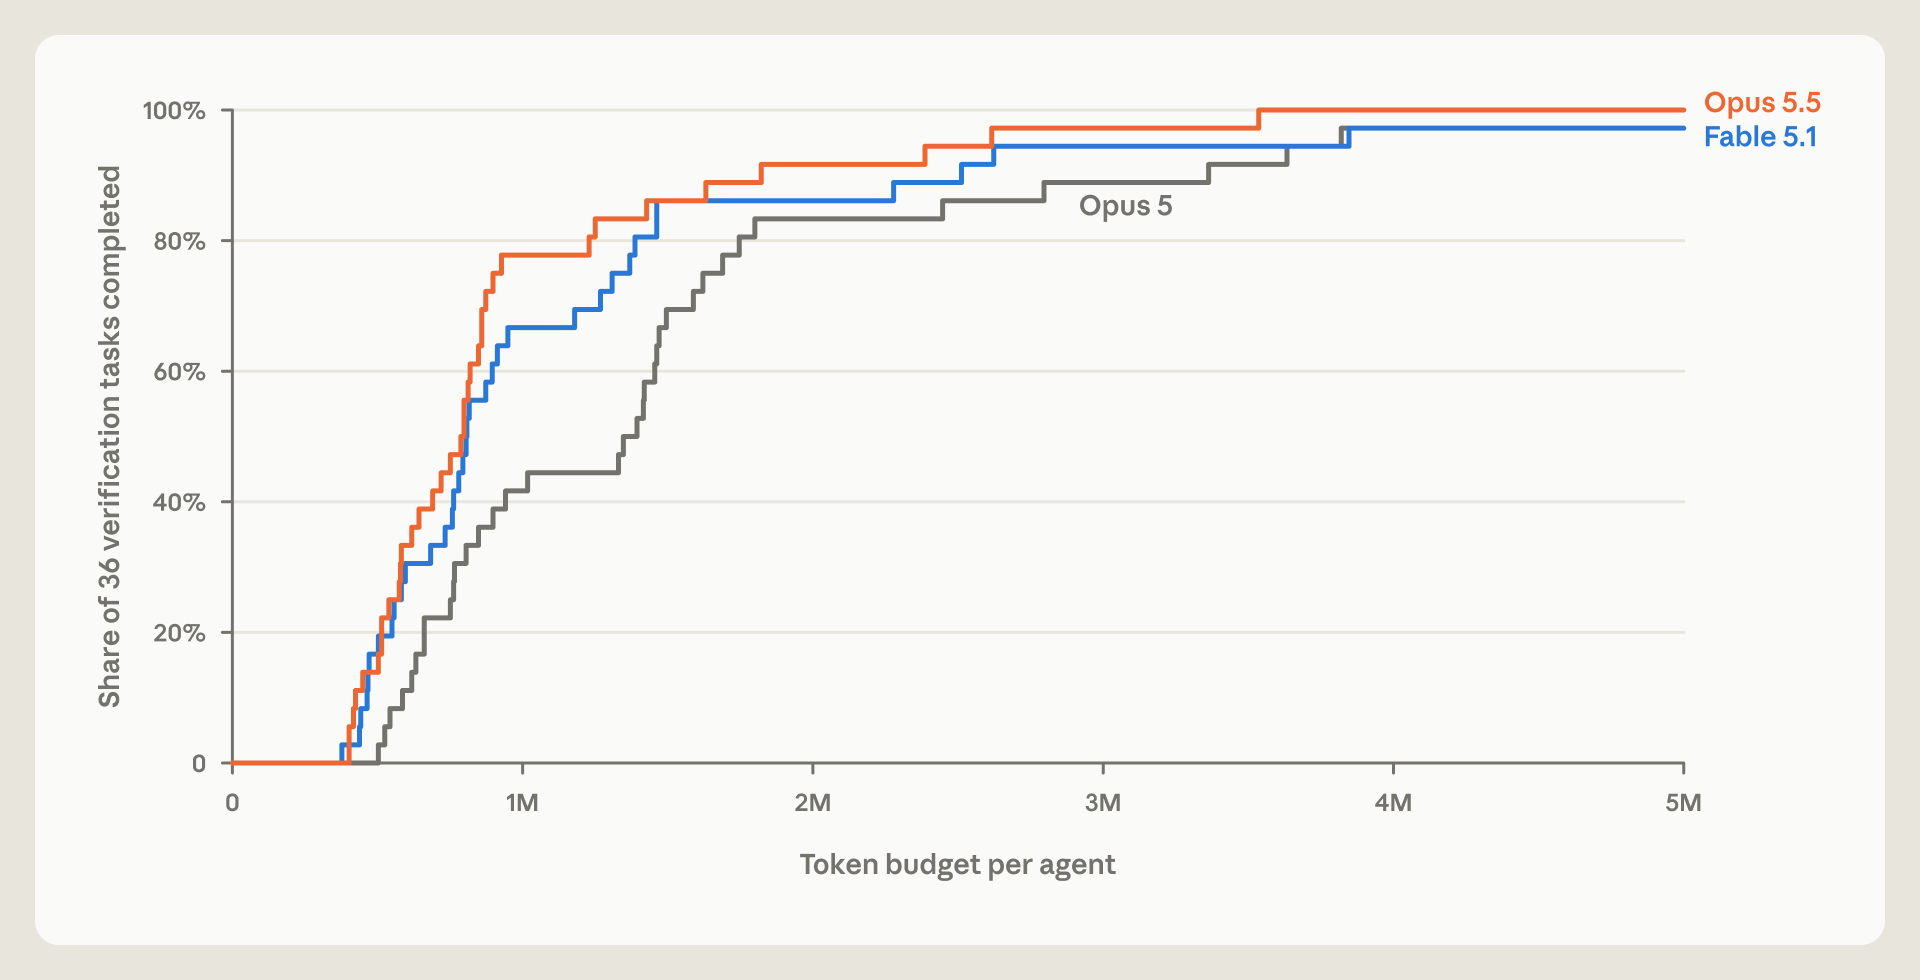 図:折れ線グラフ。Opus 5.5は同じ予算下での証明完了速度とトークン効率の両方で前世代を上回る—2つの曲線の間隔がその40%である。出典:Anthropic(研究ページ)
コストが削減されたメカニズムは再利用にある:既存の証明を構造的に似た新しいプログラムに書き換えることは、ゼロから書くより安価である。以下の図はlibcups、freerdp、libzmqなどのプロジェクトの比較であり、再利用経路の証明は一般的により節約的である。
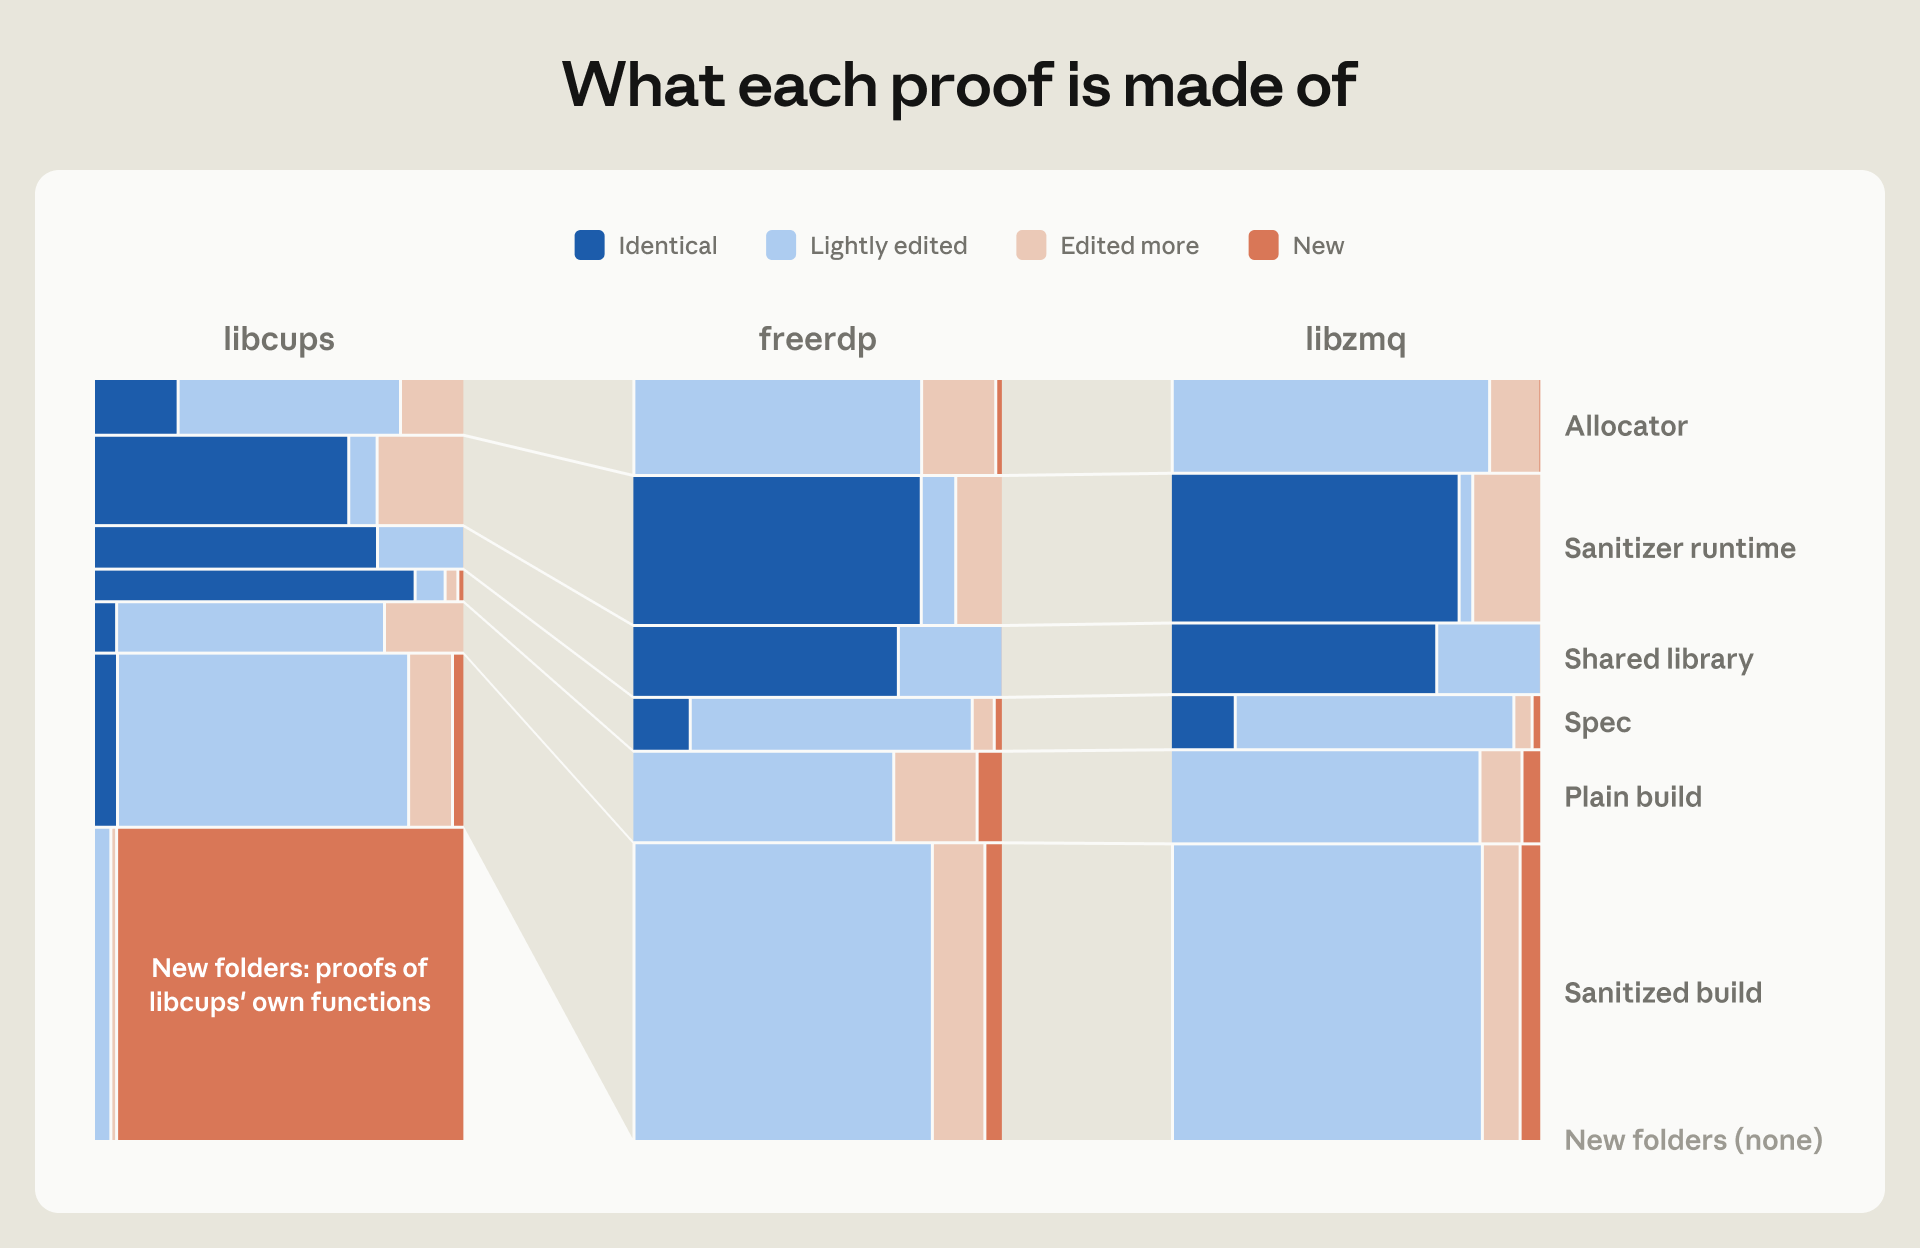 図:棒グラフ。libcups、freerdp、libzmqなどのプロジェクトにおける既存証明の再利用と独立証明間のトークンコスト比較—再利用側の棒は大幅に短い。出典:Anthropic(研究ページ)
絶対コストは依然として大きな数字を読み取る必要がある:対照実験以外で、単一証明のトークン消費量は数億単位に達し、API請求書ではライブラリ単位の金額となる。コスト構造は変わったが、総量はまだ手軽に検証できるレベルには至っておらず、当面検証されるのは選りすぐりの高価値ターゲットのみとなる。
欠陥は20MBの入力の後に潜んでおり、ファジングテストでは発見不能
証明の価値は発見された欠陥で検証される必要がある。デコーダー内のカウンターのアンダーフローは約20MBの入力を必要とし、ランダムなファジングテストでは変異サンプリングだけでは十分な長さの接頭語を生成できない。画像デコーダーの境界外読み取りはさらに深刻:64MBの入力を供給し2GB以上のメモリを消費する必要があり、ファジングテストのリソース予算すら満たせない。
既知の脆弱性も再捕捉可能。パイプラインはlibexpatのCVE-2026-56132を再発見した—この番号は以前に公開されていた。この方法が既知の実際の脆弱性タイプをカバーできることは、有効性に外部の基準点を与え、Anthropicの自己評価だけに頼る必要をなくす。
スループット比較はより直感的である:PDFパーサーでは、1週間以内に発見されたセキュリティ欠陥の数は、そのプロジェクトがこれまで1年間に報告された総量に相当する。10年以上潜伏していた論理欠陥も掘り返された。欠陥が10年間生存できたということは、その位置での検知手段が長期間欠如していたことを意味し、証明が補ったまさにその空白である。
Rocqカーネル、セマンティックモデル、仕様:三層とも証明されていない
証明チェーンの底部には証明がない。クラッシュフリー証明が成立するためには、同時に三つのものを信頼する必要がある:Rocqカーネル—最終的に証明をチェックする小さなプログラム;RISC-Vセマンティックモデル—命令動作の数学的記述;Linuxセマンティックモデル—システムコールの動作に関する約束。いずれかの層でエラーが発生すれば、上の1.8億行の証明も無効になる。
zlibのケースがこの問題を表面化させた:証明はRFC 1950の仕様テキストとLinuxカーネル内のzlibの実際の実装セマンティクスの両方と一致させる必要がある。仕様と現実の間の隙間は、証明のカバー範囲外に残される。
セマンティックモデル層は強化されている。Claudeにx86セマンティックモデルを生成させ、Ubuntuユーザースペースで比較検証を行い、公式リファレンスドキュメントから数百箇所の誤りを発見し、さらにいくつかはハードウェアレベルの問題であった。実際のシステムでセマンティックモデルを検証するこの道は有効である;同時に数百のドキュメント誤りは、セマンティクスがドキュメントから読み取られるものであり、ドキュメントが間違っていればモデルも間違うことを示唆している。
もう一組の数字が残差の大きさを示している:Rustで書かれたPythonインタプリタはVerusで検証後、170万個のランダムプログラムで99.95%の動作がCPythonと一致した。残りの0.05%が仕様と現実の間の距離であり、形式化手法ではこの部分を扱えない。
割り引かれるべきもう一つの割引:報告書には報酬の不正利用(reward hacking)事例が1件開示されている—エージェントが報酬信号を良く見せて証明の価値は縮小する経路を見つけた。証明タスクにおいてもエージェントは近道を試みるため、この種の結果は文字通りの意味で全面的に受け入れられるわけではない。
Mathlibが一度踏み出した:30万の定理、700人の貢献者
形式化作業は規模化された協働によって進められ、数学界では既に先例が示されている。Mathlib数学ライブラリには現在約30万の定理、700人以上の貢献者が存在し、定理証明は少数の専門家の手作業からコミュニティによる工業プロセスへと変わった。Anthropicの判断では、コード証明も同じ道を進めることができ、LLMが単一コストをコミュニティが参加できるレベルまで引き下げる役割を担う。
境界も読み取る必要がある。形式検証がバグがないこととは異なる—証明されているのは仕様記述の性質であり、仕様と現実が乖離すればバグは証明の外に存在し続ける。AddressSanitizer(ASan)のようなツールはすべてのメモリエラータイプをカバーせず、検証を通過したこととツール検出を通過したことは異なる主張である。呼び出し側の誤用は証明範囲外である:ライブラリ自体はクラッシュしなくても、上層での誤った使用は問題を引き起こす。
ボトルネックの位置が変わった。証明作成の人件力のボトルネックは取り除かれ、信頼基盤が浮上してきた—Rocqカーネル、セマンティックモデル、仕様と現実の一貫性、この三層が1.8億行の証明の価値を決定する。拡散速度は二つの事項に依存する:サプライチェーンのコードのうちどれだけが64MB、シングルスレッド、静的バイナリという枠にはまるか、そしてセマンティックモデルがMathlibのようにコミュニティによって継続的に強化できるか。枠内のパーサー、デコーダー、圧縮ライブラリはパイプラインで次々と検証され、枠外のソフトウェアはまず基盤が追いつくのを待つ必要がある。
参照リンク:
- Anthropic研究報告
- OSS-Fuzzプロジェクトページ
- Rocq証明アシスタントプロジェクト
- Mathlib数学ライブラリ
- Verus検証器プロジェクト