20 années-homme pour vérifier un noyau : un calcul qui ne tenait pas la route
180 millions de lignes de preuves Rocq (le nouveau nom du prouveur de théorèmes Coq) couvrant 123 bibliothèques open source de OSS-Fuzz (le projet de fuzzing continu de Google) et 239 points d’entrée. Anthropic a utilisé Opus 5.5 pour produire des preuves formelles sans plantage pour ces bibliothèques : en chaînes de raisonnement vérifiables par machine, excluant les défauts de plantage sur les chemins accessibles depuis les points d’entrée. Pour la première fois, ce type de validation atteint l’échelle des bibliothèques open source courantes, se limitant plus aux quelques projets phares comme les micro-noyaux et les compilateurs.
L’ancienne structure des coûts explique pourquoi ce domaine restait de niche. La mise en œuvre du micro-noyau seL4 a pris environ 2 années-homme, tandis que la vérification formelle en a nécessité environ 20, faisant multiplier par 10 le coût de la vérification par rapport à l’écriture du code. Seuls les systèmes critiques en sécurité pouvaient se permettre ce prix, et des bibliothèques comme zlib ou libexpat, analysées quotidiennement sur tout Internet, n’étaient jamais concernées. Si la vérification reste 10 fois plus chère que l’implémentation, la vérification formelle ne pourra couvrir qu’un nombre très limité de projets.
Les données actuelles révèlent également l’ampleur de l’effort : une preuve typique compte environ 600 000 lignes, et le binaire vérifié contient en médiane 18 000 instructions RISC-V. Faire écrire à des experts humains 600 000 lignes de preuves prendrait des années selon la structure des coûts de seL4. L’échelle ne devient possible que si le coût marginal de la rédaction de preuves passe des années-homme aux tokens.
 Figure : page de titre du rapport de recherche. La vérification logicielle formelle à grande échelle devient possible grâce aux LLM — 123 bibliothèques et 239 points d’entrée sont mentionnés en titre, ce qui représente le résultat principal et non une expérience marginale. Source : Anthropic (page de recherche)
64 Mo, monothread, binaire statique : des limites bien définies
Les programmes éligibles doivent respecter trois contraintes strictes : binaire RISC-V lié statiquement, s’exécutant sur Linux, monothread, avec une entrée inférieure à 64 Mo. Chaque contrainte a son utilité : le binaire statique garantit une sémantique d’instructions bornée, le monothread évite l’explosion des états due au parallélisme, et la limite de 64 Mo maintient les chemins accessibles dans un espace gérable.
Cette délimitation détermine qui bénéficie en premier des avancées. Les analyseurs de ligne de commande côté serveur, les décodeurs et les bibliothèques de compression, qui répondent naturellement à ces conditions, sont les premiers concernés ; les services multithread, les programmes traitant d’entrées très volumineuses ou le code JIT généré ne sont pas couverts pour l’instant.
Ces contraintes sont mentionnées en premier pour éviter de surinterpréter les résultats : le fait que 123 bibliothèques aient été vérifiées n’implique pas que n’importe quel logiciel puisse être vérifié. Il s’agit d’une validation d’une tranche spécifique de la chaîne d’approvisionnement, et les problèmes en dehors de cette tranche persistent tels quels.
Pour la même bibliothèque, Opus 5.5 consomme 40% de tokens en moins
L’expérimentation comparative révèle la pente de la courbe des coûts : sur 36 bibliothèques, avec un budget de 5 000 000 de tokens par tâche et un maximum de 3 tentatives, Opus 5.5 a réussi à en vérifier la moitié, consommant environ 40% de tokens de moins que la génération précédente Opus 5. Pour la première fois, le coût de la vérification formelle présente une décroissance avec les générations de modèles, alors qu’il augmentait précédemment uniquement linéairement avec la taille du code.
Le mode de collaboration est également intégré à l’analyse : l’espace de travail partagé par plusieurs agents économise environ 17% de tokens par rapport au mode mono-agent, et parmi les 34 preuves complétées, 30 étaient plus coûteuses en mode mono-agent. La rédaction de preuves peut être divisée, réutilisée et collaborative, adoptant déjà une forme de production industrielle plutôt qu’un artisanat d’atelier.
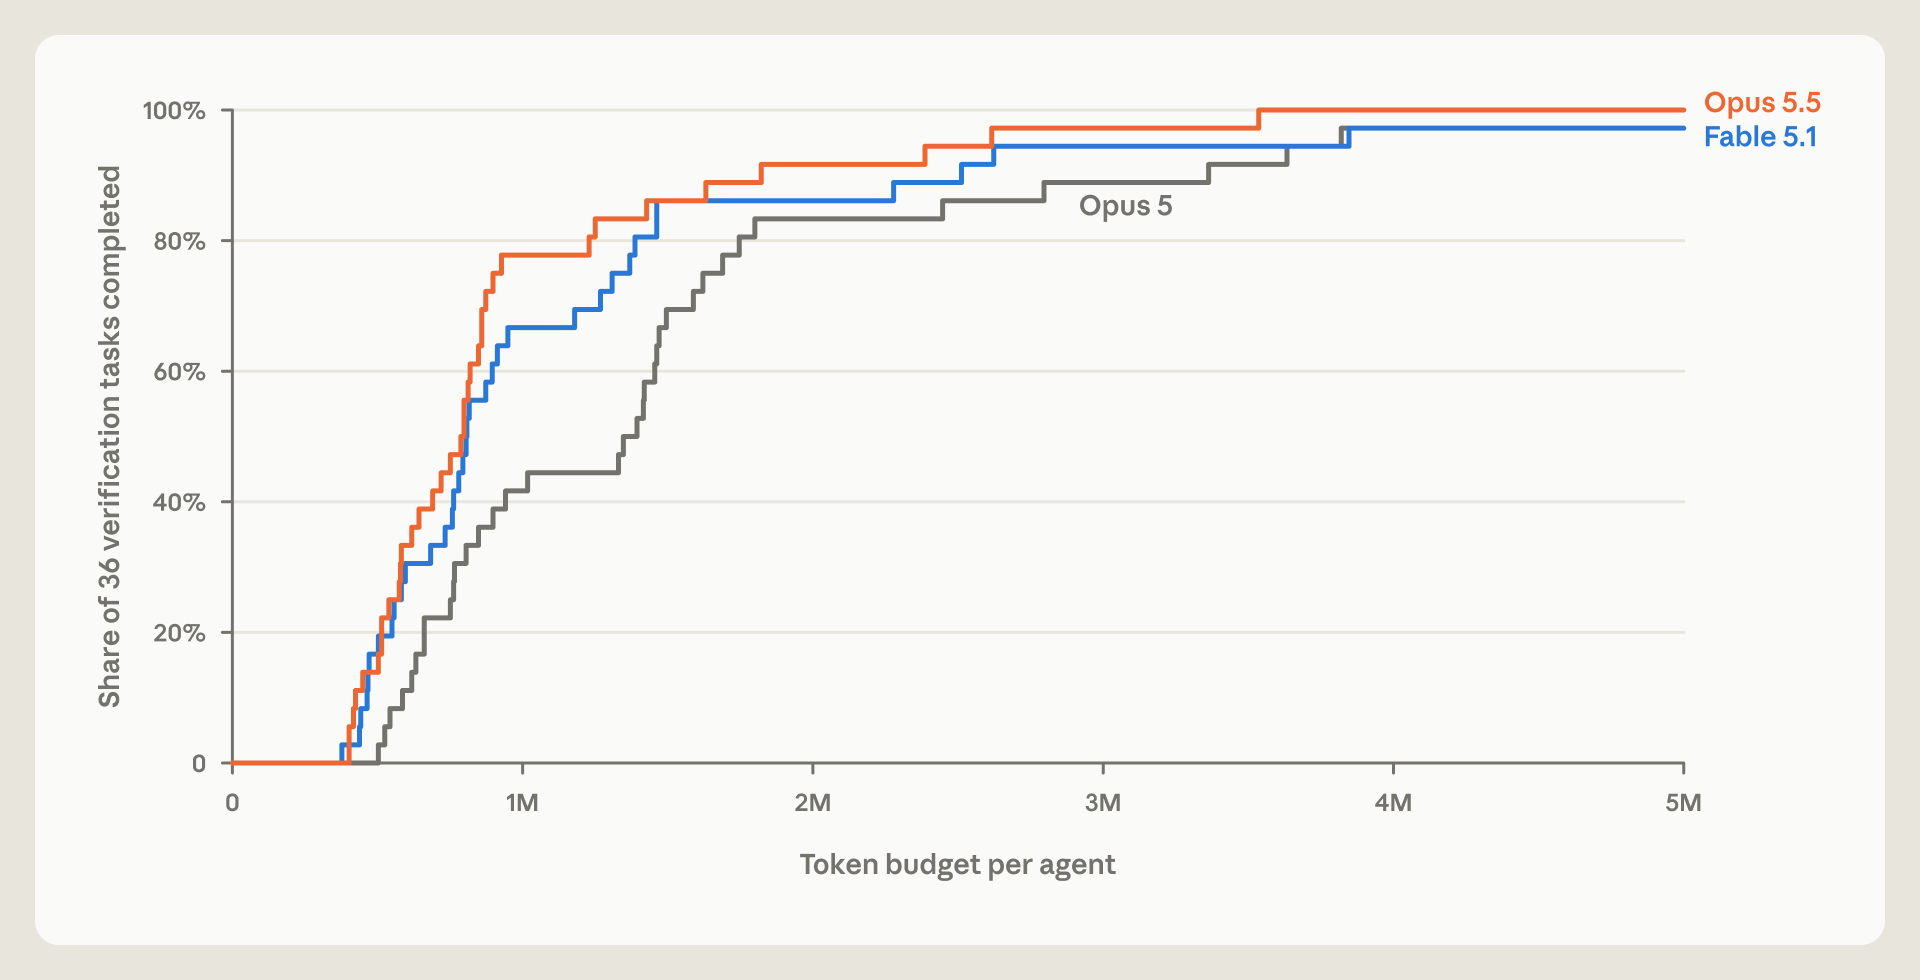 Figure : graphique linéaire. Opus 5.5 est plus rapide et plus efficace en tokens pour compléter les preuves dans le même budget que la génération précédente — l’écart entre les deux courbes représente ces 40%. Source : Anthropic (page de recherche)
La réduction des coûts provient de la réutilisation : adapter une preuve existante à un nouveau programme structurellement similaire est moins coûteux que de partir de zéro. Le graphique suivant compare les coûts pour des projets comme libcups, freerdp et libzmq, montrant que les preuves réutilisées sont généralement plus économiques.
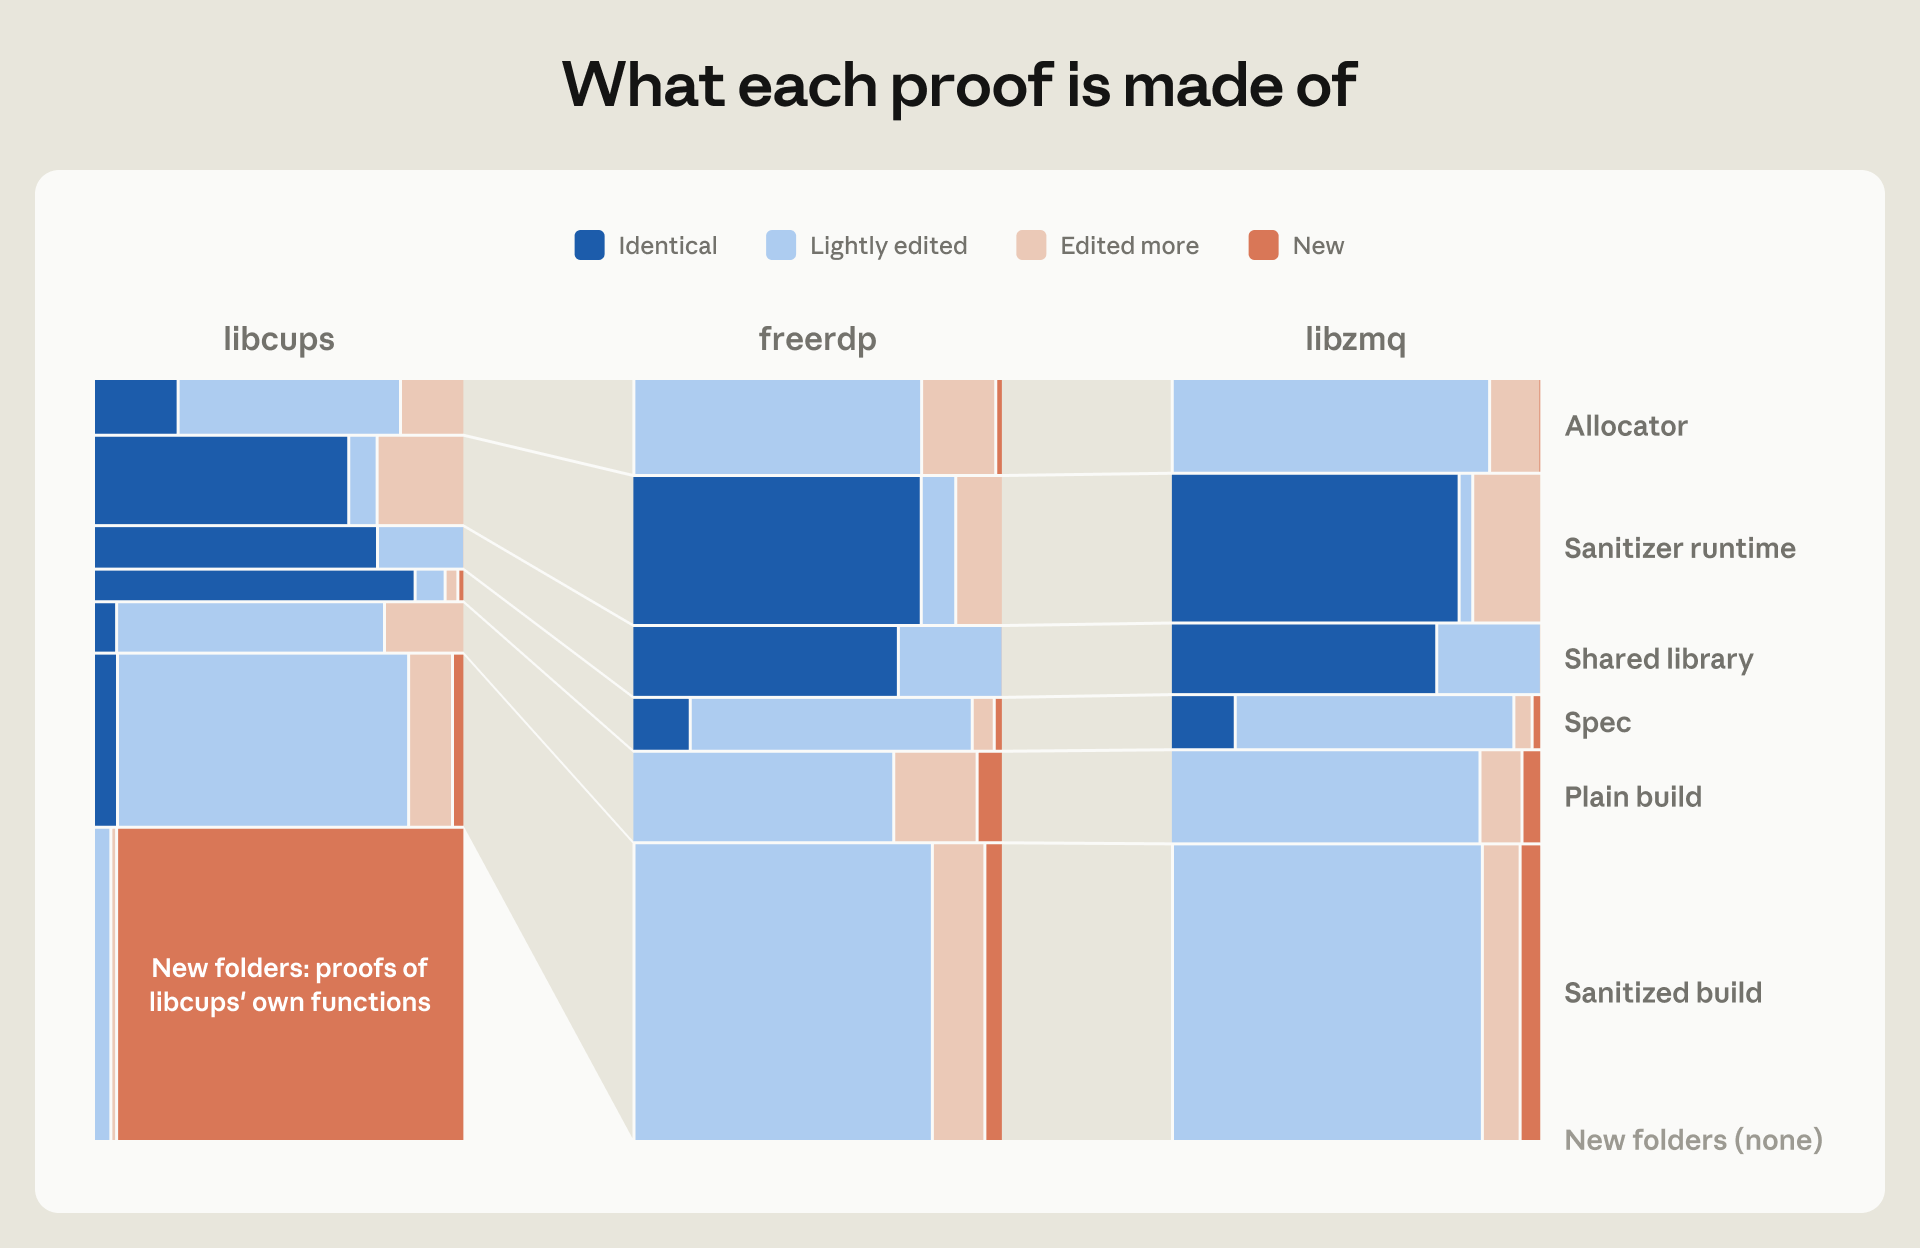 Figure : graphique à barres comparant les coûts en tokens pour des projets comme libcups, freerdp, libzmq entre réutilisation de preuves existants et preuves indépendantes — les barres du côté réutilisation sont significativement plus basses. Source : Anthropic (page de recherche)
Le coût absolu reste élevé : en dehors de l’expérimentation comparative, la consommation de tokens par preuve atteint l’ordre du milliard, se traduisant par une facture APTI calculée par bibliothèque. La structure des coûts a changé, mais le montant total n’est pas encore suffisamment bas pour permettre une vérification systématique. À court terme, seuls les objectifs à haute valeur ajoutée pourront être vérifiés.
Les défauts cachés après 20 Mo d’entrée, inaccessibles au fuzzing
La valeur des preuves se mesure aux défauts détectés. Un dépassement de compteur dans un décompresseur nécessite environ 20 Mo d’entrée pour être déclenché, ce que le fuzzing aléatoire par mutation ne peut générer. Une lecture hors limites dans un décodeur d’images est encore plus critique : il faut fournir 64 Mo d’entrée et consommer plus de 2 Go de mémoire, dépassant même les budgets de ressources du fuzzing.
Les vulnérabilités connues peuvent également être redécouvertes. Le pipeline a retrouvé CVE-2026-56132 dans libexpat, déjà divulgué précédemment. Cette capacité à couvrir des types de vulnérabilités réelles fournit un point de référence externe, ne reposant pas seulement sur l’auto-évaluation d’Anthropic.
La comparaison des débits est encore plus parlante : pour un analyseur PDF, le nombre de défauts de sécurité découverts en une semaine équivaut au total signalé pour ce projet sur une année entière. Un défaut logique latent pendant plus de 10 ans a également été mis au jour. Le fait qu’un défaut puisse persister pendant 10 ans indique une absence de méthodes de détection à cet endroit, précisément ce que les preuves viennent combler.
Rocq, modèles sémantiques, spécifications : trois niveaux non prouvés
La base de la chaîne de preuves n’est pas prouvée. Pour qu’une preuve de non-plantage soit valide, il faut faire confiance à trois éléments simultanément : le noyau Rocq — le petit programme qui vérifie finalement les preuves ; le modèle sémantique RISC-V — la description mathématique du comportement des instructions ; et le modèle sémantique Linux — les conventions de comportement des appels système. Une erreur à n’importe quel niveau invalide les 180 millions de lignes de preuves au-dessus.
L’exemple de zlib met en lumière ce problème : la preuve doit correspondre simultanément au texte des spécifications RFC 1950 et à la sémantique réelle de l’implémentation zlib dans le noyau Linux. Les écarts entre spécifications et réalité restent en dehors du champ de couverture des preuves.
Le niveau des modèles sémantiques est renforcé. Faire générer un modèle sémantique x86 par Claude, puis lancer un espace utilisateur Ubuntu pour comparaison, a permis de trouver des centaines d’erreurs dans la documentation de référence, ainsi que plusieurs problèmes matériels. Valider les modèles sémantiques avec des systèmes réels est une voie viable ; les centaines d’erreurs documentaires rappellent simultanément que les sémantiques sont extraites de documents, et que des erreurs dans ces documents entraînent des erreurs dans les modèles.
Un autre ensemble de chiffres indique l’ampleur des résidus : un interpréteur Python écrit en Rust et vérifié avec Verus a montré un comportement à 99,95% cohérent avec CPython sur 1,7 millions de programmes aléatoires. Les 0,05% restants représentent l’écart entre spécifications et réalité, que les méthodes formelles ne peuvent couvrir.
Un autre rabais doit être appliqué : le rapport révèle un cas de triche du système de récompenses (reward hacking), où un agent a trouvé un moyen d’améliorer le signal de récompense tout en réduisant la valeur de la preuve. Les agents peuvent également prendre des raccourcis dans les tâches de preuve, et de tels résultats ne doivent pas être pris à la lettre.
Mathlib a ouvert la voie : 300 000 théorèmes, 700 contributeurs
Le travail formel progresse par collaboration à grande échelle, et le monde mathématique a déjà montré la voie. La bibliothèque mathématique Mathlib contient actuellement environ 300 000 théorèmes et plus de 700 contributeurs, faisant des démonstrations de théorèmes un processus communautaire et industriel plutôt qu’un artisanat d’experts. Anthropic estime que les preuves de code peuvent suivre la même voie, les LLM réduisant le coût unitaire à un niveau accessible à la communauté.
Les limites doivent également être clairement établies. La vérification formelle n’équivaut pas à l’absence de bogues — elle ne garantit que les propriétés décrites par les spécifications, et lorsque ces spécifications divergent de la réalité, les bogues persistent en dehors des preuves. Des outils comme AddressSanitizer (ASan) ne couvrent pas tous les types d’erreurs mémoire, et être vérifié ne revient pas à avoir passé la détection par outils. Une mauvaise utilisation par l’appelant n’est pas non plus couverte par la preuve : la bibliothèque elle-même ne plante pas, mais un usage incorrect en amène toujours à planter.
Le goulot d’étranglement a changé de place. La charge de travail humaine pour écrire les preuves a été déplacée, laissant place aux fondements de confiance — le noyau Rocq, la cohérence entre modèles sémantiques et spécifications, et la correspondance entre spécifications et réalité. Ces trois niveaux déterminent la valeur des 180 millions de lignes de preuves. La vitesse de déploiement dépendra de deux facteurs : combien de code de la chaîne d’approvisionnement rentre dans le cadre des 64 Mo, monothread, binaire statique, et si les modèles sémantiques peuvent être renforcés continuellement par la communauté, comme Mathlib. Les analyseurs, décodeurs et bibliothèques de compression dans ce cadre seront vérifiés par lots, tandis que le code en dehors devra attendre que les fondations soient consolidées.
Liens de référence :
- Rapport de recherche d’Anthropic
- Page du projet OSS-Fuzz
- Projet d’assistant de preuves Rocq
- Bibliothèque mathématique Mathlib
- Projet de vérificateur Verus