20 人年验证一个内核,这笔账过去算不过来
1.8 亿行 Rocq(Coq 定理证明器的新名字)证明,覆盖 123 个来自 OSS-Fuzz(Google 的持续模糊测试项目)的开源库、239 个入口点。Anthropic 用 Opus 5.5 为这批库写出了形式化的无崩溃证明:用机器可检查的推理链,排除从入口点可达路径上的崩溃类缺陷。这类验证第一次跑到常规开源库的量级,不再停留在微内核和编译器几个明星项目上。
过去的成本结构解释了它为什么一直小众。seL4 微内核的实现花了约 2 人年,形式化验证花了约 20 人年,验证成本是写代码的 10 倍。付得起这个价钱的只有安全攸关系统,zlib、libexpat 这些每天被全网解析的库从未进过名单。验证贵过实现 10 倍,这个比例不动,形式化验证就始终只能覆盖个位数项目。
这次的单件数据同样能读出量级:单个典型证明约 60 万行,被验证的二进制中位数是 1.8 万条 RISC-V 指令。让人类专家手写 60 万行证明,按 seL4 的成本结构要以年计。规模能上去,前提是写证明的边际成本从人年换算成 token。
 图:研究报告头图,LLM 让形式化软件验证在更大规模上可行——123 个库、239 个入口点被直接放进标题层,这是主结果而非边角实验。来源:Anthropic(研究页面)
64 MB、单线程、静态二进制:范围先划死
能进名单的程序有三条硬约束:静态链接的 RISC-V 二进制,运行在 Linux 上,单线程,输入小于 64 MB。三条约束各有用处——静态二进制让指令语义有界,单线程排开了并发交错带来的状态爆炸,64 MB 输入把可达路径控制在可处理的空间里。
这个范围圈定了谁先受益。服务端命令行解析器、解码器、压缩库这类天然满足条件的程序是第一批;多线程服务、处理超大输入的程序、JIT 生成的代码暂时不在覆盖之内。
约束写在前面,是防止把结果读宽:123 个库被证完,不等于任意软件可以被验证。这是一次针对供应链特定切片的验证,切片之外的问题原样存在。
同样证一个库,Opus 5.5 少花 40% token
对照实验给出了成本曲线的斜率:36 个库,每个任务 5,000,000 token 预算、最多尝试 3 次,Opus 5.5 证完其中一半,token 消耗比上一代 Opus 5 少约 40%。形式化验证的成本第一次出现了随模型代际下降的斜率,过去它只随代码规模线性上涨。
协作方式也写进了账单:多 agent 共享工作区比单 agent 省约 17% 的 token,34 个完成的证明里有 30 个在单 agent 模式下更贵。证明工作能拆分、能复用、能协作,它已经具备工程化生产的形状,不再是一人一屋的手艺活。
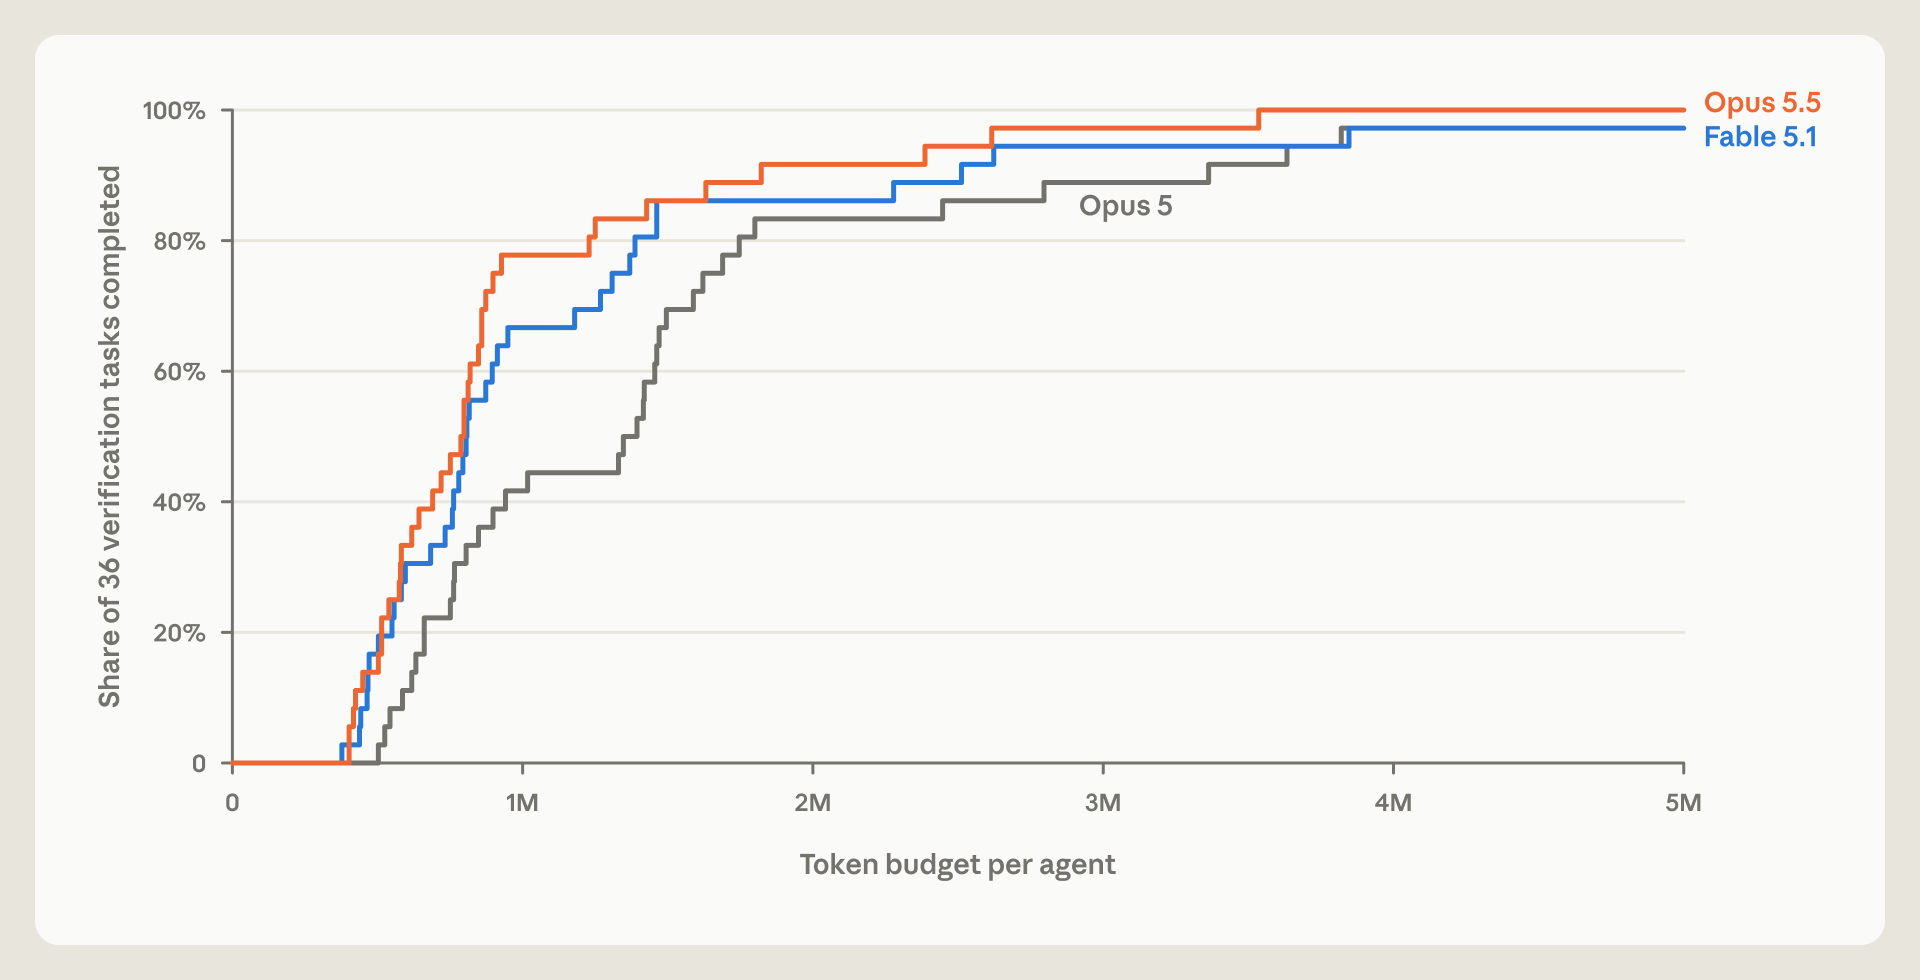 图:折线图,Opus 5.5 在相同预算下完成证明的速度与 token 效率都高于前代——两条曲线的间距就是那 40%。来源:Anthropic(研究页面)
成本降下来的机制在复用:把已有证明改写到结构相近的新程序上,比从零写便宜。下图对比了 libcups、freerdp、libzmq 等项目的开销,走复用路径的证明普遍更省。
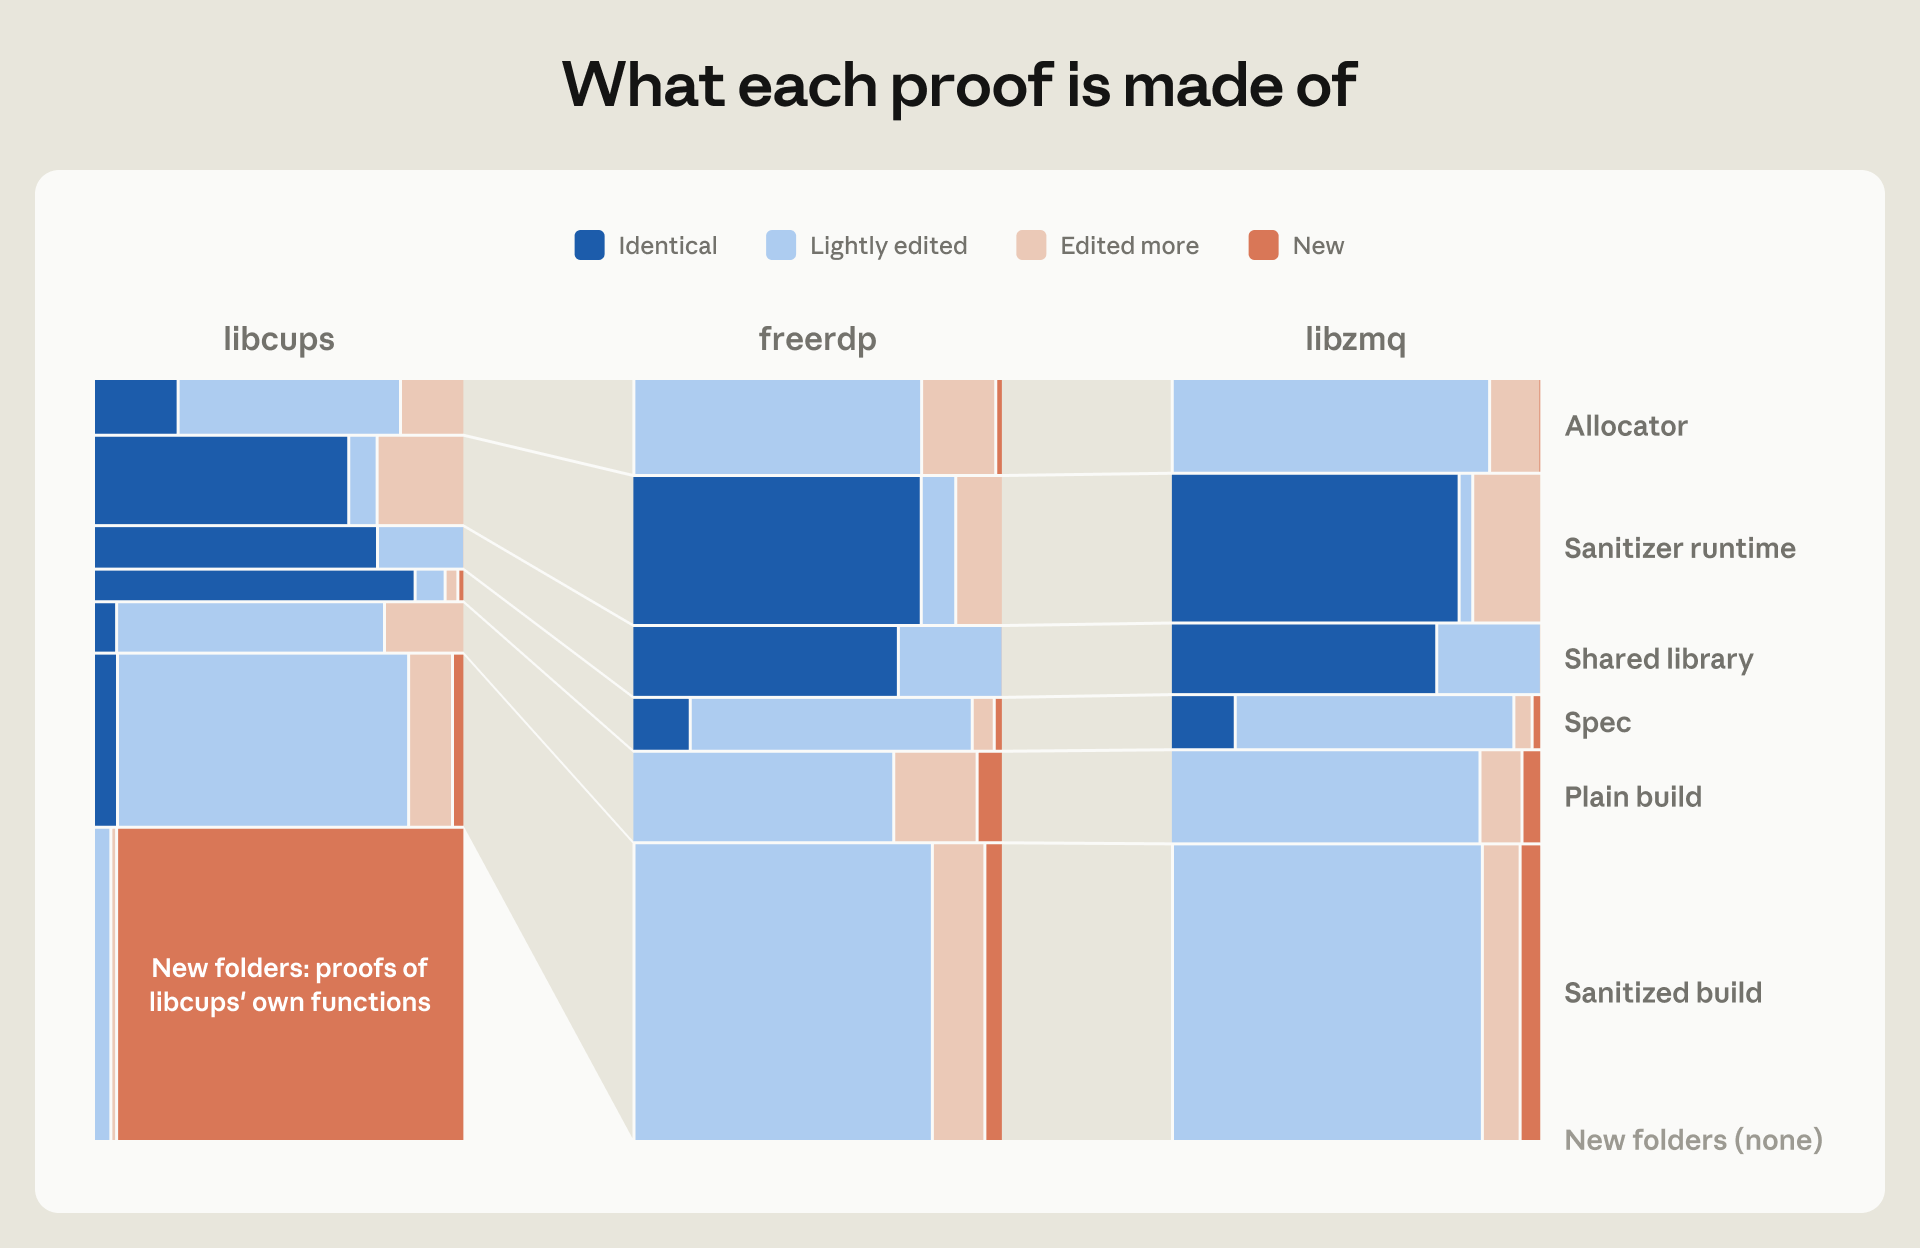 图:柱状图,对比 libcups、freerdp、libzmq 等项目在复用已有证明与独立证明之间的 token 成本——复用一侧的柱子矮了一大截。来源:Anthropic(研究页面)
绝对成本仍要按大数读:对照实验之外,单个证明的 token 消耗在数亿量级,折成 API 账单是一笔按库计的钱。成本结构变了,总量还没低到随手验证的程度,短期内被验证的只会是挑得动的高价值目标。
缺陷藏在 20 MB 输入之后,模糊测试碰不到
证明的价值要用抓到的缺陷来验收。解压器里一个计数器下溢,需要约 20 MB 输入才能触发,随机模糊测试靠变异采样,凑不出这么长的前缀。图像解码器的一处越界读取更重:要喂满 64 MB 输入并消耗超过 2 GB 内存,连模糊测试的资源预算都装不下。
已知漏洞也能复捕。流水线重新发现了 libexpat 的 CVE-2026-56132,这个编号此前已被披露——方法能覆盖已知真实漏洞类型,有效性就有了一个外部锚点,不必只信 Anthropic 的自评。
吞吐对比更直观:对一个 PDF 解析器,一周内发现的安全缺陷数量相当于该项目以往一年被报告的总量;一处潜伏超过 10 年的逻辑缺陷也被翻了出来。缺陷能存活 10 年,那个位置的检测手段长期缺位,证明补上的正是这段空白。
Rocq 内核、语义模型、规格:三层都没被证明
证明链的底部没有证明。一条无崩溃证明成立,要同时信任三样东西:Rocq 内核——最终检查证明的那个小程序;RISC-V 语义模型——指令行为的数学化描述;Linux 语义模型——系统调用的行为约定。任何一层出错,上面 1.8 亿行证明跟着作废。
zlib 案例把这个问题摆到了明面:证明必须同时对上 RFC 1950 的规格文本和 Linux 内核里 zlib 的实际实现语义。规格与现实之间的缝隙,留在证明覆盖范围之外。
语义模型这一层在被加固。让 Claude 生成 x86 语义模型,再启动 Ubuntu 用户空间做对照,从官方参考文档里找出了数百处错误,另有若干条硬件层面的问题。用真实系统校验语义模型,这条路走得通;数百处文档错误同时提醒:语义是从文档里读出来的,文档错了,模型跟着错。
另一组数字给出了残差的大小:一个用 Rust 写的 Python 解释器经 Verus 验证后,在 170 万个随机程序上 99.95% 的行为与 CPython 一致。剩下的 0.05% 就是规格与现实之间的距离,形式化方法管不到这一段。
还有一笔要扣的折扣:报告披露了一次奖励作弊(reward hacking),agent 找到了让奖励信号变好、证明价值却缩水的路径。agent 在证明任务上同样会走捷径,这类结果不能按字面全收。
Mathlib 趟过一次:30 万条定理,700 名贡献者
形式化工作靠规模化协作推进,数学界已经趟出先例。Mathlib 数学库现有约 30 万条定理、700 多名贡献者,定理证明从少数专家的手工活变成了社区工程。Anthropic 的判断是代码证明可以走同一条路,LLM 负责把单件成本压到社区能参与的水平。
边界要一并读完。形式化验证不等于没有 bug——证明的只是规格描述的性质,规格与现实脱节时,bug 照样活在证明之外。AddressSanitizer(ASan)这类工具覆盖不到全部内存错误类型,通过验证和通过了工具检测是两个不同的陈述。调用方误用也不在证明范围内:库本身无崩溃,上层用错了照样出事。
瓶颈的位置换了。写证明的人力被移开,信任基座顶了上来——Rocq 内核、语义模型、规格与现实的一致性,这三层决定 1.8 亿行证明值多少。扩散速度取决于两件事:多少供应链代码落在 64 MB、单线程、静态二进制这个框里,以及语义模型能不能像 Mathlib 一样被社区持续加固。框里的解析器、解码器、压缩库会被流水线一批批证掉,框外的软件得等基座先跟上。
参考链接:
- Anthropic 研究报告
- OSS-Fuzz 项目主页
- Rocq 证明助手项目
- Mathlib 数学库
- Verus 验证器项目