Am 30. Oktober 2026 hat das europäische KI-Unternehmen Mistral die Gewichte seines Flaggschiffmodells Mistral Large 4 unter dem Codenamen „Le Chonk“ als Open Source freigegeben. Mit insgesamt 1,05 Billionen Parametern basiert das Modell auf einer Sparse Mixture-of-Experts (MoE)-Architektur und wurde von Grund auf in Europa vortrainiert. Es unterstützt nativ multimodales Verständnis für Bilder, Dokumente und Code und reiht sich damit nahtlos in die Spitzenklasse frei verfügbarer Modellgewichte ein.
Im Coding Agent Index von Artificial Analysis erzielte Le Chonk 48 % und zog damit praktisch mit dem quelloffenen Vergleichsmodell GLM-5.3 gleich. Die telemetrischen Messungen brachten jedoch ein überraschendes Ergebnis zutage: Bei der Bewältigung identischer Softwareaufgaben verbrauchte das Modell im Schnitt 47 % weniger Ausgabe-Tokens. Mistral bezeichnet dieses Effizienzfenster als den „Sweet Spot“ der Modellinferenz.
Der Fokus der LLM-Entwicklung verschiebt sich zusehends von isolierten Benchmark-Ranglisten hin zu den tatsächlichen Inferenzkosten unter realer Auslastung. Wenn sich die Erfolgsquoten verschiedener Modelle kaum noch unterscheiden, entscheiden interaktiver Durchsatz und VRAM-Bedarf über die Praxistauglichkeit. Diese Veröffentlichung belegt, dass Open-Source-Systeme bei der Rechenkostenstruktur auf Augenhöhe mit proprietären Spitzenmodellen konkurrieren können.
Gleichstand bei Spitzen-Benchmarks, 47 % weniger Token-Verbrauch pro Aufgabe
Sobald autonome Agenten in produktive Pipelines integriert werden, entwickeln sich lange Kontexte und mehrstufiges Schließen zu den wesentlichen Kostentreibern. Im Coding Agent Index erreicht Le Chonk mit 48 % das Niveau von GLM-5.3. Der entscheidende Unterschied liegt jedoch im Ressourcenverbrauch: Eine Reduktion des Token-Verbrauchs um 47 % halbiert die Inferenzkosten für langlebige Workflows nahezu.
Wie Mistral berichtet, erzielte Le Chonk im Benchmark FrontierCode 2.0 von Cognition – dessen Bewertungskriterium darin besteht, ob Repository-Maintainer vorgeschlagene Code-Änderungen tatsächlich mergen – eine Merge-Rate von 19,7 % und lag damit vor GLM-5.3 mit 19,3 %. Zeitgleich erreichten Kimi K3 17,8 % und GLM-5.3 Flash 17,3 %, während Beam 1.0 bei 14,2 % und DeepSeek V4.1 Flash bei 2,9 % lagen.
Dieser leichte Vorsprung bei der Merge-Quote spiegelt eine höhere Stringenz und Konformität zu Softwarestandards wider. Automatisierter Code wird von Maintainern häufig wegen überflüssiger Kommentare oder fragiler Tests abgelehnt. Dass Le Chonk seine Erfolgsquote trotz einer Reduktion des Outputs um fast die Hälfte behaupten konnte, zeigt, dass das Modell unnötige iterative Fehlversuche und Over-Engineering wirksam unterdrückt.
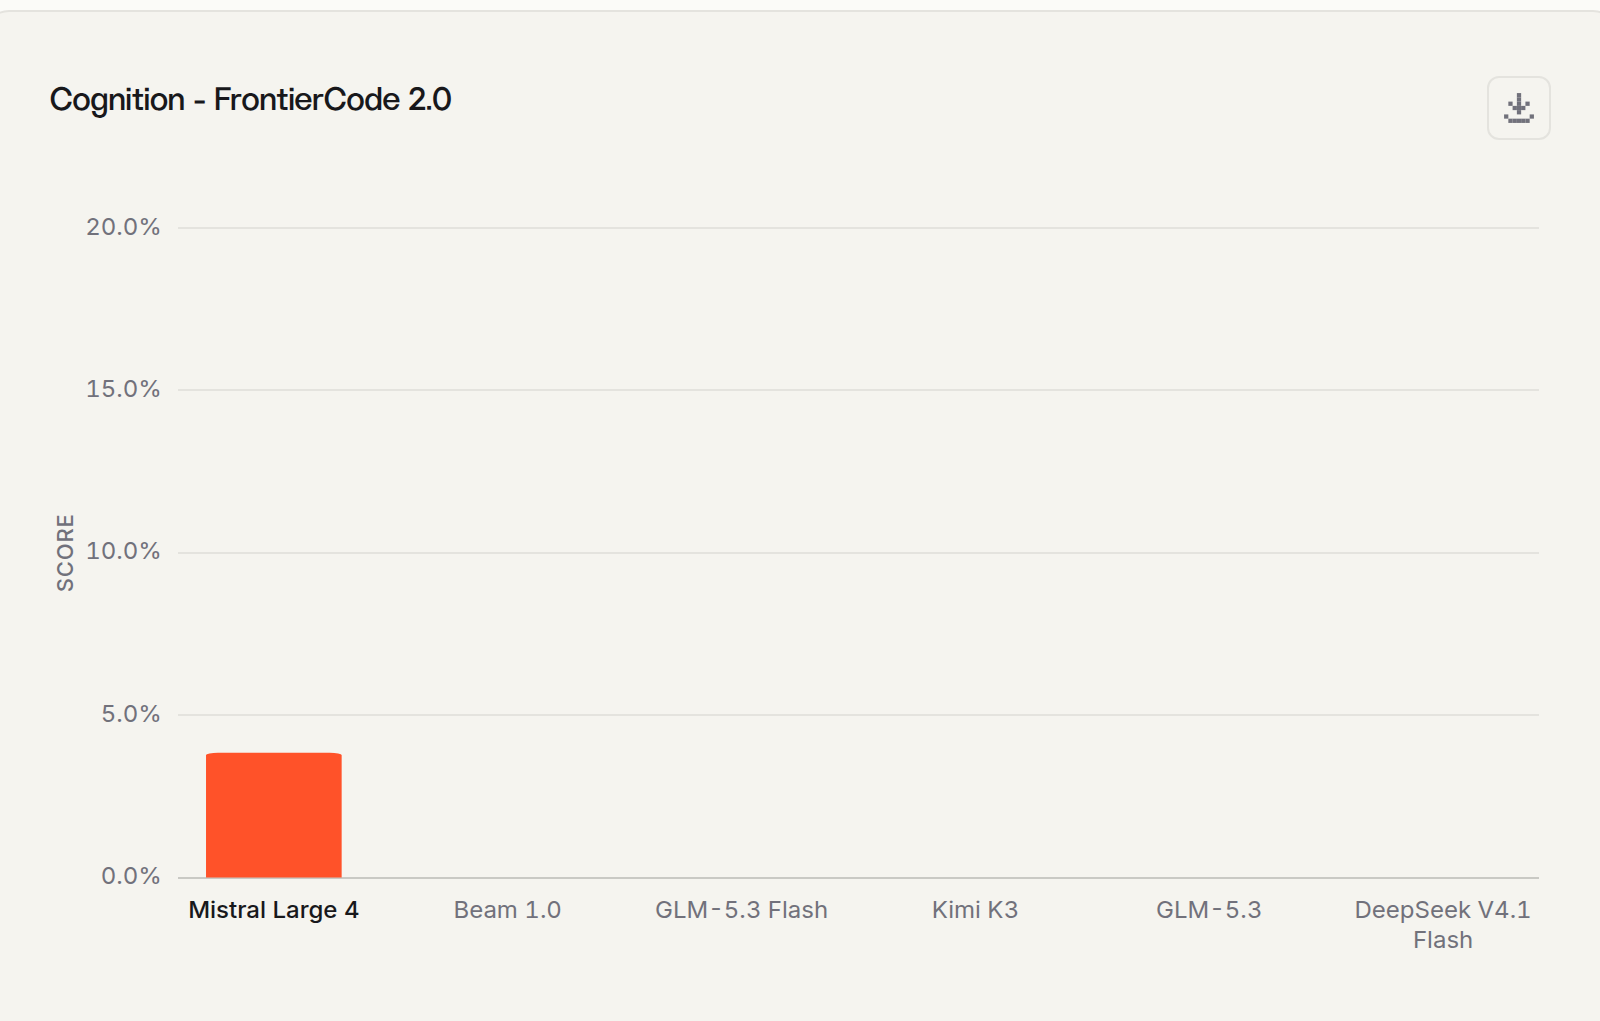 Abb.: Vergleich der Ergebnisse im FrontierCode 2.0 Benchmark basierend auf tatsächlichen Merges durch Repository-Maintainer. Auffällig ist die Streuung der Modelle unter strengen Engineering-Standards. Quelle: Offizieller Mistral-Blog.
Drei Wochen zusätzliches Reinforcement Learning straffen Terminal-Aufgaben
Die deutliche Straffung der Ausgabelänge ist das Ergebnis einer gezielten Post-Training-Optimierung. Mistral ergänzte das vortrainierte Basismodell um drei Wochen zusätzliches Reinforcement Learning (RL), das primär darauf ausgelegt war, die Aktionsschritte der Agenten zu komprimieren. Im Terminal-Bench 4.0, der Kommandozeilenaufgaben evaluiert, erzielte Le Chonk eine Erfolgsquote von 41 % – ein Zuwachs von satten 13 Prozentpunkten im Vergleich zur vorherigen Preview.
Während die Erfolgsquote stieg, schrumpfte das Ausgabevolumen: Bei Terminal-Aufgaben benötigte das Modell 30 % weniger Tokens. Mistral erklärte in der Ankündigung, dass die Zugewinne durch RL weiterhin anhalten und keine Anzeichen einer Sättigung zeigen. Speziell auf interaktive Umgebungen abgestimmte Belohnungsmodelle eliminierten weitschweifige Füllwörter effektiv.
Um unterschiedlichen Hardware-Budgets gerecht zu werden, bietet das Modell drei Inferenzstufen: Low, Medium und High. Die standardmäßig aktivierte Stufe High ist für tiefgreifendes, langes logisches Schließen gedacht, während Low den bisherigen Modus ohne Reasoning ablöst. Durch diese Staffelung wird die Denktiefe zu einem steuerbaren Parameter. Bei unkritischen Debugging-Aufgaben muss keine aufwendige Chain-of-Thought geladen werden, was bei hoher Parallelität wertvollen VRAM einspart.
96 % Abwehrrate bei böswilligen Anfragen: Sicherheitsarchitektur für Enterprise-Workflows
Die Robustheit an den Sicherheitsgrenzen eines Modells entscheidet maßgeblich über die Hürden für einen Einsatz im Unternehmensumfeld. Unter dem Slogan „Built for Coders, Trusted by Defenders“ erreichte Le Chonk eine durchschnittliche Verweigerungsrate von 96,6 % bei böswilligen Netzwerkanfragen. Mistral betont, dass dieser Wert die Spitze unter den Open-Weight-Modellen markiert, ohne legitime Sicherheits- und Verteidigungsaufgaben vorschnell zu blockieren.
Im Cyber Index von Artificial Analysis erzielte Le Chonk 51 %. Im selben Test erreichten DeepSeek-V4.1-Flash 57 % und MiMo-V2.6-Pro 56 %. Im doppelblinden menschlichen Präferenztest Surge Code musste sich das Modell hingegen nur Claude Opus 5.5 geschlagen geben und übertraf sämtliche quelloffenen Mitbewerber im Blindtest.
Die Diskrepanz zwischen hoher Ablehnungsrate und dem Sicherheitsindex verdeutlicht das Dilemma moderner Sicherheitsabstimmungen. Eine Blockaderate von 96,6 % unterbindet die Generierung automatisierter Exploit-Skripte zuverlässig und erfüllt Compliance-Vorgaben. Bei der tiefergehenden Schwachstellenanalyse und im adversarialen Testen schränken rigide Leitplanken jedoch den logischen Spielraum ein. Die praktische Feinabstimmung bewegt sich im Spannungsfeld zwischen Angriffsschutz und explorativer Analysetiefe.
1 Billion Parameter on-premise: Europäische Rechensouveränität auf dem Prüfstand
Le Chonk umfasst insgesamt 1,05 Billionen Parameter und arbeitet nach dem Sparse Mixture-of-Experts-Prinzip. Da pro Vorwärtspass nur ein Teil der Parameter aktiviert wird, lässt sich ein Modell dieser Dimension auf spezialisierten Rechenclustern betreiben. Mistral hebt hervor, dass das Training vollständig auf europäischem Boden stattfand – ein Meilenstein für die technologische Autonomie Europas im Bereich generativer KI.
Die Modellgewichte stehen auf Hugging Face bereit und unterstützen das Self-Hosting via vLLM oder SGLang. Model Cards und Lizenzbestimmungen wurden zeitgleich veröffentlicht; ein ausführlicher technischer Bericht soll in Kürze folgen. Durch den lokalen Betrieb verhindern Unternehmen, dass sensibler Quellcode und interne Geschäftslogik an externe Cloud-Anbieter übermittelt werden.
Zu den offiziellen Technologiepartnern zählen NVIDIA, Cisco, Cloudflare und CrowdStrike. Auf europäischer Seite finden sich ASML, Orange Cyberdefense, Crédit Agricole sowie die Europäische Weltraumorganisation (ESA). Die Beteiligung von Industrie- und Raumfahrtakteuren unterstreicht den dringenden Bedarf regulierter Branchen an souveräner Kontrolle über die eigene KI-Infrastruktur.
Allerdings muss die Vision technologischer Unabhängigkeit dem physikalischen Kostenfaktor im Rechenzentrum standhalten. Selbst bei spärlicher Aktivierung wiegen 1,05 Billionen Parameter mehrere hundert Gigabyte. Der Speicher- und VRAM-Transfer bleibt ein realer Kostenfaktor. Hochgeschwindigkeitsnetzwerke und der enorme Strombedarf eigener Cluster stellen hohe Anforderungen an die Infrastruktur. Unternehmen müssen die Balance zwischen Hardware-Investitionen und langfristigen Betriebskosten präzise kalkulieren.
 Abb.: Von Mistral vorgestellte Partnerorganisationen aus Halbleiterfertigung, Cybersicherheit und europäischer Luft- und Raumfahrt. Quelle: Offizieller Mistral-Blog.
Nach dem Plateau der Benchmarks: Inferenzkosten sichern das Überleben von Open Source
Der Wettbewerb im Open-Source-Segment erreicht einen Wendepunkt. Während frühe Phasen von wachsenden Datenmengen und Rekordwerten in Benchmarks geprägt waren, rückt nun das Budget für den Dauerbetrieb in den Mittelpunkt. Wenn Spitzenmodelle bei den Erfolgsquoten kaum noch voneinander abweichen, entscheidet der Token-Aufwand pro Arbeitsergebnis darüber, ob ein produktiver Einsatz dauerhaft finanzierbar bleibt.
Le Chonk weist hier einen pragmatischen Weg: Identische Code-Qualität bei fast halbiertem Token-Verbrauch entlastet die Hardware-Ressourcen spürbar. Unternehmen verlangen Kontrolle und Unabhängigkeit, benötigen aber zugleich tragbare Betriebskosten. Erst die Kombination aus erstklassiger Leistungsfähigkeit und hoher Energieeffizienz verschafft offenen Modellgewichten das dauerhafte Ticket für die produktive Softwareentwicklung.
 Abb.: Das offizielle Maskottchen „Le Chonk“, das Mistral für dieses Flaggschiffmodell gewählt hat. Quelle: mistral.ai.
参考链接:
- Mistral 官方博客:Mistral Large 4 开源权重发布说明
- Mistral 官方博客:Mistral Large 4 模型架构与基准评测
- Hugging Face 官方权重仓库:Mistral-Large-4-1T-A52B