Ein handtellergroßes Mikrocontroller-Board arbeitet völlig autark ohne externe Spiele-Engine oder Server. Direkt auf dem Chip berechnet es die Kausalketten einer physikalischen Spielwelt. Im Open-Source-Projekt tinyworldformer übernimmt ein Raspberry Pi Pico 2 W den gesamten Vorhersage- und Entscheidungszyklus. Auf diesem Chip mit lediglich 520 KB SRAM laufen simultan ein rekurrenter Transformer zur Bildgenerierung und ein neuronales Netz für Steuerungsaktionen.
Bisher waren Weltmodelle an energiehungrige Cloud-Cluster mit Milliarden von Parametern gebunden. tinyworldformer schlägt einen radikal leichtgewichtigen Pfad ein: Die Netzwerke wurden auf 26k bis 131k Parameter komprimiert, wodurch die Rechenlast pro Frame auf 2 bis 8 Millionen MACs sinkt. Fünf klassische Spielumgebungen finden so vollständig in 4 MB Flash und 520 KB SRAM Platz.
Das Reinforcement-Learning-Training findet ausnahmslos innerhalb der vom Modell generierten Vorhersage-Frames statt. Der Agent interagiert zu keinem Zeitpunkt mit der nativen Spiele-Engine. Diese durchgängige neuronale Simulation eliminiert jegliche Cloud-Kosten und bringt Weltmodelle sowie bestärkendes Lernen direkt auf Mikrocontroller. Der Preis dafür liegt in einer reduzierten visuellen Auflösung und Frame-Genauigkeiten zwischen 83,6 % und 100 %, spart dafür jedoch sämtliche externe Rechenressourcen ein.
Zwei spiegelbildliche Netze: Kein echtes Spiel auf dem Mikrocontroller
Der im Pico 2 W verbaute RP2350 verfügt über zwei Cortex-M33-Kerne. Das System trennt die Display-Ausgabe und die Kausalinferenz strikt auf Hardware-Ebene. Core 0 ist für die USB-Kommunikation und Bildschirmansteuerung zuständig. Core 1 führt unabhängig davon zwei spiegelbildliche neuronale Netze aus – gänzlich ohne echte Spiele-Engine.
Das Weltmodell übernimmt die Simulation der Umgebung. Es empfängt den aktuellen Frame sowie die gewählte Aktion und gibt den nächsten Frame samt Belohnung vorher. Seine Architektur basiert auf einem in int8 quantisierten rekurrenten Transformer mit 26k bis 131k Parametern. Pro Frame werden 2M bis 8M Multiplikations-Akkumulations-Operationen (bei Pac-Man lite bis zu 8,2M MACs) fällig, was sicherstellt, dass die On-Chip-Inferenz mit der Regelschleife Schritt hält.
Der Akteur analysiert den visuellen Zustand und trifft Entscheidungen. Er ist als zweilagiges float32-MLP mit lediglich 9k bis 16k Parametern implementiert und benötigt pro Frame nur 9k bis 16k MACs – eine minimale Rechenlast. Der Akteur liest ausschließlich die vorhergesagten Features des Weltmodells, während das Weltmodell umgekehrt nur die diskreten Aktionen des Akteurs empfängt.
Dieses Doppelnetzwerk-System ermöglicht flexible Kontrollübernahmen durch den Menschen. Der vortrainierte Onboard-Akteur kann nahtlos gegen einen stream-x-Agenten ausgetauscht werden, der bei null beginnt. Sobald der Entwickler eine Taste auf dem Board drückt, wechselt die Kontrolle sofort zum menschlichen Spieler. Wer die Tasten bedient, interagiert dabei ebenfalls ausschließlich mit den in Echtzeit vom neuronalen Netz halluzinierten Bildern.
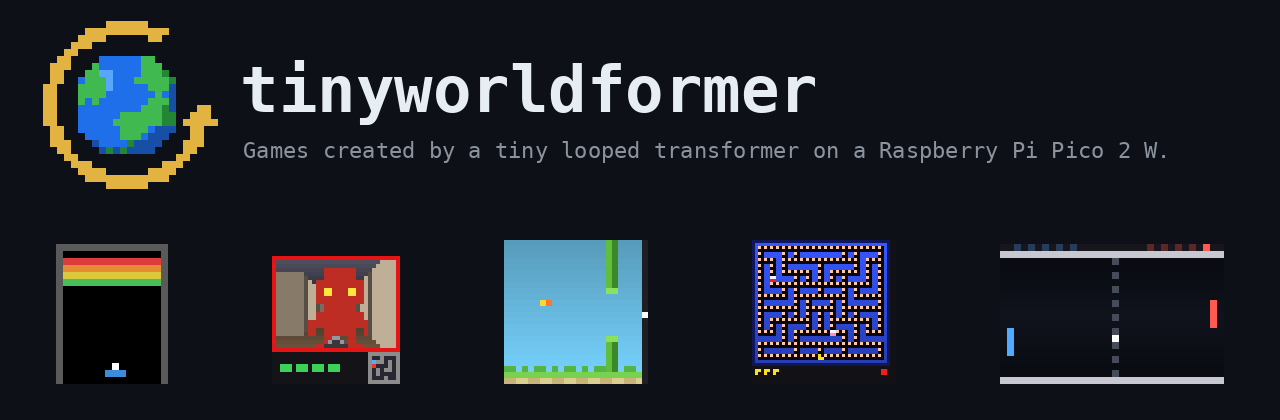 Abbildung: tinyworldformer Architektur und Übersicht über die beiden auf dem Mikrocontroller laufenden neuronalen Netze. Quelle: SheepSeb/tinyworldformer.
Rekurrente Gewichtswiederverwendung: Latenz gegen Speicherplatz
Klassische Vision-Transformer stapeln mehrere Schichten, um Modellkapazität zu gewinnen. Im SRAM eines Mikrocontrollers ist für mehrere Schichtgewichte jedoch kein Platz. tinyworldformer setzt stattdessen auf eine rekurrente Transformer-Architektur und behält global nur einen einzigen Transformer-Block. Dessen Gewichte werden 1- bis 4-mal sequenziell wiederverwendet, wobei vor jedem Durchlauf das ursprüngliche Eingangsresiduum wieder aufaddiert wird.
Beim Training werden die Zwischenergebnisse jedes rekurrenten Durchlaufs per überwachter Regression an den echten Folge-Frame angepasst. Zur Laufzeit wird die Schleifenanzahl so zu einem variablen Regler, mit dem Rechenlatenz gegen Inferenzgenauigkeit abgewogen werden kann. Um auf der Pico 2 W Hardware interaktive Bildraten zu sichern, nutzt das System standardmäßig 2 Durchläufe. Das Design überlässt die effektive Netzwerktiefe somit der Edge-Ausführungsumgebung.
Am Beispiel eines isolierten Tests von Doom-lite zeigt sich der dämpfende Effekt der Rekursion auf Halluzinationen deutlich: Bei einem einzelnen Durchlauf halluziniert das Modell einen nicht existierenden Gegner und erzeugt 92 fehlerhafte Rasterzellen. Bei 2 Durchläufen sinkt dieser Fehler auf 35 Zellen, bei 3 Durchläufen auf 12 und nach 4 Durchläufen sind sämtliche Fehler eliminiert.
Das Projekt evaluierte 5 Spiele bei 2 Durchläufen. Breakout (20×16 Raster) erzielt mit 26k Parametern und 4,3M MACs eine Genauigkeit von 99,99 % pro Frame. Flappy Bird (24×24 Raster) erreicht mit 46k Parametern und 2,0M MACs exakt 100 %. Pong (20×32 Raster) verzeichnet mit 46k Parametern und 2,3M MACs 99,45 % Genauigkeit und modelliert deterministische 2D-Physik hochpräzise.
Umgebungen mit tiefgehender Zustandsverfolgung und Pseudo-3D-Rendering stoßen hingegen an die Kapazitätsgrenzen. Pac-Man lite bildet in einem 48×48-Raster ein komplexes Labyrinth mit zwei Geistern ab, was 131k Parameter und 8,2M MACs erfordert (86,4 % Genauigkeit). Doom-lite nutzt eine 32×32-Egoperspektive in einem 8×8-Labyrinth und beansprucht 55k Parameter bei 4,2M MACs (83,6 % Genauigkeit). Bei multiplen verdeckten Entitätszuständen müssen Modelle mit geringer Parameterzahl lokale Darstellungsfehler in Kauf nehmen.
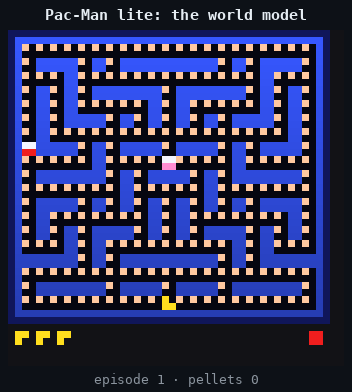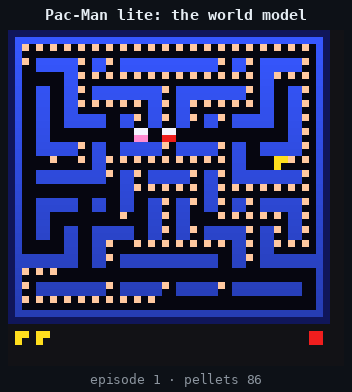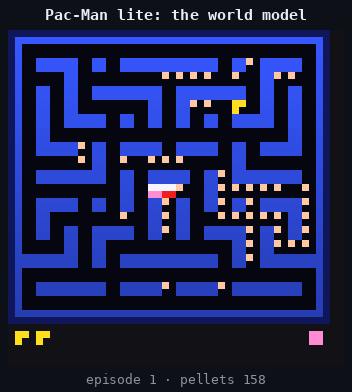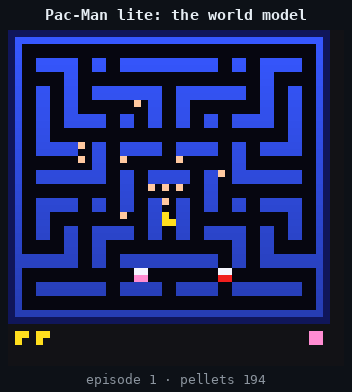 Abbildung: Autonom vom Weltmodell generierte Pac-Man-Vorhersage-Frames ohne Beteiligung einer nativen Spiele-Engine. Quelle: SheepSeb/tinyworldformer.
Heuristische Dekodierung gegen Halluzinationen: Regeln für Wahrscheinlichkeitsverteilungen
Ließe man leichtgewichtige neuronale Netze ungefiltert aus Softmax-Verteilungen sampeln, würde die simulierte Welt binnen weniger Zeitschritte zusammenbrechen: Pac-Man würde Klone bilden und abprallende Bälle sich in Luft auflösen. Die Dekodierung bildet ein zentrales Element, da Wahrscheinlichkeitsverteilungen nicht von allein gültige Spielzustände erzeugen.
Die erste Regel steuert statische Hintergründe: Kacheln wie Wände, Steine, Punkte und Böden wählen unabhängig das Token mit der höchsten Wahrscheinlichkeit (argmax). Diese isolierte Bestimmung vermeidet teure Graphsuchverfahren und fixiert die Labyrinthgrenzen zuverlässig.
Die zweite Regel verwaltet Singleton-Objekte: Entitäten wie Spielbälle oder Spielfiguren dürfen über das gesamte Raster und alle Klassen hinweg nur genau einmal vergeben werden. Dadurch wird ihre globale Einzigartigkeit physikalisch erzwungen. Bei stochastischen Ereignissen wie Respawns tastet der Dekodierer innerhalb eines 2,2-Logits-Radius um das Maximum ab, was dynamische Vielfalt sichert und Unschärfereste eliminiert.
Die dritte Regel betrifft animierte Sprites, die 2×2-Kacheln belegen. Bei Pac-Man oder Geistern trägt nur die Basiskachel den Zustandsvektor (z. B. Blickrichtung oder Überdeckung von Punkten). Die restlichen drei Kacheln werden nach festen Schablonen gestempelt. Das spart pixelweise Vorhersagen und schließt Zerreißeffekte bei Spielfiguren aus.
Durchgehende int8-Quantisierung: Zwei MACs pro SIMD-Befehl
Die größte Hürde für Transformer auf Mikrocontrollern ist der Energiebedarf von Gleitkomma-Matrixmultiplikationen. tinyworldformer quantisiert sämtliche Gewichtsmatrizen des Weltmodells in int8-Ganzzahlen. Das Netzwerk berechnet Skalierungsfaktoren zeilenweise pro Matrixausgabe (scale = max|w| / 127). Die Aktivierungstensoren werden ebenfalls in int8 quantisiert und erhalten je nach Tensorzugehörigkeit und Durchlauf eigene Skalierungsfaktoren.
Der Cortex-M33 des RP2350 bietet native Beschleunigungsbefehle für Ganzzahlarithmetik. Ein 32-Bit-Speicherzugriff lädt vier Gewichte, SXTB16 teilt die Bytes in zwei 16-Bit-Paare auf und SMLAD führt mit einem einzigen Taktzyklus zwei Multiplikations-Akkumulationen in ein 32-Bit-Register aus (Attention-Mechanismen nutzen UXTB16 für uint8-Wahrscheinlichkeiten × int8-Werte). Erst nach der int32-Akkumulation wird eine Gleitkomma-Reskalierung mit den Skalierungsfaktoren vorgenommen. Zusammen mit einer vorberechneten 1024-Elemente-Tabelle für uint8-Softmax entfallen aufwendige kontinuierliche Gleitkommaberechnungen.
Die Hardware-FPU des RP2350 bleibt dennoch aktiv: LayerNorm, Residuen-Additionen und Eingangs-Embeddings verbleiben in float32. Diese Schritte machen nur einen winzigen Bruchteil der Gesamtrechenlast aus. Das Festhalten an Gleitkommazahlen verhindert kumulative Rundungsfehler in tiefen Schichten und vereint Festkommabeschleunigung mit numerischer Stabilität.
Die hohe Reproduzierbarkeit basiert auf einer exakten Angleichung von Training und Ausführung: Bereits beim Training werden per Quantization-Aware Training (QAT) und Straight-Through-Estimator (STE) identische Ganzzahlrundungen angewandt. Das Export-Modul rustexport/intref.py friert die NumPy-Rechenreihenfolge fest ein. Die Rust-Inferenz-Engine auf dem Mikrocontroller bildet die Referenz bitgenau nach und schließt numerische Abweichungen zwischen Plattformen aus.
 Abbildung: Zeilenweises und durchlaufabhängiges int8-Quantisierungsschema für Matrizen und Aktivierungen. Quelle: SheepSeb/tinyworldformer.
Null Heap-Allokationen: 520 KB SRAM für Edge-Simulationen
Eingebettete Systeme verzeihen keine Speicherüberläufe. Die ELF-Analyse via size -A zeigt: Breakout belegt 361 KB Flash und 299 KB RAM, Flappy Bird 409 KB und 227 KB, Pong 414 KB und 244 KB. Doom-lite benötigt 471 KB und 357 KB, während Pac-Man lite 600 KB Flash und 460 KB RAM beansprucht. Alle Builds passen vollständig in die 4 MB Flash und 520 KB SRAM des Pico 2 W.
Die Speicheranalyse offenbart ein überraschendes Detail: Im gesamten Weltmodell machen die quantisierten int8-Gewichte lediglich 19,7 KB bis 33,9 KB aus. Die float32-Embeddings, Normalisierungsparameter und Skalierungsarrays binden dagegen 31,6 KB bis 91,9 KB. Der größte Teil des Speicherbedarfs entfällt somit auf die Anpassungsschichten der Peripherie und nicht auf den kompakten Rechenkern.
Um dauerhafte Systemstabilität zu gewährleisten, wurde die Firmware in no_std Rust mit dem asynchronen Embassy-Framework entwickelt. Das Gesamtsystem arbeitet komplett ohne dynamische Heap-Allokationen. Sämtliche Modellgewichte liegen als static-Arrays fest im Flash-Speicher, während Zwischenspeicher für Aktivierungen und Framebuffer als statische RAM-Arrays fester Länge dimensioniert sind. Dies eliminiert Risiken durch Speicherfragmentierung oder Allokationsfehler vollständig.
Die für den stream-x-Onboard-Lerner benötigten Gewichte und Spuren belegen lediglich 49 KB bis 106 KB und arbeiten ebenfalls sicher im statischen RAM. Eine asynchrone Dual-Core-Pipeline stellt eine flüssige Interaktion sicher: Core 1 durchläuft kontinuierlich Merkmalsauslese, Aktionswahl, 2 Rekursionsschleifen, heuristische Dekodierung und Belohnungsvorhersage. Die Daten werden über einen Puffer mit zwei Slots an Core 0 übertragen. Ist Core 0 ausgelastet, verwirft er Frames, damit die Inferenz auf Core 1 niemals blockiert wird.
Auf einem Desktop-Prozessor benötigt die Rust-Engine lediglich 0,7 ms (Flappy Bird) bis 1,5 ms (Breakout) pro Frame. Auch wenn für den Pico 2 W keine exakten Millisekundenwerte dokumentiert sind, reicht bei menschlicher Steuerung eine Drosselung auf 66 ms bis 150 ms für ein flüssiges Spielerlebnis. Alle fünf Umgebungen stehen im Repository SheepSeb/tinyworldformer quelloffen bereit – inklusive Terminal-Start über uv und einer WebAssembly-Demo im Browser.
Weltmodelle müssen nicht zwingend auf mächtigen Rechenzentren laufen. Durch zeitliche Wiederverwendung von Gewichten und Festkomma-SIMD beweist tinyworldformer, dass physikalische Umgebungssimulationen auf Mikrocontrollern Realität sind. Mit dem Kompromiss reduzierter Grafikdetails gewinnt man vollständige Autonomie von externen Servern. Ein Speicherbereich von wenigen Hundert Kilobyte genügt, um autonomen Agenten ihre eigene physikalische Sandbox bereitzustellen.
Weiterführende Links:
- SheepSeb Blog: tinyworldformer Technische Analyse und Implementierungsdetails
- GitHub Repository: SheepSeb/tinyworldformer