手のひらサイズのマイコン開発基板が、ゲームエンジンや外部サーバーに頼ることなく、チップ内部で物理世界の因果関係を自律的に演算しています。オープンソースプロジェクト「tinyworldformer」では、Raspberry Pi Pico 2 W上で環境予測と意思決定のクローズドループが完結しています。わずか520KBのSRAMしか持たないこのマイコンが、描画を司る再帰型Transformerと、操作アクションを決定するネットワークを同時に実行しています。
従来の世界モデルは、数十億パラメータを抱えた高消費電力なクラウドクラスタに縛られるのが常でした。tinyworldformerはこれとは一線を画す軽量化のアプローチを採りました。モデルのパラメータ数を26k〜131kまで圧縮し、1フレームあたりの計算量を2M〜8M MACs(積和演算)に抑制。5つのクラシックゲーム環境を4MBのFlashと520KBのSRAM内に収めることに成功しました。
強化学習のエージェント訓練は、ネットワーク自身が予測生成したフレームの中で行われ、実際のエミュレータやゲームエンジンに直接触れることは一度もありません。エンドツーエンドのニューラルシミュレーションによってクラウドのオーバーヘッドを解消し、世界モデルと強化学習をマイコンの世界へと引き込みました。画質の制約や83.6%〜100%のフレーム精度というトレードオフはあるものの、外部の計算リソースへの依存は完全に排除されています。
互いを映し出す2つのネットワーク:マイコン上に本物のゲームは存在しない
Pico 2 Wに搭載されたRP2350は、2つのCortex-M33コアを備えています。本システムでは、画面のリフレッシュ処理と因果推論の負荷を物理コア間で明確に分離しています。Core 0はUSB通信とディスプレイ出力を専任で担当し、Core 1はゲームエンジンから切り離された2つのニューラルネットワークを独立して実行します。
「世界モデル」は環境状態の予測推論を担当します。現在のフレームとアクションを入力として受け取り、次のフレームと報酬を予測出力します。そのアーキテクチャはint8に量子化された再帰型Transformerで構成され、パラメータ数は26k〜131kです。1フレームあたり2M〜8M回の積和演算(Pac-Man liteでは8.2M MACs)を発生させますが、オンチップ推論が制御ループに追従できる水準に保たれています。
「アクター」は生成された画面状態を認識してアクションを決定します。float32精度の2層MLPを採用しており、パラメータ数はわずか9k〜16kです。1フレームあたりの積和演算は9k〜16k回と極めて軽量です。アクターは世界モデルの予測特徴量のみを読み取り、世界モデルはアクターから離散アクションのみを受け取ります。
このデュアルネットワーク構成は、柔軟なヒューマンインタラプション(人間による介入)も可能にしています。ボード上の事前学習済みアクターは、ゼロから学習するstream-xエージェントへリアルタイムに切り替えられるほか、開発者がオンボードボタンを押せば瞬時に人間のプレイヤーへと操作権を移せます。プレイヤーがボタンを操作している際も、遊んでいるのはニューラルネットワークがリアルタイムに予測生成した仮想のゲーム画面です。
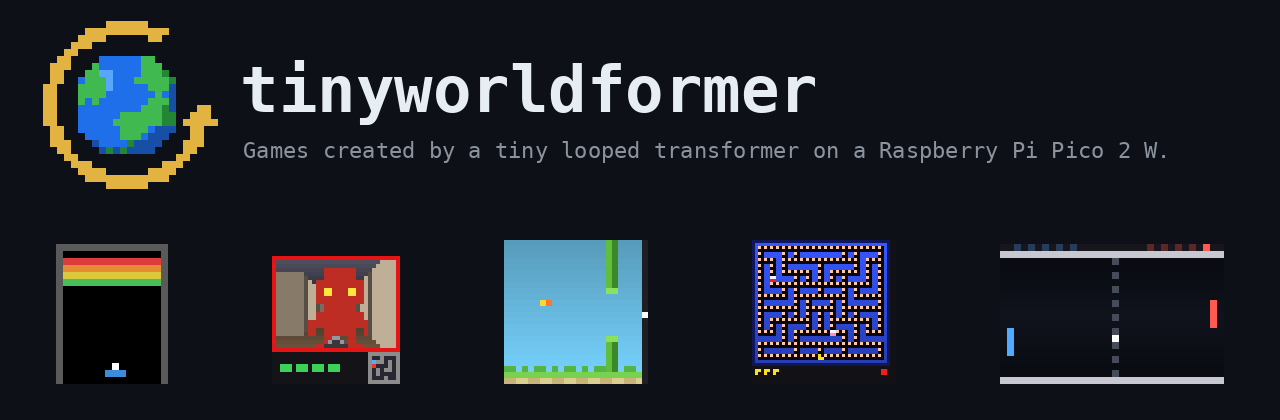 図:tinyworldformerのアーキテクチャとマイコン上でのデュアルネットワーク実行の概要。出典:SheepSeb/tinyworldformer。
単一層の重みを再帰的に再利用:計算レイテンシとメモリ容量のトレードオフ
通常のVision Transformerは複数のブロック層を積み重ねることでモデル容量を拡大します。しかし、マイコンの内蔵SRAMには何層分もの重み配列を保持する余裕はありません。tinyworldformerは再帰型Transformer(Recurrent Transformer)アーキテクチャを採用し、グローバルで保持するTransformerブロックを単一のものに絞りました。同一の重みセットを1〜4回繰り返し適用し、各再帰の直前に初期入力の残差を加算します。
学習時には、各再帰パスの中間出力を本来の次フレームに対して教師あり回帰させます。これにより、実行時の再帰回数は計算遅延と予測精度のトレードオフを調整する物理的なダイヤルとして機能します。Pico 2 W実機では、インタラクティブなフレームレートを維持するため、デフォルトで2回の再帰ループに固定されています。ネットワークの実効深度の決定権をエッジの実行環境に委ねる巧妙な設計です。
Doom-liteのテストケースを見ると、再帰回数がビジュアルのハルシネーション(幻覚)抑制に劇的な効果をもたらすことが分かります。1回の推論では存在しない敵キャラクターを誤生成し、画面全体で92個のエラーグリッドが発生します。これを2回の再帰に増やすとエラーは35個に減少し、3回で12個、4回では画面上の誤生成が完全に解消されました。
プロジェクトでは2回再帰の設定下で5つのゲームを検証しました。Breakout(20×16グリッド)は26kパラメータ・4.3M MACsで99.99%のフレーム精度を達成。Flappy Bird(24×24グリッド)は46kパラメータ・2.0M MACsで100%の精度を記録。Pong(20×32グリッド)は46kパラメータ・2.3M MACsで99.45%の精度となり、決定論的な平面物理挙動が見事にフィッティングされています。
一方で、深い状態追跡や疑似3Dレンダリングを伴う環境では、パラメータ容量の限界にも直面します。Pac-Man liteは48×48グリッドの中に複雑な迷路と2匹のゴーストを抱え、パラメータ数は131k、計算量は8.2M MACsに達し、精度は86.4%にとどまります。Doom-liteは32×32の主観視点と8×8迷路で55kパラメータ・4.2M MACsを要し、精度は83.6%でした。複数エンティティの隠れ状態を追う場合、低パラメータモデルでは局所的なグリッドの乱れを受け入れるトレードオフが必要です。
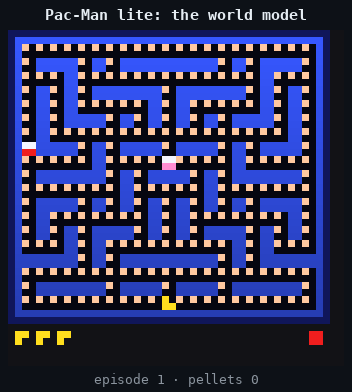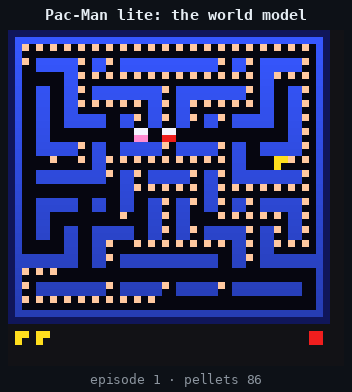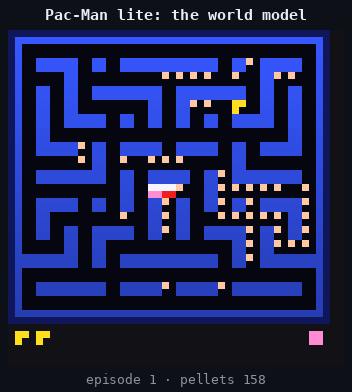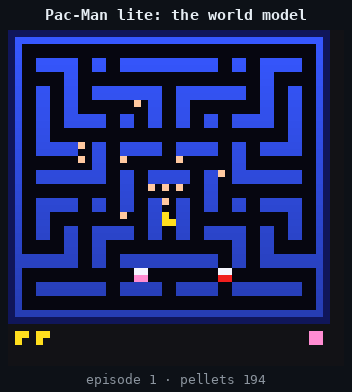 図:本物のゲームエンジンが介在しない環境下で世界モデルが自律生成したPac-Manの連続予測フレーム。出典:SheepSeb/tinyworldformer。
ヒューリスティック・デコードによる幻覚抑制:確率分布にルールを課す
軽量なニューラルネットワークに制約のないSoftmax分布から直接サンプリングさせると、生成される物理世界は数ステップで崩壊してしまいます。パックマンが画面上で突如分裂したり、跳ね返るはずのボールが忽然と消滅したりします。確率分布はそのままでは正常なゲーム画面を構成できないため、デコード処理には独立したルール設計が施されています。
第1のルールは静的な背景に関するものです。壁、ブロック、エサ、床などのグリッドセルは、それぞれ独立して最大確率のトークンを選択(argmax)します。背景要素を独立決定させることでグローバルな探索コストを削減し、迷路の壁がゆがんだり動いたりする現象を防ぎます。
第2のルールは単一エンティティの管理です。ボールや自機プレイヤーのようなオブジェクトは、全グリッドとカテゴリの組み合わせの中で画面上に1つだけ選ばれます。これにより物理的な唯一性が保証されます。リスポーンやサーブなどのランダムイベントの際、デコーダは最適解の周辺2.2 logitsの範囲内からサンプリングを行うことで、平均化による残像を防ぎつつ、動的な挙動の多様性を維持します。
第3のルールは2×2の複合セルを占有する動的スプライト(パックマンやゴーストなど)を制御します。主グリッドのみが口の向きやエサとの重なりといった状態値を保持します。残りの3セルは事前定義されたパターンに沿って自動的にスタンプ配置され、ピクセルごとの推論をスキップしてキャラクタの描画崩れを完全に防止します。
全体をint8へ圧縮:1つのSIMD命令で2回の積和演算を実行
Transformerをマイコンへ移植する際の最大のハードルは、浮動小数点行列積に伴う消費電力と計算リソースです。tinyworldformerは世界モデルのすべての重み行列をint8整数に量子化しました。行列の出力行ごとに行単位のスケーリング係数を算出します(scale = max|w| / 127)。活性化テンソルも同様にint8へ量子化され、所属テンソルと再帰ラウンドごとに個別のスケールが割り振られます。
RP2350に搭載されたCortex-M33コアは、整数演算を加速する命令セットを備えています。32ビットのメモリリード1回で4つの重みを取得し、SXTB16でバイト列を2組の16ビット値に展開、SMLAD命令1発で2つの積和演算を実行して32ビットレジスタに累積加算します(アテンション機構のuint8確率×int8値の演算にはUXTB16を活用)。行列計算パイプラインは、int32の累積が完了した段階で、2つのスケールを掛け合わせた浮動小数点演算を1回だけ適用して実数値を復元します。さらに1024エントリの事前計算テーブルを用いたuint8 Softmaxと組み合わせることで、連続した重い浮動小数点演算を完全に排除しました。
一方で、RP2350が備えるハードウェアFPU(単精度浮動小数点演算ユニット)も無駄にはしていません。LayerNormの正規化、残差接続の加算、入力Embedding処理はfloat32精度を維持しています。これら非行列積処理が計算全体に占める割合は極めて低いため、浮動小数点を保持して累積誤差を防ぎ、固定小数点による高速化と数値安定性を両立させました。
この量子化手法が高い再現性を誇る理由は、学習時とデプロイ時の振る舞いが厳密に一致しているためです。モデルは学習段階から量子化認識学習(QAT)とストレートスルー推定(STE)によって実機と同一の整数丸めを導入しており、学習結果がそのままデプロイ用の固定小数点ネットワークになります。エクスポートモジュールrustexport/intref.pyはNumPyの浮動小数点演算の順序を厳密に固定しており、Rust推論エンジンがマイコン上でリファレンス実装をビット単位で忠実に再現します。
 図:モデル行列と活性化値の行単位および再帰ループごとのint8量子化スキーム。出典:SheepSeb/tinyworldformer。
ヒープ割り当てゼロで520KB SRAMに収める:エッジでの自律シミュレーション
組み込み環境においてメモリの枯渇は許されません。ELFバイナリをsize -Aで解析すると、BreakoutはFlash 361KB/RAM 299KB、Flappy Birdは409KB/227KB、Pongは414KB/244KBを消費します。Doom-liteは471KB/357KB、Pac-Man liteは600KB/460KBとなりました。すべてのファームウェアがPico 2 Wの4MB Flashおよび520KB SRAMの枠組み内に収まっています。
メモリの内訳をプロファイリングすると、直感に反する事実が浮き彫りになります。世界モデル全体の中で、量子化されたint8の重みデータは19.7KB〜33.9KBしか占めていません。それに対してfloat32形式のEmbedding、正規化パラメータ、scale配列などの周辺要素が31.6KB〜91.9KBとメモリ消費の大半を占めています。ストレージの消費要因はコンパクトな計算コアではなく、エッジでの整合性を保つアダプテーション層に集中しています。
システムの長期的な安定稼働を確保するため、ファームウェアはno_std RustとEmbassy非同期フレームワークを用いて開発されました。ライフサイクル全体を通じて動的なヒープメモリ割り当てを完全にゼロ(ゼロアロケーション)に保っています。すべてのモデル重みはFlash上のstatic配列として配置され、中間の計算バッファやフレームバッファはすべてRAM上に固定長静的配列として確保されます。動的メモリ管理を排したことで、メモリ断片化や割り当てエラーによるクラッシュリスクを根本から排除しました。
オンボードのstream-x学習エージェントに必要な重みと適格度トレースも49KB〜106KB程度であり、同様に静的メモリ内で安全に動作します。デュアルコアの非同期パイプラインによって快適な応答性も維持されています。Core 1は特徴量読み出し、アクション選択、2回の再帰推論、ヒューリスティックデコード、報酬予測をループ実行します。計算結果は深さ2のスロットチャネルを介してCore 0へと送られ、Core 0が描画等でビジーな場合はフレームを適宜ドロップすることで、Core 1の推論処理が決してブロックされない仕組みになっています。
デスクトップCPU上では、このRustエンジンは1フレームあたりわずか0.7ms(Flappy Bird)〜1.5ms(Breakout)で推論を完了します。Pico 2 W実機でのミリ秒単位のベンチマーク値は明記されていないものの、人間が操作する場合、フレーム間隔を66ms〜150ms程度に設定すれば非常にスムーズなプレイ体験が得られます。5つのゲーム環境はすべてSheepSeb/tinyworldformerリポジトリにてオープンソース公開されており、uvコマンドによるターミナル実行のほか、WebAssemblyによるブラウザデモも用意されています。
世界モデルはもはや巨大なクラウドクラスタ専用の技術ではありません。tinyworldformerは重みの時間的再利用と固定小数点SIMDの活用によって、マイコン上での環境シミュレーションという新たな地平を拓きました。解像度や局所的な乱れという代償と引き換えに、外部サーバーを必要としない完全なエッジ自律性を獲得したのです。数百キロバイトの小さな領域であっても、自律エージェントのための物理サンドボックスを走らせるには十分でした。
参考リンク:
- SheepSeb 個人ブログ:tinyworldformer 技術解説と実装の詳細
- GitHub リポジトリ:SheepSeb/tinyworldformer