Une carte de développement à microcontrôleur de la taille d’une paume fonctionne en autarcie complète, sans moteur de jeu ni serveur distant. Au cœur même de la puce, elle calcule de manière autonome les chaînes causales d’un monde physique. Dans le projet open source tinyworldformer, un Raspberry Pi Pico 2 W prend en charge l’intégralité de la boucle de prédiction et de décision. Ne disposant que de 520 Ko de SRAM, ce composant exécute en parallèle un Transformer récurrent générant les images et un réseau de décision déterminant les actions.
Traditionnellement, les modèles de monde sont l’apanage de clusters cloud énergivores mobilisant des milliards de paramètres. tinyworldformer emprunte une voie résolument sobre : il compresse les réseaux entre 26k et 131k paramètres, réduisant la charge de calcul par image à une fourchette de 2M à 8M d’opérations de multiplication-accumulation (MAC). Les environnements de cinq jeux classiques se nichent ainsi dans 4 Mo de mémoire Flash et 520 Ko de SRAM.
L’entraînement par apprentissage par renforcement se déroule entièrement au sein des images prédites par le réseau neuronal. L’agent n’entre jamais en contact avec le moteur de jeu d’origine. Cette simulation neuronale de bout en bout supprime les coûts d’infrastructure cloud et transpose les modèles de monde ainsi que l’apprentissage par renforcement sur microcontrôleur. La contrepartie réside dans une définition visuelle modeste et une précision par image comprise entre 83,6 % et 100 %, compensée par la disparition totale des besoins en serveurs externes.
Deux réseaux miroirs : aucun vrai moteur de jeu sur la puce
La puce RP2350 qui équipe le Pico 2 W embarque deux cœurs Cortex-M33. Le système sépare rigoureusement le rafraîchissement d’affichage et l’inférence causale au niveau des cœurs physiques. Le Core 0 se consacre aux communications USB et à la sortie écran. Le Core 1 exécute indépendamment deux réseaux neuronaux en miroir, libérés de tout moteur de jeu traditionnel.
Le modèle de monde se charge de la simulation prédictive de l’environnement. Recevant en entrée l’image courante et l’action choisie, il prédit l’image suivante ainsi que la récompense associée. Son architecture repose sur un Transformer récurrent quantifié en int8 comptant entre 26k et 131k paramètres. Chaque trame nécessite 2M à 8M d’opérations MAC (atteignant 8,2M de MACs pour Pac-Man lite), garantissant que l’inférence embarquée tienne le rythme de la boucle de contrôle.
L’acteur (ou décideur) analyse le rendu visuel et sélectionne les actions. Conçu sous forme d’un perceptron multicouche (MLP) à deux couches en float32 de seulement 9k à 16k paramètres, il n’exige que 9k à 16k MACs par image – une empreinte calculatoire infime. L’acteur n’examine que les caractéristiques prédites par le modèle de monde, tandis que ce dernier ne reçoit que les actions discrètes envoyées par l’acteur.
Cette architecture à double réseau offre une grande souplesse pour la reprise en main par l’utilisateur. L’acteur pré-entraîné peut être basculé à chaud vers un agent stream-x qui apprend depuis zéro. Dès que le développeur presse un bouton de la carte, le contrôle est instantanément transféré à un joueur humain. En manipulant les touches, l’utilisateur évolue lui aussi au sein d’un univers virtuel imaginé et prédit en temps réel par le réseau de neurones.
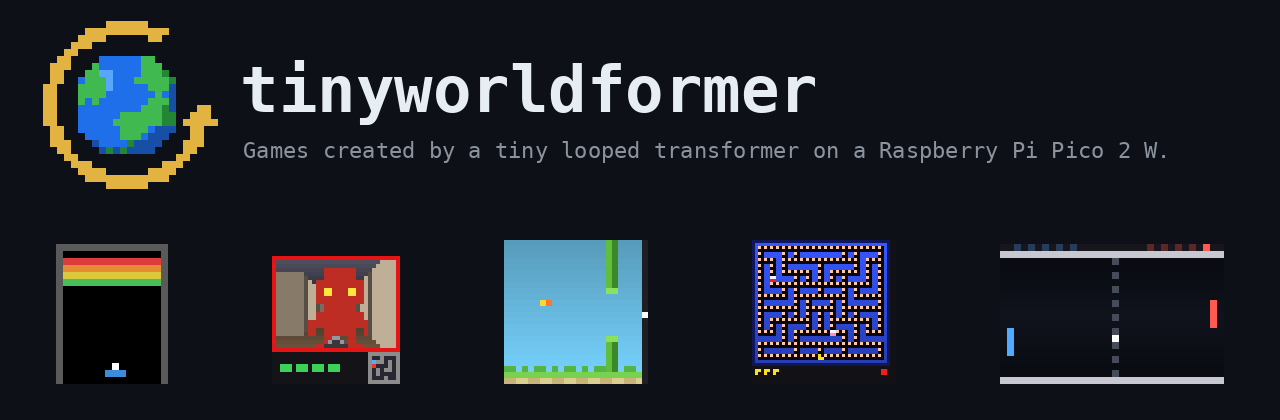 Figure : Architecture de tinyworldformer et vue d’ensemble de l’exécution des deux réseaux sur le microcontrôleur. Source : SheepSeb/tinyworldformer.
Réutilisation récurrente des poids : troquer la latence contre la mémoire
Les Transformers de vision classiques empilent de multiples blocs pour accroître leur capacité. Or, la SRAM d’un microcontrôleur ne permet pas de stocker plusieurs jeux de poids distincts. tinyworldformer retient une architecture de Transformer récurrent ne conservant qu’un unique bloc Transformer à l’échelle globale. Le modèle réutilise le même jeu de poids de 1 à 4 fois, en réinjectant le résidu de l’entrée initiale avant chaque nouvelle passe.
Durant l’entraînement, les sorties intermédiaires de chaque passe récurrente font l’objet d’une régression supervisée sur la véritable image suivante. Lors de l’exécution, le nombre de passes devient un potentiomètre physique permettant d’arbitrer entre latence de calcul et fidélité de prédiction. Sur le matériel du Pico 2 W, le système fixe par défaut 2 itérations récurrentes afin de garantir une cadence interactive. Cette conception délègue le choix de la profondeur du réseau à l’environnement d’exécution embarqué.
L’exemple isolé de Doom-lite illustre l’efficacité spectaculaire de ces passes récurrentes pour dissiper les hallucinations visuelles. Avec une seule itération, le modèle invente de toutes pièces un ennemi et génère 92 cellules erronées sur l’affichage. En passant à 2 itérations, l’erreur chute à 35 cellules. Une 3e passe abaisse ce chiffre à 12, et 4 itérations suppriment l’intégralité des artefacts.
Le projet a mesuré les performances de 5 jeux sous 2 itérations récurrentes. Breakout (grille de 20×16) atteint 99,99 % de précision par image pour 26k paramètres et 4,3M de MACs. Flappy Bird (24×24) affiche 100 % de précision avec 46k paramètres et 2,0M de MACs. Pong (20×32) enregistre 99,45 % de précision avec 46k paramètres et 2,3M de MACs, modélisant avec brio une physique plane déterministe.
Les environnements nécessitant un suivi d’état complexe et un rendu pseudo-3D atteignent les limites capacitaires du modèle. Pac-Man lite intègre un dédale complexe et deux fantômes dans une grille de 48×48, portant les paramètres à 131k et le calcul à 8,2M de MACs pour une précision de 86,4 %. Doom-lite adopte une vue à la première personne en 32×32 dans un labyrinthe 8×8, mobilisant 55k paramètres et 4,2M de MACs pour 83,6 % de précision. Face à de multiples états cachés, les modèles compacts doivent composer avec de légères instabilités visuelles localisées.
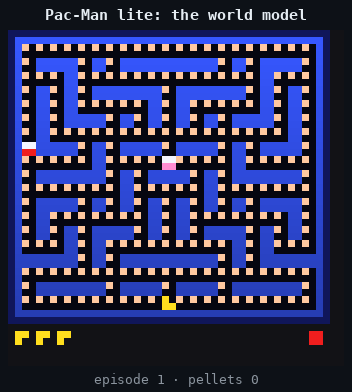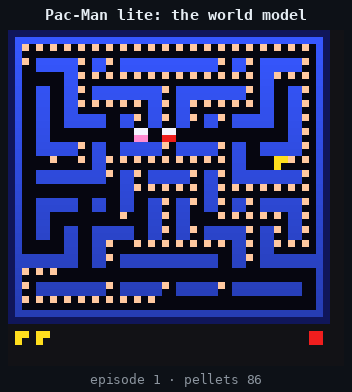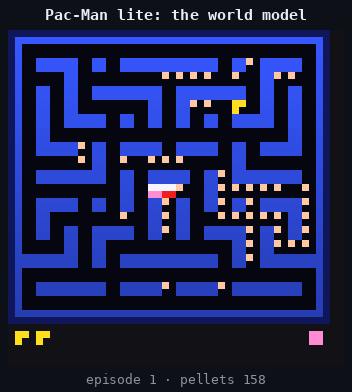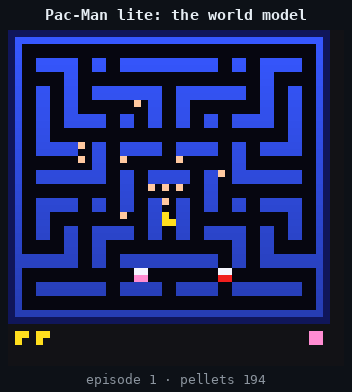 Figure : Trames de prédiction de Pac-Man générées de façon autonome par le modèle de monde sans intervention de moteur de jeu. Source : SheepSeb/tinyworldformer.
Décodage heuristique anti-hallucinations : discipliner les distributions
Si un réseau de neurones compact échantillonnait librement et sans contrainte dans les distributions Softmax, le monde physique généré s’effondrerait en quelques étapes. Pac-Man se dupliquerait à l’écran et la balle disparaîtrait en plein rebond. Le décodage bénéficie d’une attention particulière car les distributions brutes de probabilité ne produisent pas d’elles-mêmes un affichage de jeu valide.
La première règle régit l’arrière-plan statique. Les cases représentant les murs, briques, pac-gommes ou le sol sélectionnent chacune de manière autonome le token de probabilité maximale (argmax). Cette décision indépendante élimine le coût d’une recherche globale sur graphe et verrouille le tracé du labyrinthe, empêchant toute déformation des parois.
La deuxième règle encadre les entités uniques (singletons). Les éléments singuliers comme la balle ou le personnage joueur ne sont choisis qu’une seule fois sur l’ensemble de la grille et des catégories. L’unicité spatiale est ainsi strictement garantie. Lors d’événements aléatoires comme un service ou une réapparition, le décodeur échantillonne dans un voisinage de 2,2 logits autour du point optimal, préservant la variété dynamique tout en éliminant les rémanences floues.
La troisième règle s’applique aux sprites mobiles occupant des blocs composites de 2×2 cellules. Pour les personnages comme Pac-Man ou les fantômes, seule la case principale porte le vecteur d’état (direction de la bouche ou recouvrement d’une pac-gomme). Les trois autres cases sont complétées selon des patrons prédéfinis, évitant les prédictions cellule par cellule et éliminant tout déchirement d’affichage des protagonistes.
Quantification intégrale en int8 : deux MACs par instruction SIMD
L’obstacle majeur pour porter des Transformers sur microcontrôleur réside dans l’intensité énergétique des multiplications matricielles en virgule flottante. tinyworldformer convertit l’ensemble des matrices de poids du modèle de monde en entiers int8. Le réseau calcule les facteurs d’échelle par ligne de sortie de matrice (scale = max|w| / 127). Les tenseurs d’activation sont également quantifiés en int8 et se voient attribuer des échelles dédiées selon le tenseur et la passe de récurrence.
Le cœur Cortex-M33 du RP2350 met à disposition des instructions dédiées pour accélérer l’arithmétique entière. Une seule lecture mémoire 32 bits récupère 4 poids, SXTB16 décompresse les octets en deux paires de 16 bits, et l’instruction SMLAD accomplit deux multiplications-accumulations dans un registre 32 bits en un seul cycle (les mécanismes d’attention exploitent UXTB16 pour les probabilités uint8 × valeurs int8). Une fois l’accumulation int32 achevée, le pipeline n’applique qu’une seule mise à l’échelle flottante via les facteurs d’échelle. Grâce à une table précalculée de 1024 entrées pour le calcul Softmax sur uint8, l’appareil se libère de coûteux calculs flottants en chaîne.
L’unité de virgule flottante matérielle (FPU) du RP2350 n’est pas pour autant inactive. La normalisation LayerNorm, l’addition des connexions résiduelles et les plongements d’entrée (embeddings) restent en précision float32. Ces étapes représentent une fraction infime de la charge globale. Préserver ce format flottant évite la dérive numérique cumulative dans les couches profondes, associant l’accélération en virgule fixe à la rigueur numérique.
La haute fidélité du procédé provient de la concordance stricte entre phase d’entraînement et déploiement. Grâce à un entraînement sensible à la quantification (QAT) avec estimateurs directs (STE), le modèle intègre les mêmes arrondis entiers dès l’apprentissage ; le réseau entraîné correspond exactement au réseau en virgule fixe déployé. Le module d’export rustexport/intref.py fige la séquence des opérations NumPy. Le moteur d’inférence en Rust sur microcontrôleur réplique l’implémentation de référence au bit près, bannissant tout écart entre plateformes.
 Figure : Schéma de quantification int8 par ligne et par passe de récurrence pour les matrices et activations. Source : SheepSeb/tinyworldformer.
Zéro allocation sur le tas : 520 Ko de SRAM sanctuarisés pour la simulation
Le monde de l’embarqué ne tolère aucun débordement de mémoire. L’analyse du binaire ELF avec size -A montre que Breakout mobilise 361 Ko de Flash et 299 Ko de RAM, Flappy Bird 409 Ko et 227 Ko, Pong 414 Ko et 244 Ko. Doom-lite réclame 471 Ko et 357 Ko, tandis que Pac-Man lite consomme 600 Ko de Flash et 460 Ko de RAM. L’ensemble des microprogrammes tient confortablement dans les 4 Mo de Flash et 520 Ko de SRAM du Pico 2 W.
L’inspection de la mémoire dévoile une réalité contre-intuitive. Dans l’ensemble du modèle de monde, les poids quantifiés en int8 ne représentent que 19,7 Ko à 33,9 Ko. En revanche, les embeddings en float32, les paramètres de normalisation et les tableaux d’échelles forment le gros des troupes, occupant entre 31,6 Ko et 91,9 Ko. L’encombrement mémoire se concentre pour l’essentiel dans les couches d’adaptation périphérique et non dans le cœur de calcul compact.
Pour garantir une robustesse à toute épreuve, le firmware a été développé en no_std Rust avec le framework asynchrone Embassy. Le système parvient à proscrire toute allocation dynamique sur le tas durant l’intégralité de son cycle de vie. Tous les poids du modèle résident en Flash sous forme de tableaux static, tandis que les zones d’activation et mémoires tampons d’affichage sont préallouées en RAM en tant que tableaux statiques de dimension fixe. Supprimer la gestion dynamique écarte tout danger de fragmentation ou de plantage par manque de mémoire.
Les poids et traces d’éligibilité nécessaires à l’agent d’apprentissage stream-x embarqué ne requièrent que 49 Ko à 106 Ko, fonctionnant également en mémoire statique sécurisée. Le pipeline asynchrone double cœur maintient une réactivité fluide. Le Core 1 orchestre en boucle l’extraction des caractéristiques, le choix de l’action, 2 passes d’inférence récurrente, le décodage heuristique et la prédiction de récompense. Les trames sont transmises au Core 0 via un canal à double emplacement ; lorsque le Core 0 est saturé, il supprime des images pour éviter que le Core 1 ne soit mis en attente.
Sur processeur de bureau, ce moteur Rust calcule chaque image en seulement 0,7 ms (Flappy Bird) à 1,5 ms (Breakout). Même si le temps précis en millisecondes n’a pas été publié pour la Pico 2 W, ralentir la cadence entre 66 ms et 150 ms offre une expérience de jeu parfaitement réactive pour un être humain. Les cinq environnements sont disponibles en open source sur le dépôt SheepSeb/tinyworldformer, compatibles avec une exécution en terminal via uv et accompagnés d’une démonstration WebAssembly dans le navigateur.
Les modèles de monde ne sont plus condamnés à dépendre de gigantesques grappes de serveurs en nuage. En combinant réutilisation temporelle des poids et instructions SIMD en arithmétique fixe, tinyworldformer prouve qu’un microcontrôleur peut faire tourner une simulation environnementale interactive. En acceptant une résolution d’affichage modeste au profit d’une autonomie totale sans serveur, quelques centaines de kilo-octets suffisent désormais à accueillir un bac à sable physique taillé sur mesure pour des agents intelligents.
Liens de référence :
- Blog de SheepSeb : Analyse technique et détails d’implémentation de tinyworldformer
- Dépôt GitHub : SheepSeb/tinyworldformer