Le 30 octobre 2026, l’entreprise européenne d’IA Mistral a officialisé la mise en open source des poids de son modèle phare, Mistral Large 4, sous le nom de code « Le Chonk ». Doté de 1,05 billion de paramètres et fondé sur une architecture sparse Mixture-of-Experts (MoE), le modèle a été pré-entraîné de zéro sur le territoire européen. Prenant en charge nativement l’analyse multimodale des images, des documents et du code source, il s’impose d’emblée au premier rang des poids ouverts.
Dans l’indice Coding Agent Index d’Artificial Analysis, Le Chonk a obtenu un score de 48 %, faisant quasiment jeu égal avec GLM-5.3, son homologue open source du moment. Les données d’ingénierie révèlent toutefois un résultat contre-intuitif : pour accomplir les mêmes tâches de développement logiciel, le modèle a consommé en moyenne 47 % de tokens de sortie en moins. Mistral qualifie cette zone d’efficience énergétique de « sweet spot » de l’inférence.
L’évolution des grands modèles de langage ne se mesure plus uniquement aux classements de référence, mais au coût réel de l’inférence en conditions de production. Dès lors que les taux de réussite s’égalisent, le débit interactif et l’empreinte VRAM déterminent la viabilité d’un système. Ces chiffres apportent la preuve que l’open source est désormais capable de rivaliser sur le terrain économique du calcul.
Des benchmarks au niveau des modèles de pointe, 47 % de tokens en moins par tâche
Avec l’intégration des agents autonomes au sein des chaînes de production, les contextes étendus et les raisonnements itératifs constituent les principaux facteurs de coût. Dans le Coding Agent Index, Le Chonk atteint 48 %, s’alignant sur GLM-5.3. Mais la véritable rupture tient à la métrique de consommation : une réduction de 47 % des tokens permet de réduire de près de moitié les dépenses d’inférence sur les tâches de longue durée.
D’après les données rapportées par Mistral sur le banc d’essai FrontierCode 2.0 de Cognition — qui évalue si les mainteneurs de dépôts acceptent de fusionner les modifications proposées —, Le Chonk affiche un taux de merge de 19,7 %, devançant les 19,3 % de GLM-5.3. À la même période, Kimi K3 atteint 17,8 % et GLM-5.3 Flash 17,3 %, tandis qu’en bas de tableau, Beam 1.0 se situe à 14,2 % et DeepSeek V4.1 Flash à 2,9 %.
Cette légère avance en matière de fusion reflète la rigueur et la cohérence du code produit au regard des exigences de production. Les codes automatisés essuient fréquemment des refus de la part des mainteneurs en raison de commentaires superflus ou de tests trop fragiles. En conservant son taux de réussite tout en diminuant son volume de sortie de près de moitié, le modèle démontre la capacité de sa politique à juguler les tâtonnements infructueux et la sur-ingénierie.
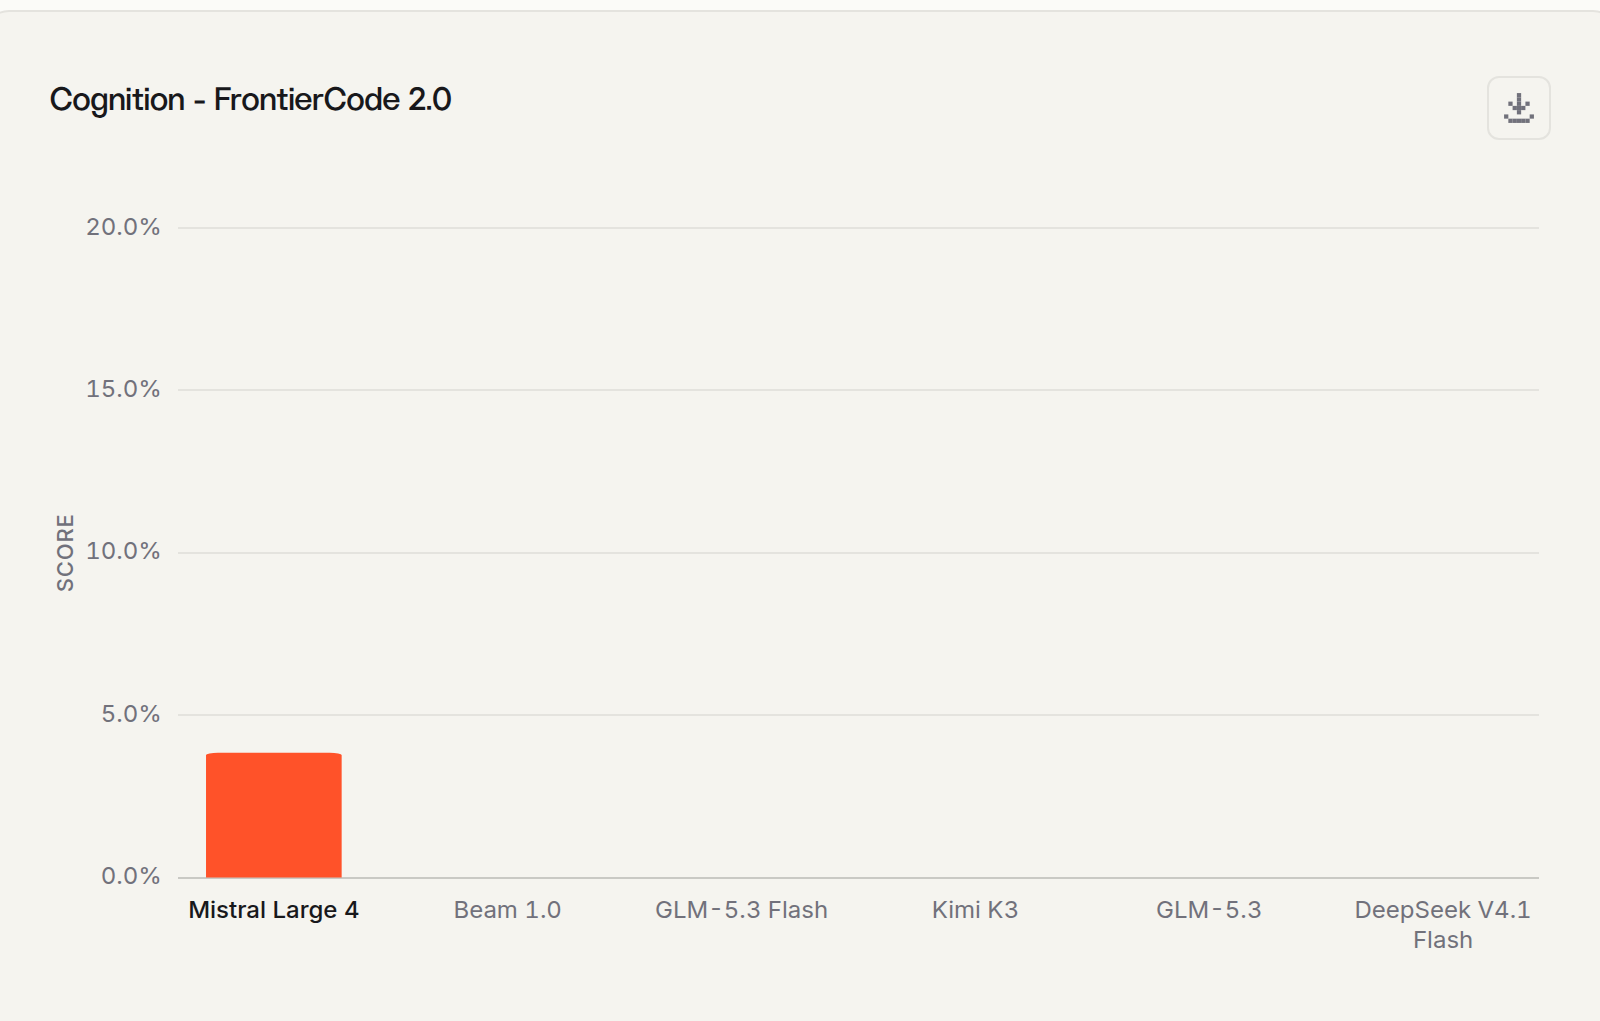 Figure : Comparatif des scores sur le benchmark FrontierCode 2.0, évalué selon la fusion effective des modifications par les mainteneurs de dépôts. Notez la dispersion des scores sous des standards stricts. Source : Blog officiel de Mistral.
Trois semaines de renforcement post-entraînement pour compacter les sorties terminal
La nette compression de la longueur des sorties est le fruit d’une optimisation post-entraînement rigoureuse. Sur sa base pré-entraînée, Mistral a greffé trois semaines supplémentaires d’apprentissage par renforcement (RL), dédiées spécifiquement à la réduction du nombre d’actions des agents. Dans l’environnement de test en ligne de commande Terminal-Bench 4.0, Le Chonk affiche un taux de réussite de 41 %, soit un gain de 13 points par rapport à la version preview précédente.
Tandis que le taux de succès progressait, le volume de calcul s’est contracté : sur les tâches en terminal, le modèle a réduit ses tokens de sortie de 30 %. Dans son communiqué officiel, Mistral indique que les gains tirés de l’apprentissage par renforcement continuent de s’accélérer sans montrer de signe de saturation. Des modèles de récompense ajustés aux environnements interactifs ont permis d’éliminer la prolixité inutile des agents.
Afin de s’adapter aux différents budgets d’infrastructure, le modèle propose trois modes d’inférence distincts : Low, Medium et High. Activé par défaut, le mode High est destiné aux raisonnements profonds et longs, tandis que le mode Low remplace purement et simplement le fonctionnement sans raisonnement. Ce découpage transforme la profondeur de délibération en une variable opérationnelle configurable. Les tâches simples de diagnostic n’ont plus à supporter le coût d’une lourde chaîne de pensée, épargnant une précieuse mémoire VRAM sous forte concurrence.
Un taux de rejet de 96 % face aux requêtes malveillantes : calibré pour l’entreprise
La robustesse défensive d’un modèle conditionne son adoption sur site par les entreprises. Porté par le slogan « Built for Coders, Trusted by Defenders », Le Chonk a atteint un taux de refus moyen de 96,6 % face à des requêtes réseau hostiles. Mistral précise que ce chiffre place le modèle au premier rang de l’open source, tout en soulignant qu’il ne bloque pas indûment les missions légitimes de cyberdéfense.
Dans le Cyber Index établi par Artificial Analysis, Le Chonk se hisse à 51 %. Lors de cette même évaluation, DeepSeek-V4.1-Flash et MiMo-V2.6-Pro enregistrent respectivement 57 % et 56 %. En revanche, lors des tests de préférence humaine à l’aveugle menés par Surge Code, ses prestations se classent au deuxième rang, uniquement devancées par Claude Opus 5.5, surpassant tous ses concurrents open source contemporains.
Le décalage entre un fort taux de rejet et l’indice de sécurité illustre la complexité des compromis d’alignement. Un taux d’interception de 96,6 % bloque la génération automatisée d’exploits et répond aux exigences de conformité. Néanmoins, lors d’analyses approfondies de vulnérabilités ou d’audits contradictoires, des garde-fous stricts peuvent restreindre la portée de l’exploration analytique. Les ajustements pour la production oscillent en permanence entre la neutralisation des dérives et le maintien d’une capacité d’investigation poussée.
1 000 milliards de paramètres en local : la souveraineté européenne face à la réalité économique
Affichant 1,05 billion de paramètres au total, Le Chonk s’appuie sur une architecture sparse MoE. Le fait de n’activer qu’une fraction des paramètres lors de chaque passe avant rend le déploiement d’un modèle d’une telle envergure envisageable sur des grappes de serveurs dédiées. Mistral insiste sur le fait que son modèle a été entraîné de zéro en Europe, marquant une étape symbolique forte pour l’autonomie technologique européenne dans l’IA générative.
Les poids du modèle sont immédiatement téléchargeables sur Hugging Face, avec un support complet de l’auto-hébergement via vLLM ou SGLang. Les fiches du modèle ainsi que les licences ont été publiées conjointement, le rapport technique complet devant paraître sous peu. Cette architecture locale permet aux entreprises de préserver leur propriété intellectuelle sans exposer leur code interne à des services cloud tiers.
Le panel de partenaires officiels réunit notamment NVIDIA, Cisco, Cloudflare et CrowdStrike. Côté européen, la liste inclut ASML, Orange Cyberdefense, le Crédit Agricole ainsi que l’Agence spatiale européenne (ESA). L’implication des industriels de pointe et des acteurs de la défense témoigne du besoin impérieux d’une infrastructure d’IA souveraine pour les environnements hautement réglementés.
Toutefois, les ambitions de souveraineté doivent se confronter à la réalité matérielle des centres de données. Même activés de manière clairsemée, 1,05 billion de paramètres représentent des centaines de gigaoctets de données brutes, rendant les transferts vers la VRAM et le stockage incompressibles. Les interconnexions à très haut débit et la consommation électrique des clusters privés constituent un défi logistique majeur. Les entreprises doivent ainsi évaluer précisément l’équilibre entre dépenses d’équipement initiales et coûts d’exploitation à long terme.
 Figure : Liste des institutions partenaires dévoilée par Mistral, couvrant la fabrication de semi-conducteurs, la cybersécurité et l’aérospatiale européenne. Source : Blog officiel de Mistral.
Au-delà du plateau des benchmarks, le coût d’inférence dicte la survie de l’open source
La rivalité dans l’open source aborde une phase charnière. Les premières étapes se concentraient sur l’accumulation de données d’entraînement et la quête de scores records. Dès lors que les modèles phares ne se détachent plus nettement sur les taux de réussite, le budget alloué au calcul continu devient le facteur prépondérant. Le nombre de tokens consommés par unité de travail dicte la viabilité économique d’un déploiement à long terme.
Le Chonk ouvre une voie pragmatique : préserver un niveau d’exigence équivalent dans la livraison logicielle tout en réduisant de moitié la consommation de tokens permet de comprimer significativement la facture matérielle. Les organisations recherchent l’autonomie, mais elles ont avant tout besoin de calculs financièrement soutenables. C’est en alliant puissance de calcul et sobriété des tokens que les poids ouverts s’ouvrent véritablement les portes de l’ingénierie logicielle de production.
 Figure : « Le Chonk », la mascotte officielle choisie par Mistral pour son modèle phare. Source : mistral.ai.
参考链接:
- Mistral 官方博客:Mistral Large 4 开源权重发布说明
- Mistral 官方博客:Mistral Large 4 模型架构与基准评测
- Hugging Face 官方权重仓库:Mistral-Large-4-1T-A52B