El 30 de octubre de 2026, la compañía europea de inteligencia artificial Mistral hizo públicos oficialmente los pesos de su modelo insignia Mistral Large 4, bautizado con el nombre en clave «Le Chonk». Con un total de 1,05 billones de parámetros y basado en una arquitectura MoE (Mixture of Experts) dispersa, el modelo fue preentrenado desde cero en territorio europeo. Compatible de forma nativa con el análisis multimodal de imágenes, documentos y código fuente, se sitúa de inmediato en la primera línea de los modelos abiertos.
En el índice Coding Agent Index de Artificial Analysis, Le Chonk obtuvo un 48 %, empatando en la práctica con su homólogo de código abierto GLM-5.3. Sin embargo, los registros de ingeniería revelaron un dato contra intuitivo: al completar las mismas tareas de desarrollo de software, consumió en promedio un 47 % menos de tokens de salida. Mistral define esta ventana de eficiencia como el «sweet spot» de la inferencia.
El foco en la evolución de los modelos masivos se está desplazando de las tablas de marcas hacia el coste real de inferencia bajo cargas de trabajo en producción. Cuando la tasa de éxito entre modelos es similar, el rendimiento interactivo y el consumo de VRAM determinan si un sistema es viable para su despliegue operativo. Estos resultados demuestran que el ecosistema abierto ya cuenta con la capacidad de competir frontalmente en la economía del cómputo.
Paridad frente a modelos punteros y un 47 % menos de tokens por tarea
A medida que los agentes se integran en los flujos de producción, los contextos extensos y los razonamientos en múltiples pasos se han convertido en el principal factor de coste. En el Coding Agent Index, Le Chonk alcanza una puntuación del 48 %, a la par que GLM-5.3. No obstante, la diferencia crucial reside en el volumen consumido: reducir el gasto de tokens un 47 % permite recortar casi a la mitad el presupuesto de inferencia en tareas prolongadas.
Según informa Mistral, en el benchmark FrontierCode 2.0 de Cognition —que toma como criterio decisivo si los mantenedores de repositorios aceptan fusionar las modificaciones propuestas—, Le Chonk logró una tasa de merge del 19,7 %, superando el 19,3 % de GLM-5.3. En la misma comparativa, Kimi K3 registró un 17,8 % y GLM-5.3 Flash un 17,3 %, mientras que Beam 1.0 obtuvo un 14,2 % y DeepSeek V4.1 Flash quedó en un 2,9 %.
Esta ligera ventaja en la tasa de fusión refleja una mayor coherencia con los estándares de ingeniería de software. El código generado automáticamente suele ser rechazado por incluir comentarios redundantes o pruebas frágiles. Mantener la tasa de éxito reduciendo la salida casi a la mitad demuestra que las políticas del modelo logran mitigar eficazmente las pruebas innecesarias y el exceso de ingeniería.
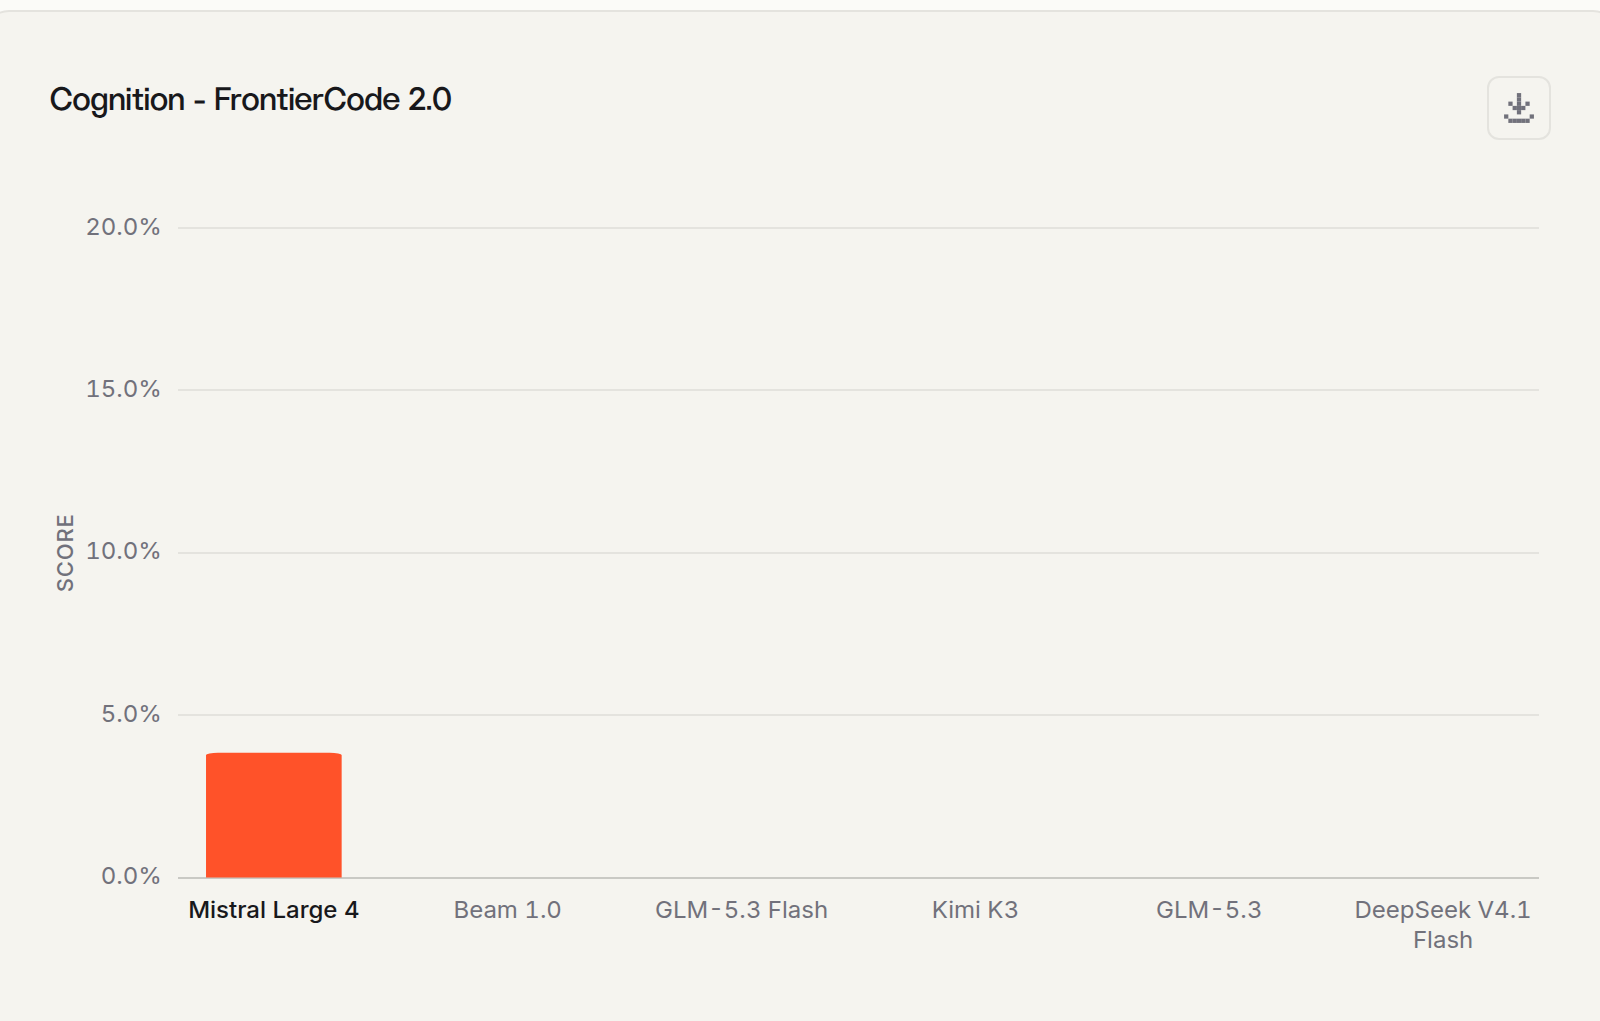 Figura: Comparativa de resultados en el benchmark FrontierCode 2.0 según la aceptación de merges por parte de los mantenedores. Nótese la dispersión de puntuaciones bajo estrictos estándares de ingeniería. Fuente: Blog oficial de Mistral.
Tres semanas adicionales de refuerzo para recortar salidas en terminal
La drástica reducción en la extensión de las respuestas proviene de la optimización post-entrenamiento. Sobre la base preentrenada, Mistral añadió tres semanas de aprendizaje por refuerzo (RL) enfocado específicamente en comprimir los pasos de acción de los agentes. En Terminal-Bench 4.0, la prueba de entornos de línea de comandos, Le Chonk alcanzó una tasa de éxito del 41 %, lo que representa una subida de 13 puntos porcentuales respecto a la versión preliminar previa.
A la vez que la tasa de acierto ascendía, el volumen de inferencia se reducía de forma inversa: en tareas de terminal, los tokens de salida cayeron un 30 %. En el comunicado oficial, Mistral señala que los beneficios del aprendizaje por refuerzo siguen acelerándose sin síntomas de saturación. Los modelos de recompensa adaptados a entornos interactivos han purgado eficazmente la verbosidad improductiva de los agentes.
Pensando en los distintos presupuestos de computación, el modelo introduce tres modos de inferencia: Low, Medium y High. El modo High, activado de forma predeterminada, está pensado para razonamientos profundos y de largo alcance, mientras que Low sustituye por completo el modo sin razonamiento. Esta segmentación convierte la profundidad de pensamiento en una variable configurable. Las tareas cotidianas de depuración no necesitan cargar cadenas de razonamiento densas, lo que ahorra valiosa memoria VRAM en entornos de alta concurrencia.
Tasa de rechazo del 96 % frente a peticiones maliciosas: blindaje para empresas
La solidez en las fronteras de seguridad determina la viabilidad del despliegue en entornos corporativos privados. Con el lema «Built for Coders, Trusted by Defenders», Le Chonk logró una tasa de rechazo promedio del 96,6 % frente a solicitudes de red maliciosas. La compañía subraya que este resultado se sitúa a la cabeza de los modelos de pesos abiertos, al tiempo que insiste en que las tareas legítimas de ciberdefensa no son bloqueadas indebidamente.
En el Cyber Index de Artificial Analysis, Le Chonk obtuvo un 51 %. En la misma evaluación, DeepSeek-V4.1-Flash marcó un 57 % y MiMo-V2.6-Pro un 56 %. Por el contrario, en las pruebas a ciegas de preferencia humana Surge Code, su desempeño se situó en segundo lugar, solo por detrás de Claude Opus 5.5, superando con claridad al resto de rivales abiertos evaluados.
La distancia entre una alta tasa de rechazo y el índice de seguridad evidencia la doble cara del ajuste fino. El bloqueo del 96,6 % cierra el paso a la generación automática de scripts de explotación y cumple con los estándares corporativos. Sin embargo, en labores de ingeniería inversa o pruebas adversarias complejas, unos límites de seguridad muy estrictos pueden restringir el espacio de razonamiento analítico. El ajuste para producción busca un equilibrio práctico entre prevenir abusos y conservar la profundidad inductiva.
1 billón de parámetros en local: el cómputo soberano europeo ante las cuentas reales
Le Chonk cuenta con 1,05 billones de parámetros totales y funciona mediante un mecanismo MoE disperso. Activar solo una fracción de los parámetros en cada paso hacia adelante permite desplegar un modelo de este calibre en clústeres especializados. Mistral destaca que el modelo fue entrenado íntegramente en Europa, convirtiéndose en un referente clave para la autonomía tecnológica del continente en el campo de la IA generativa.
Los pesos ya están accesibles en Hugging Face y admiten despliegue propio mediante runtimes como vLLM o SGLang. Las fichas del modelo y las condiciones de licencia se publicaron de forma simultánea, y el informe técnico completo verá la luz en breve. La ejecución en infraestructura local garantiza que la propiedad intelectual y el código confidencial de las empresas no se expongan a servicios en la nube de terceros.
Entre los socios comerciales figuran NVIDIA, Cisco, Cloudflare y CrowdStrike. En el ámbito europeo destacan ASML, Orange Cyberdefense, Crédit Agricole y la Agencia Espacial Europea (ESA). La implicación de industrias críticas y organismos de defensa demuestra la urgencia que tienen los sectores regulados por mantener el control soberano sobre su computación.
No obstante, las aspiraciones de autonomía deben superar el examen de las facturas en el centro de datos. Incluso con activación dispersa, 1,05 billones de parámetros suponen cientos de gigabytes de peso puro, por lo que el tráfico en VRAM y almacenamiento representa un coste ineludible. El soporte de clústeres propios con redes de altísimo rendimiento y elevado consumo energético supone una exigencia severa para la infraestructura física. Las organizaciones deben calcular con precisión el retorno de la inversión frente a los costes operativos a largo plazo.
 Figura: Directorio de entidades colaboradoras presentado por Mistral en semiconductores, ciberseguridad y sector aeroespacial europeo. Fuente: Blog oficial de Mistral.
Más allá de los benchmarks: el coste de inferencia decide el futuro del software abierto
La competencia en los modelos abiertos está entrando en un nuevo punto de inflexión. En las fases iniciales, el empeño radicaba en expandir el volumen de datos y encabezar las tablas de evaluación. Cuando los principales modelos convergen en porcentajes de acierto similares, el presupuesto operativo de computación pasa a ser el factor determinante. El número de tokens necesarios por unidad de entrega define si un despliegue es sostenible en el tiempo.
Le Chonk plantea un camino realista: lograr la misma calidad en la entrega de código consumiendo casi la mitad de tokens alivia de manera drástica la carga sobre el hardware. Las empresas exigen soberanía sobre sus sistemas, pero también presupuestos asumibles en el día a día. Al combinar potencia de vanguardia con un consumo más eficiente, los pesos abiertos logran por fin el pasaporte para integrarse en la producción de software a gran escala.
 Figura: «Le Chonk», la mascota oficial elegida por Mistral para este modelo insignia. Fuente: mistral.ai.
参考链接:
- Mistral 官方博客:Mistral Large 4 开源权重发布说明
- Mistral 官方博客:Mistral Large 4 模型架构与基准评测
- Hugging Face 官方权重仓库:Mistral-Large-4-1T-A52B