Una placa de desarrollo basada en microcontrolador que cabe en la palma de la mano funciona sin motor de juego ni servidores externos. Dentro del propio silicio, computa de manera autónoma las cadenas causales de un entorno físico. En el proyecto de código abierto tinyworldformer, una Raspberry Pi Pico 2 W asume por completo el bucle de predicción y toma de decisiones. Este chip, provisto de apenas 520 KB de SRAM, ejecuta simultáneamente un Transformer recurrente generador de fotogramas y una red neuronal encargada de las acciones.
Históricamente, los modelos de mundo han estado ligados a clústeres en la nube de alto consumo y miles de millones de parámetros. tinyworldformer opta por una senda ultraligera: reduce las redes a un rango de 26k a 131k parámetros, recortando la carga por fotograma a entre 2M y 8M de operaciones de multiplicación y acumulación (MAC). Cinco entornos de juegos clásicos se alojan en tan solo 4 MB de memoria Flash y 520 KB de SRAM.
El entrenamiento por aprendizaje por refuerzo transcurre íntegramente dentro de los fotogramas predichos por la propia red. El agente nunca interactúa con los motores de juego nativos. Esta simulación neuronal integral suprime la infraestructura en la nube, llevando los modelos de mundo y el aprendizaje por refuerzo al terreno de los microcontroladores. El coste asumido se refleja en la resolución gráfica y en una precisión por fotograma del 83,6% al 100%, eliminando a cambio cualquier dependencia de servidores externos.
Dos redes en espejo: el microcontrolador no ejecuta ningún juego real
El procesador RP2350 integrado en la Pico 2 W incorpora dos núcleos Cortex-M33. El sistema traza una línea divisoria física entre la actualización de pantalla y la inferencia causal. El Core 0 gestiona la comunicación USB y la salida de vídeo. El Core 1 ejecuta de forma autónoma dos redes neuronales que actúan como espejos entre sí, prescindiendo de cualquier motor de juego tradicional.
El modelo de mundo proyecta el estado del entorno hacia el futuro. Recibe como entradas el fotograma actual y la acción elegida, y predice el siguiente fotograma junto con la recompensa asociada. Su arquitectura consiste en un Transformer recurrente cuantizado en int8 con entre 26k y 131k parámetros. Cada fotograma demanda de 2M a 8M de operaciones MAC (alcanzando 8,2M en Pac-Man lite), garantizando que la inferencia en chip mantenga la cadencia del bucle de control.
El ejecutor (o actor) analiza el estado visual generado y selecciona las acciones. Diseñado como un perceptrón multicapa (MLP) de dos capas en precisión float32, posee solo entre 9k y 16k parámetros y exige de 9k a 16k operaciones MAC por fotograma, con un impacto computacional casi nulo. El ejecutor solo lee las características latentes predichas por el modelo de mundo, mientras que este último solo recibe las acciones discretas enviadas por el ejecutor.
Esta arquitectura dual habilita una intervención humana sumamente flexible. El ejecutor preentrenado de la placa puede reemplazarse en tiempo real por un agente stream-x que aprende desde cero. Si el desarrollador pulsa un botón de la placa, el control pasa de inmediato al jugador humano. Al manipular los mandos, el usuario interactúa igualmente con un mundo ficticio generado y alucinado en tiempo real por la red neuronal.
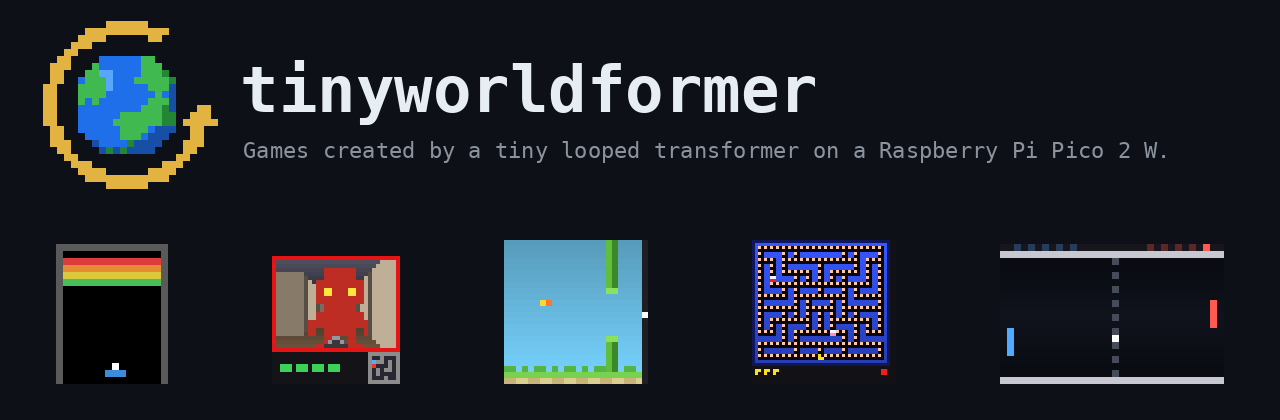 Figura: Arquitectura de tinyworldformer y visión general de las dos redes neuronales ejecutándose en el microcontrolador. Fuente: SheepSeb/tinyworldformer.
Reutilización recurrente de pesos: sacrificar latencia para ahorrar memoria
Los Vision Transformers convencionales apilan múltiples bloques para ganar capacidad representativa. Sin embargo, la memoria SRAM de un microcontrolador es incapaz de albergar conjuntos independientes de pesos por capa. tinyworldformer adopta una estructura de Transformer recurrente, manteniendo globalmente un único bloque Transformer. El modelo reutiliza este mismo conjunto de pesos de 1 a 4 veces consecutivas, reincorporando el residuo de la entrada inicial antes de cada iteración.
Durante el entrenamiento, las salidas intermedias de cada ciclo recurrente se supervisan mediante regresión contra el fotograma real posterior. En tiempo de ejecución, el número de iteraciones se transforma en un selector físico que permite canjear latencia de cálculo por precisión de inferencia. En el hardware de la Pico 2 W, para mantener una tasa de refresco interactiva, el sistema fija por defecto 2 iteraciones. Este enfoque delega la profundidad efectiva de la red en el entorno de ejecución edge.
El caso de prueba aislado de Doom-lite ilustra cómo las iteraciones mitigan de forma drástica las alucinaciones visuales. Con una sola pasada, el modelo inventa un enemigo inexistente y genera 92 cuadrículas erróneas en la escena. Al elevar la recurrencia a 2 pasadas, los errores caen a 35 celdas. Con 3 pasadas bajan a 12, y al alcanzar 4 iteraciones desaparecen por completo.
El proyecto evaluó el rendimiento en 5 títulos con 2 iteraciones recurrentes. Breakout (rejilla de 20×16) consigue un 99,99% de precisión fotograma a fotograma con 26k parámetros y 4,3M de MACs. Flappy Bird (24×24) alcanza un 100% de precisión con 46k parámetros y 2,0M de MACs. Pong (20×32) registra un 99,45% con 46k parámetros y 2,3M de MACs, modelando a la perfección la física determinista en dos dimensiones.
Los entornos que exigen seguimiento de estados profundos y renderizado pseudotridimensional muestran las limitaciones de capacidad del modelo. Pac-Man lite introduce un laberinto intrincado y dos fantasmas en una rejilla de 48×48; sus parámetros escalan a 131k y el cómputo a 8,2M de MACs, con una precisión del 86,4%. Doom-lite emplea una vista en primera persona de 32×32 en un laberinto de 8×8, requiriendo 55k parámetros y 4,2M de MACs para un 83,6% de precisión. Al rastrear estados ocultos de múltiples entidades, los modelos compactos deben asumir ciertas irregularidades locales en la imagen.
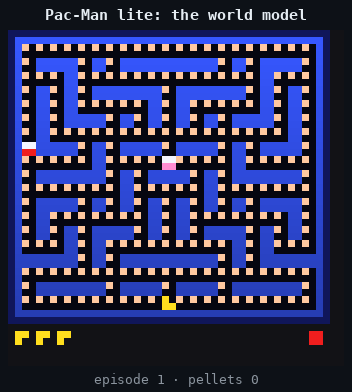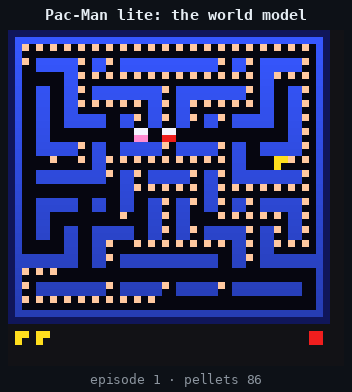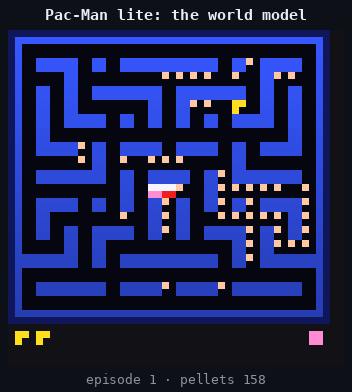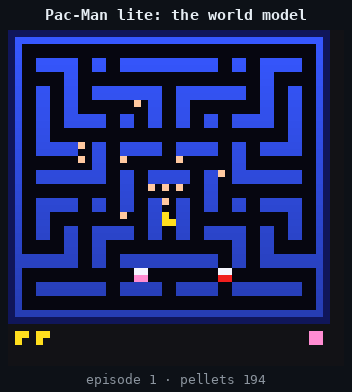 Figura: Fotogramas consecutivos de Pac-Man predichos por el modelo de mundo sin motor de juego real. Fuente: SheepSeb/tinyworldformer.
Decodificación heurística contra alucinaciones: reglas sobre distribuciones
Si se permitiera a redes neuronales ultraligeras muestrear libremente a partir de distribuciones Softmax sin restricciones, el mundo físico generado colapsaría en pocos pasos. Pac-Man podría duplicarse en la pantalla o la pelota desaparecer en pleno rebote. La decodificación cuenta con su propia sección porque las distribuciones de probabilidad brutas no generan por sí solas imágenes coherentes de juego.
La primera regla atañe al fondo estático. Celdas como muros, ladrillos, puntos y suelos eligen de manera independiente el token de mayor probabilidad (argmax). Esta decisión aislada ahorra los costes de una búsqueda global y ancla los contornos del laberinto, impidiendo deformaciones en las paredes.
La segunda regla gestiona entidades únicas (singletons). Elementos singulares como la pelota o el protagonista solo pueden seleccionarse una vez en toda la cuadrícula y entre todas las clases. La unicidad física global queda así garantizada. Ante eventos estocásticos como reapariciones o saques, el decodificador muestrea dentro de un entorno de 2,2 logits alrededor del valor óptimo, preservando la frescura dinámica sin dejar residuos de desenfoque.
La tercera regla gobierna los sprites dinámicos que ocupan bloques de 2×2 celdas. En personajes como Pac-Man o los fantasmas, solo la celda principal alberga el vector de estado (orientación de la boca o si el fantasma tapa un punto). Las tres celdas restantes se rellenan mediante plantillas predefinidas, prescindiendo de predicciones punto por punto y suprimiendo cualquier desgarro en los personajes.
Cuantización integral en int8: dos operaciones MAC por instrucción SIMD
El principal obstáculo al trasladar Transformers a microcontroladores radica en el consumo energético de las multiplicaciones matriciales en coma flotante. tinyworldformer cuantiza todas las matrices de pesos del modelo de mundo a números enteros int8. La red calcula factores de escala de forma independiente por cada fila de salida (scale = max|w| / 127). Los tensores de activación también se cuantizan en int8, asignándose escalas dedicadas según el tensor y la iteración recurrente.
El núcleo Cortex-M33 del RP2350 proporciona instrucciones específicas para acelerar operaciones enteras. Una sola lectura de 32 bits en memoria recupera 4 pesos, SXTB16 desempaqueta los bytes en dos pares de 16 bits, y la instrucción SMLAD resuelve dos operaciones de multiplicación y acumulación en un registro de 32 bits en un único ciclo (los mecanismos de atención emplean UXTB16 para probabilidades uint8 × valores int8). Una vez finalizada la acumulación en int32, solo se aplica un reescalado en coma flotante multiplicando por los factores de escala. En combinación con una tabla de consulta precalculada de 1024 entradas para calcular Softmax sobre uint8, el sistema prescinde de los costosos cálculos flotantes continuos.
La unidad de coma flotante por hardware (FPU) del RP2350 no permanece ociosa. Las normalizaciones LayerNorm, la adición de conexiones residuales y los embeddings de entrada se mantienen en precisión float32. Estas operaciones representan una porción mínima del cómputo global. Conservar el formato flotante en estas fases previene la acumulación de errores numéricos profundos, aunando la aceleración de punto fijo con la estabilidad numérica.
La alta fidelidad del esquema responde a la estricta concordancia entre entrenamiento y despliegue. Durante el entrenamiento, la técnica de entrenamiento consciente de la cuantización (QAT) con estimadores directos (STE) introduce el mismo redondeo entero que en hardware; lo que se entrena es idéntico a lo que se ejecuta. El módulo de exportación rustexport/intref.py congela el orden de operaciones en NumPy. El motor de inferencia en Rust sobre el microcontrolador reproduce la referencia bit a bit, eliminando desvíos numéricos entre plataformas.
 Figura: Esquema de cuantización int8 por filas y por iteración recurrente para matrices y valores de activación. Fuente: SheepSeb/tinyworldformer.
Cero asignaciones en el heap: 520 KB de SRAM blindados para simulación local
Los sistemas embebidos no admiten fallos por falta de memoria. El análisis del binario ELF con size -A revela que Breakout ocupa 361 KB de Flash y 299 KB de RAM; Flappy Bird, 409 KB y 227 KB; Pong, 414 KB y 244 KB. Doom-lite consume 471 KB y 357 KB, mientras que Pac-Man lite registra 600 KB de Flash y 460 KB de RAM. Todo el firmware encaja sin problemas dentro de los 4 MB de Flash y 520 KB de SRAM de la Pico 2 W.
El desglose de la memoria demuestra un hecho paradójico: en todo el modelo de mundo, los pesos cuantizados en int8 representan apenas entre 19,7 KB y 33,9 KB. Por contra, los embeddings en float32, los parámetros de normalización y las matrices de escala absorben la mayor parte de la memoria, situándose entre 31,6 KB y 91,9 KB. La huella de almacenamiento se concentra principalmente en las capas de adaptación periférica y no en el núcleo computacional.
Para asegurar una estabilidad operativa absoluta, el firmware se desarrolló en no_std Rust junto con el framework asíncrono Embassy. El sistema logra cero asignaciones dinámicas en el heap a lo largo de todo su ciclo de vida. Todos los pesos del modelo residen en la Flash como matrices static, mientras que los búferes de activación y memoria de vídeo se preasignan en la RAM como estructuras estáticas de tamaño fijo. Eliminar la gestión dinámica del montículo erradica el riesgo de fragmentación y cuelgues por agotamiento de memoria.
Los pesos y trazas de elegibilidad del agente stream-x integrado requieren solo entre 49 KB y 106 KB, operando con seguridad en memoria estática. La arquitectura asíncrona de doble núcleo asegura una interacción fluida. El Core 1 procesa cíclicamente la extracción de características, selección de acciones, 2 iteraciones de inferencia recurrente, decodificación heurística y predicción de recompensas. Los datos se transmiten al Core 0 a través de un canal con búfer doble; si el Core 0 está ocupado, descarta fotogramas de forma inteligente para impedir que el Core 1 se detenga.
En procesadores x86 convencionales, este motor en Rust procesa cada fotograma en apenas 0,7 ms (Flappy Bird) o 1,5 ms (Breakout). Aunque en la Pico 2 W no se cronometraron milisegundos brutos, ralentizar la tasa de fotogramas a entre 66 ms y 150 ms proporciona una experiencia interactiva fluida para un jugador humano. Los cinco entornos están disponibles como código abierto en el repositorio SheepSeb/tinyworldformer, con soporte para ejecución en terminal vía uv y una demo funcional mediante WebAssembly en el navegador.
Los modelos de mundo no tienen por qué confinarse en macrocentros de datos en la nube. tinyworldformer demuestra una nueva vía: combinando reutilización temporal de pesos con instrucciones SIMD de punto fijo, un microcontrolador puede albergar con éxito simulaciones físicas complejas. Aceptando una resolución ajustada a cambio de una autonomía total sin servidores, unos pocos cientos de kilobytes resultan suficientes para contener un entorno físico interactivo gobernado por inteligencia artificial.
Enlaces de referencia:
- Blog de SheepSeb: Análisis técnico e implementación de tinyworldformer
- Repositorio en GitHub: SheepSeb/tinyworldformer