Nueve grandes modelos comparten el mismo vicio de estilo
El 21 de octubre de 2026, los investigadores Thomas Hikaru Clark, Matias B. Martin y Kyle Mahowald publicaron en arXiv el artículo 2610.29162 dentro de la categoría de Computación y Lenguaje (cs.CL). Esta investigación disecciona con precisión el agotamiento que experimenta cualquier usuario al leer textos redactados por IA. La escena es conocida: al abrir un informe redactado por un chatbot, cada término individual es reconocible, pero el conjunto resulta árido y difícil de procesar. El equipo evaluó nueve modelos punteros y semipunteros del mercado y comprobó que esta barrera de legibilidad impregna toda la industria, debido a mecanismos de evaluación que expulsaron la claridad del proceso.
Para analizar el comportamiento de la IA, los autores crearon un corpus textual que abarca diálogos cotidianos, explicaciones de código fuente y redacciones abiertas. Realizaron llamadas masivas a APIs a través de plataformas como Amazon Bedrock; la Tabla 1 del apéndice detalla incluso el coste por millón de tokens de entrada y salida. Ante este diagnóstico común, ningún modelo quedó a salvo. En bloque, abandonaron los hábitos comunicativos consolidados por la humanidad a lo largo de milenios para adoptar un estilo de máquina denso y artificial.
Al examinar las estructuras sintácticas, los nueve modelos recurrieron de forma desproporcionada al patrón «sujeto inanimado + verbo animado». Mientras un redactor humano diría: «Los ingenieros utilizaron este algoritmo para detectar vulnerabilidades», la IA prefiere escribir: «Este algoritmo examina y captura vulnerabilidades potenciales». Al mismo tiempo, todos los modelos abusaron de n-gramas de baja frecuencia: combinaciones inusuales de varias palabras que rara vez aparecen juntas de forma espontánea. En lugar de apoyarse en giros idiomáticos naturales, buscaron combinaciones forzadas y excesivamente formales.
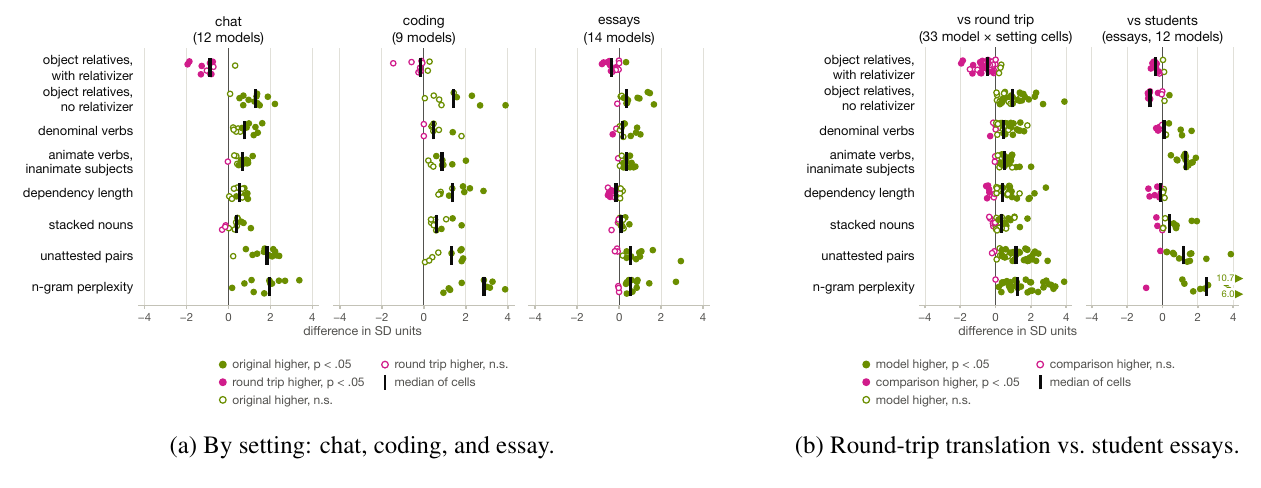 Figura: Figura 3 del artículo, resumen de la evolución de rasgos lingüísticos según el entorno. Cuanto más alta es la barra, con mayor frecuencia recurre el modelo a dicha estructura. Fuente: arXiv:2610.29162
La memoria de trabajo saturada por frases interminables: la traducción automática queda libre de culpa
En situaciones de conversación, la mayoría de los modelos mostraron otros tres malos hábitos: distancias de dependencia (Dependency Distance) dilatadas, acumulación abusiva de nombres compuestos (Noun Compounding) y oraciones de relativo de objeto reducidas (Reduced Object Relative Clauses). La mente humana lee como un operario con una bandeja de clasificación: al detectar un sujeto, debe sostenerlo en la memoria de trabajo hasta localizar el verbo principal y descargar la carga cognitiva. La IA tiende a introducir largas cadenas de complementos entre el sujeto y el verbo, estirando al máximo esa distancia; además, elimina conjunciones y nexos, encajando subordinadas unas dentro de otras como muñecas rusas.
Durante años, este estilo enrevesado se achacó a la «jerga de traducción automática», considerándolo un vestigio de los datos multilingües de entrenamiento. Para poner a prueba esta hipótesis, los investigadores diseñaron un experimento de control con el modelo de traducción de código abierto NLLB-200. Tomaron textos escritos por personas, los tradujeron al japonés y luego los volvieron a traducir al inglés. Esta traducción de ida y vuelta conservaba la estructura lógica humana, añadiendo únicamente el barniz de la transposición automática.
El resultado desmintió por completo la culpa de los traductores. Los nueve grandes modelos mostraron una dependencia de estas estructuras complejas mucho mayor que las versiones retraducidas con NLLB-200. La simple traducción automática no genera tropiezos de lectura tan intensos. El verdadero causante de este estilo denso e intrincado son las preferencias pragmáticas que los propios modelos adquirieron durante el postentrenamiento.
Cómputo enfocado a maximizar puntuaciones: al lector solo le llega el archivo comprimido
¿Por qué sistemas tan avanzados insisten en generar oraciones tan incómodas? El artículo apunta a una distorsión en la presión selectiva. A lo largo de la evolución del lenguaje humano, el único juez era el interlocutor al otro lado; las oraciones se pulían de forma natural para garantizar el éxito de la comunicación. En cambio, los modelos actuales se enfrentan en su campo de entrenamiento a evaluadores muy distintos: baterías de problemas matemáticos, compiladores de código y puntuadores automáticos.
Al volcar el peso del entrenamiento en las matemáticas, la programación y el razonamiento formal, la presión se concentró exclusivamente en elevar la densidad informativa. El estudio agrupó los modelos en cuatro familias: modelos base pre-frontera, modelos frontera con postentrenamiento intensivo, modelos semipunteros de pesos abiertos y la serie GPT. Las firmas sintácticas mostraron diferencias notables: cuanto más agresivo era el postentrenamiento y mayor el afán por obtener puntuaciones altas, más densos eran los bloques de sustantivos apilados.
En los debates de Hacker News se trazó un paralelismo con el correo profesional: los mensajes de trabajo habituales en Gmail contienen un promedio de 1.3 peticiones o cuestiones por frase. La prosa humana también puede ser compacta, pero esa compresión busca que el destinatario comprenda rápido y responda con facilidad. La compresión de la IA, por el contrario, responde únicamente a empaquetar la mayor cantidad de respuestas correctas. Trata cada frase como un archivo comprimido a alta tasa, sin importar si descomprimirla satura la mente del lector, ya que la carga cognitiva no figura en la rúbrica del examinador.
Basta cambiar una regla de penalización para que la IA transforme su modo de escribir
Si la falta de claridad surge de objetivos de entrenamiento distorsionados, ¿basta con retocar la meta para que cambie el estilo de inmediato? El equipo diseñó una prueba de concepto: durante la fase de aprendizaje por refuerzo (RL), introdujeron una sencilla penalización por longitud (Length Penalty), restando puntos cada vez que el texto se alargaba en exceso.
El resultado se observa claramente en la Figura 7 del estudio. En cuanto se aplicó la penalización por longitud, los patrones lingüísticos del modelo se desviaron drásticamente del comportamiento humano habitual. Con el fin de concentrar los mismos puntos de evaluación en menos palabras, el modelo eliminó nexos de manera todavía más agresiva, encadenó sustantivos sin descanso y llevó la densidad informativa de cada oración al límite.
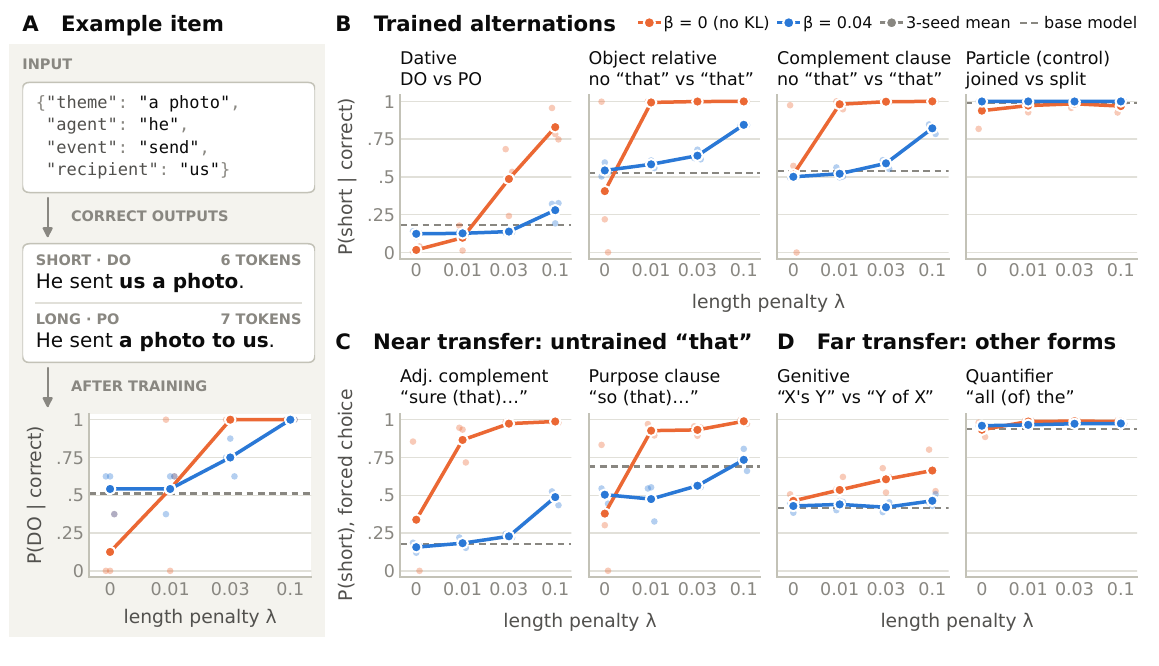 Figura: Figura 7 del artículo. Al imponer una penalización por longitud en el aprendizaje por refuerzo, las preferencias lingüísticas del modelo se apartan de inmediato de las normas humanas. Fuente: arXiv:2610.29162
Este experimento echó por tierra la idea de que la capacidad lingüística de la IA se haya estancado. Los modelos poseen la capacidad de generar un lenguaje fluido, natural y accesible; si recurren a términos opacos y fórmulas rígidas es porque la batuta de recompensas del aprendizaje por refuerzo apuntaba en esa dirección. Hacia donde señale el objetivo de optimización, hacia allí se moverá el estilo del modelo. La legibilidad fue la moneda de cambio sacrificada en la carrera por los primeros puestos.
Los evaluadores premian las respuestas de examen y la claridad resulta sacrificada
Otra observación compartida en la comunidad tecnológica completa el cuadro del entrenamiento. El postentrenamiento mediante aprendizaje por refuerzo (RL Post-training) arrastra un sesgo determinante: premia con regularidad las respuestas que tienen el aspecto visual de una solución modelo. Los evaluadores humanos suelen calificar en pocos segundos tras un vistazo rápido, mientras que los modelos de evaluación automática aplican pautas rígidas. Los párrafos estructurados y cargados de terminología técnica se aseguran casi siempre la mejor nota.
Con el paso del tiempo, esta estrategia para seducir a los examinadores quedó fijada en los pesos de los modelos. Aunque el usuario simplemente pida redactar un mensaje informal o aclarar un concepto básico, el modelo recurre de forma refleja al tono de una prueba académica, poblando las frases de sujetos inanimados y complejas subordinadas reducidas.
Que leer los textos generados por IA resulte agotador no guarda relación con una supuesta pérdida de inteligencia. Desde la comparativa de los nueve modelos en arXiv:2610.29162 hasta los ensayos de penalización por longitud de la Figura 7, todas las evidencias coinciden: los grandes modelos se esfuerzan al máximo por complacer a los sistemas automáticos de evaluación internos, mientras se olvidan por completo de las personas reales que intentan leer en la pantalla.
Enlaces de referencia:
- Artículo en arXiv: Why is AI-generated language so hard to understand? (arXiv:2610.29162)
- Debate en la comunidad de Hacker News