Neun führende Modelle leiden am selben stilistischen Syndrom
Am 21. Oktober 2026 reichten die Forscher Thomas Hikaru Clark, Matias B. Martin und Kyle Mahowald ihr Paper (arXiv:2610.29162) in der Kategorie Computation and Language (cs.CL) ein. Die Untersuchung seziert genau jenes Gefühl der kognitiven Erschöpfung, das viele Menschen beim Lesen KI-generierter Texte beschleicht. Die Erfahrung ist vertraut: Man liest einen Bericht eines Chatbots, jedes einzelne Wort ist verständlich, doch im Zusammenhang wirkt der Text trocken und unzugänglich. Die Autoren untersuchten neun führende und seriennahe Sprachmodelle auf dem Markt und stellten fest: Die mangelnde Lesbarkeit ist ein branchenweites Phänomen, dessen Ursache in Bewertungsmechanismen liegt, die Verständlichkeit systematisch verdrängt haben.
Um die Sprachmuster der KI präzise zu erfassen, bauten die Autoren ein domänenübergreifendes Textkorpus auf, das Alltagskonversationen, Code-Analysen und freie Essay-Aufgaben umfasst. Über Plattformen wie Amazon Bedrock führten sie umfangreiche API-Aufrufe durch; in Tabelle 1 des Anhangs sind sogar die genauen API-Kosten pro Million Token für Input und Output aufgeschlüsselt. Bei dieser standardisierten Untersuchung zeigte kein einziges Modell eine Ausnahme. Kollektiv verwarfen sie die Kommunikationsgewohnheiten, die sich in Zehntausenden Jahren menschlicher Evolution herausgebildet hatten, und eigneten sich einen überdichteten Maschinenstil an.
Bei genauerer Betrachtung der Satzstrukturen fällt auf, dass alle neun Modelle signifikant häufiger unbeseelte Subjekte mit Handlungsverben kombinieren. Wo ein Mensch intuitiv formuliert: „Die Ingenieure nutzten diesen Algorithmus, um Sicherheitslücken aufzuspüren“, schreibt die KI bevorzugt: „Dieser Algorithmus untersucht und erfasst potenzielle Schwachstellen.“ Gleichzeitig häuften sämtliche Modelle seltene N-Gramme an – also ungewöhnliche Wortkombinationen, die im natürlichen Sprachgebrauch kaum vorkommen. Statt auf bewährte Alltagssprache zurückzugreifen, reihen sie gezielt gestelzte Schriftsprache aneinander.
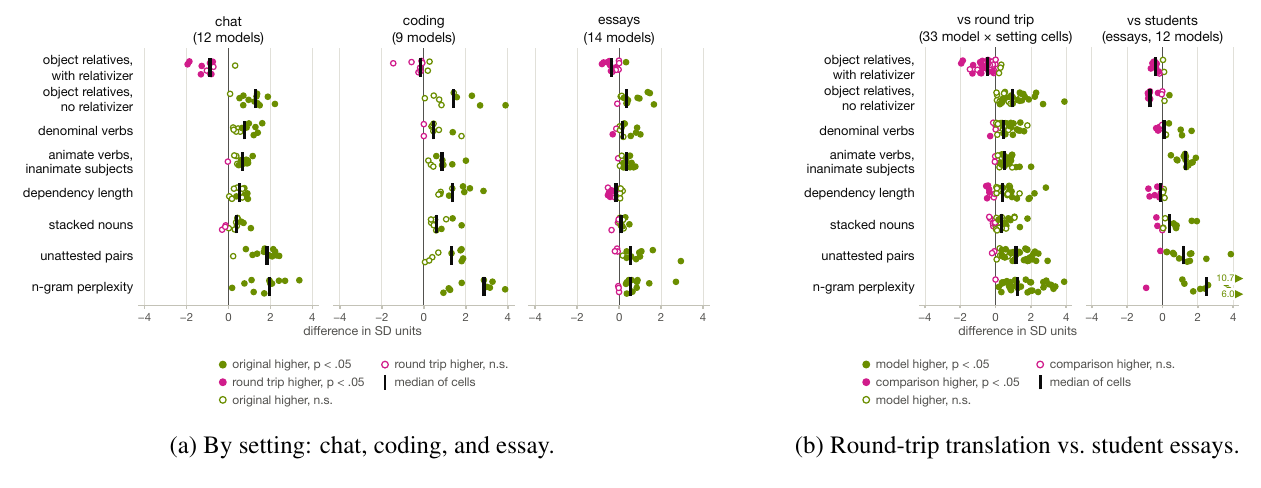 Abbildung: Abbildung 3 der Studie, Übersicht über die Veränderung sprachlicher Merkmale unter verschiedenen Bedingungen. Je höher der Balken, desto häufiger nutzt das Modell diese Struktur. Quelle: arXiv:2610.29162
Arbeitsgedächtnis durch verschachtelte Sätze überlastet: Freispruch für die Übersetzungs-KI
In dialogischen Szenarien zeigten die meisten Modelle drei weitere sprachliche Schwachstellen: stark vergrößerte Abhängigkeitsdistanzen (Dependency Distance), exzessive Substantivkombinationen (Noun Compounding) sowie reduzierte Objektrelevanzsätze (Reduced Object Relative Clauses). Das menschliche Gehirn liest wie ein Sortierer mit einem Ablagetablett: Trifft es auf ein Subjekt, muss es dieses im Arbeitsspeicher bereithalten, bis das Prädikatsverb folgt und die kognitive Last entladen werden kann. LLMs schieben jedoch oft lange Kaskaden von Modifikatoren zwischen Subjekt und Verb. Zudem streichen sie Relativpronomen und Verbindungswörter, sodass sich Teilsätze wie russische Matrjoschkas ineinander verkeilen.
Lange Zeit schob man solche sperrigen Konstruktionen auf typische „Übersetzungsartefakte“ und vermutete Nachwirkungen mehrsprachiger Trainingsdaten. Um diese These zu prüfen, führte das Team ein Kontrollexperiment mit dem quelloffenen Modell NLLB-200 durch. Sie ließen von Menschen verfasste Texte ins Japanische und anschließend wieder zurück ins Englische übersetzen. Dieses Hin-und-Her-Übersetzen behält das rhetorische Grundgerüst des menschlichen Originals bei, legt aber eine typische Schicht maschineller Sprachumwandlung darüber.
Das Ergebnis entlastete die Übersetzungswerkzeuge vollständig. Die untersuchten neun Großmodelle verließen sich ungleich stärker auf diese sperrigen Konstruktionen als das NLLB-200-Modell im Rückübersetzungstest. Eine bloße Maschinenübersetzung erzeugt keine derart massiven Barrieren für den Lesefluss. Die eigentliche Ursache für die hölzerne Schwerfälligkeit sind pragmatische Präferenzen, die sich die Modelle im Post-Training selbst angeeignet haben.
Rechenkraft für Benchmark-Punkte verpulvert: Dem Leser bleibt nur das Datenpaket
Warum erzeugen hochentwickelte Modelle derart anstrengende Sätze? Die Autoren führen dies auf eine Fehlleitung des evolutionären Selektionsdrucks zurück. Über die Jahrtausende der Sprachentwicklung war der einzige Maßstab das Gegenüber am Tisch; syntaktische Strukturen dienten primär gelingender Kommunikation. Heutige Sprachmodelle begegnen im Trainingsprozess jedoch einer völlig anderen Jury: mathematischen Testbatterien, Code-Compilern und automatischen Bewertungssystemen.
Mit der Verschiebung des Schwerpunkts auf Mathematik, Programmierung und formale Logik konzentrierte sich der Optimierungsdruck fast ausschließlich auf maximale Informationsdichte. Die Studie unterscheidet vier Modellfamilien: Pre-Frontier-Basismodelle, intensiv nachbearbeitete Frontier-Modelle, Open-Weight-Modelle und die GPT-Reihe. Die syntaktischen Profile variieren deutlich: Je aggressiver das Post-Training und je stärker die Ausrichtung auf Benchmark-Scores, desto kompakter und undurchdringlicher türmten sich die Substantivblöcke.
In Diskussionen auf Hacker News zogen Nutzer Vergleiche zu beruflicher E-Mail-Kommunikation: Auch geschäftliche E-Mails in Gmail enthalten im Schnitt rund 1,3 Anfragen oder Aufgaben pro Satz. Professionelle menschliche Texte sind ebenfalls verdichtet, doch diese Verdichtung dient dem Ziel, dass der Empfänger den Inhalt rasch erfassen und handeln kann. Die Verdichtung der KI hingegen dient allein der maximalen Testantwortdichte. Sie verschnürt jeden Satz zu einem hochkomprimierten Datenpaket – ohne Rücksicht darauf, ob das Entpacken das Gehirn des Lesers überfordert, denn kognitive Last steht in keinem Prüfungsraster.
Eine einzige Abzugsregel ändert den gesamten Sprachstil der KI
Wenn die mangelnde Lesbarkeit auf verfehlte Trainingsmetriken zurückgeht: Lässt sich der Stil durch Anpassung des Ziels unmittelbar korrigieren? Das Forschungsteam überprüfte dies in einem Machbarkeitsexperiment. In die Phase des bestärkenden Lernens (RL, Reinforcement Learning) bauten sie eine einfache Längenstrafe (Length Penalty) ein: Wurde eine Antwort zu lang, gab es Punktabzug.
Das Resultat zeigt Abbildung 7 des Papers. Sobald die Längenstrafe griff, drifteten die sprachlichen Muster der Modelle drastisch von menschlichen Normalwerten ab. Um dieselbe Menge an bewertbaren Fakten auf engstem Raum unterzubringen, strichen die Modelle Verbindungswörter noch rigoroser, stapelten Komposita und trieben die Informationsdichte einzelner Sätze auf die Spitze.
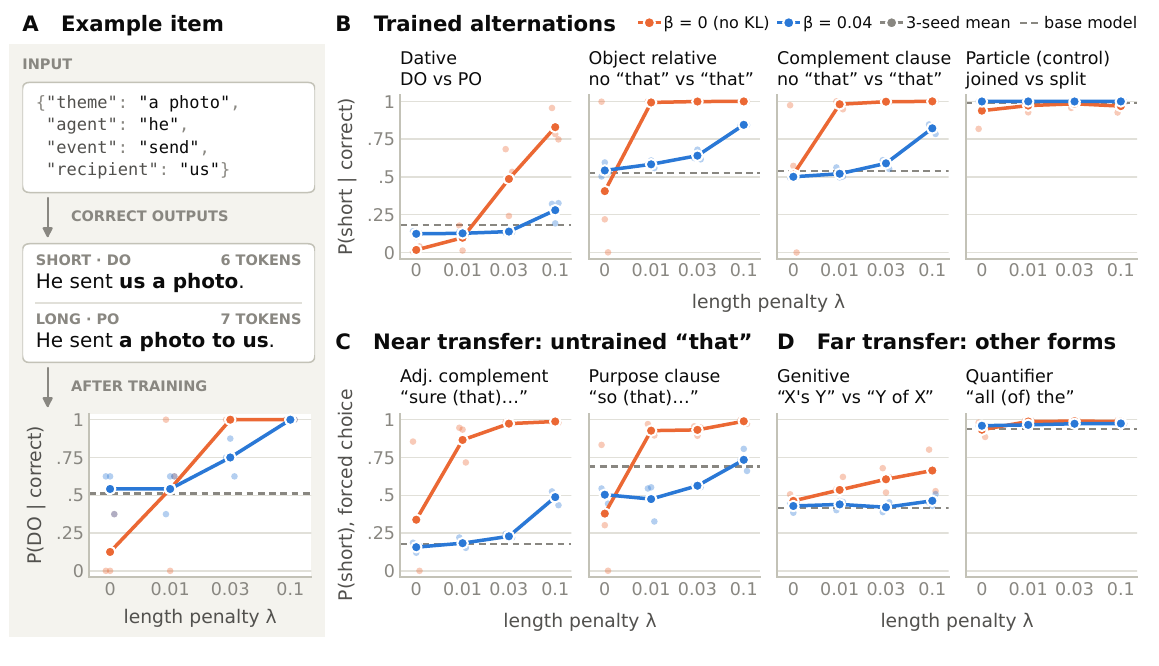 Abbildung: Abbildung 7 der Studie zeigt, wie eine einfache Längenstrafe im Reinforcement Learning dazu führt, dass die Sprachpräferenzen rasant vom menschlichen Verhalten abweichen. Quelle: arXiv:2610.29162
Dieser Versuch widerlegt den Eindruck, die sprachlichen Fähigkeiten der Modelle seien an eine Obergrenze gestoßen. Die Modelle verfügen grundsätzlich über das Rüstzeug, flüssige und leicht zugängliche Prosa zu formulieren. Dass sie sich stattdessen in starren, jargonreichen Konstruktionen verfangen, liegt schlicht an den Anreizen der Reward-Systeme. Wohin das Optimierungsziel steuert, dorthin folgt der Stil des Modells. Lesbarkeit wurde im Wettlauf um Spitzenwerte auf den Bestenlisten als erstes geopfert.
Noten für Musterantworten: Lesbarkeit bleibt auf der Strecke
Ein weiterer Gedanke aus der Fachdiskussion vervollständigt das Bild der Trainingspipeline: Das moderne RL-Post-Training belohnt systematisch Formulierungen, die optisch und strukturell einer Musterlösung gleichen. Menschliche Prüfer überfliegen Textpassagen oft in wenigen Sekunden, und KI-Prüfmodelle bewerten nach schematischen Rastern. Sauber strukturierte, fachbegriffüberladene Absätze schneiden dabei fast immer überdurchschnittlich ab.
Mit der Zeit brennt sich diese Strategie zur Befriedigung der Prüfsysteme fest in die Modellgewichte ein. Selbst wenn Nutzer lediglich um eine formlose E-Mail oder die Erklärung alltäglicher Sachverhalte bitten, greift das Modell reflexartig auf den Duktus einer Prüfungsarbeit zurück, gespickt mit unbeseelten Subjekten und verschachtelten Nebensätzen.
Dass KI-Texte immer mühsamer zu lesen sind, hat nichts mit schwindender Modellintelligenz zu tun. Von der Bestandsaufnahme der neun Modelle in arXiv:2610.29162 bis hin zum Längenstrafen-Experiment in Abbildung 7 belegen alle Befunde dasselbe Fazit: Große Sprachmodelle tun alles, um automatisierte Prüfer im Hintergrund zufriedenzustellen – während die Menschen vor dem Bildschirm das Nachsehen haben.
Weiterführende Links:
- arXiv-Studie: Why is AI-generated language so hard to understand? (arXiv:2610.29162)
- Diskussion auf Hacker News