주요 9개 모델에 공통으로 나타난 문체 이상 현상
2026년 10월 21일, Thomas Hikaru Clark, Matias B. Martin, Kyle Mahowald 연구팀은 논문(arXiv:2610.29162)을 계산과 언어(cs.CL) 분야에 공개했습니다. 이번 연구는 AI 텍스트를 읽을 때 사용자들이 겪는 답답함과 피로감을 본격적으로 분석했습니다. 챗봇이 작성한 보고서를 읽다 보면, 단어 하나하나는 다 아는 말인데 전체 문장이 모래를 씹듯 머리에 와닿지 않는 경험을 누구나 겪어보았을 것입니다. 연구진이 시중의 프론티어 및 준프론티어 대형 모델 9종을 실측한 결과, 읽기 어려운 문제는 업계 전반에 퍼져 있었으며, 그 원인은 훈련 채점 구조가 가독성을 뒷전으로 밀어냈기 때문이었습니다.
AI의 언어적 특성을 파악하기 위해 저자들은 일상 대화, 코드 분석, 자유 작문을 아우르는 도메인 교차 텍스트 말뭉치를 직접 구축했습니다. Amazon Bedrock 등의 플랫폼에서 대량의 API 호출을 수행했으며, 논문 부록 표 1에는 100만 입력 및 출력 토큰당 API 비용까지 상세히 기록했습니다. 이 표준화된 테스트 결과 9개 모델 모두 예외 없이 동일한 양상을 보였습니다. 인류가 수만 년 동안 진화시켜 온 자연스러운 의사소통 습관을 버리고, 정보만 빽빽하게 채워 넣은 기계적 문체에 갇혀버린 것입니다.
구체적인 구문을 살펴보면, 9개 모델 모두 ‘무생물 주어 + 유정물 동사’ 구조를 비정상적으로 자주 사용했습니다. 사람이 보통 “엔지니어가 이 알고리즘을 사용해 취약점을 찾아냈다”라고 쓸 문장을, AI는 굳이 “이 알고리즘이 잠재적 취약점을 검토하고 포착했다”라고 씁니다. 동시에 9개 모델 전부 극히 드문 저빈도 n-그램(연속된 단어 조합 중 사용 빈도가 매우 낮은 표현)을 과도하게 나열했습니다. 일상적인 어휘를 마다하고 지나치게 굳은 문어체 표현을 억지로 이어 붙인 것입니다.
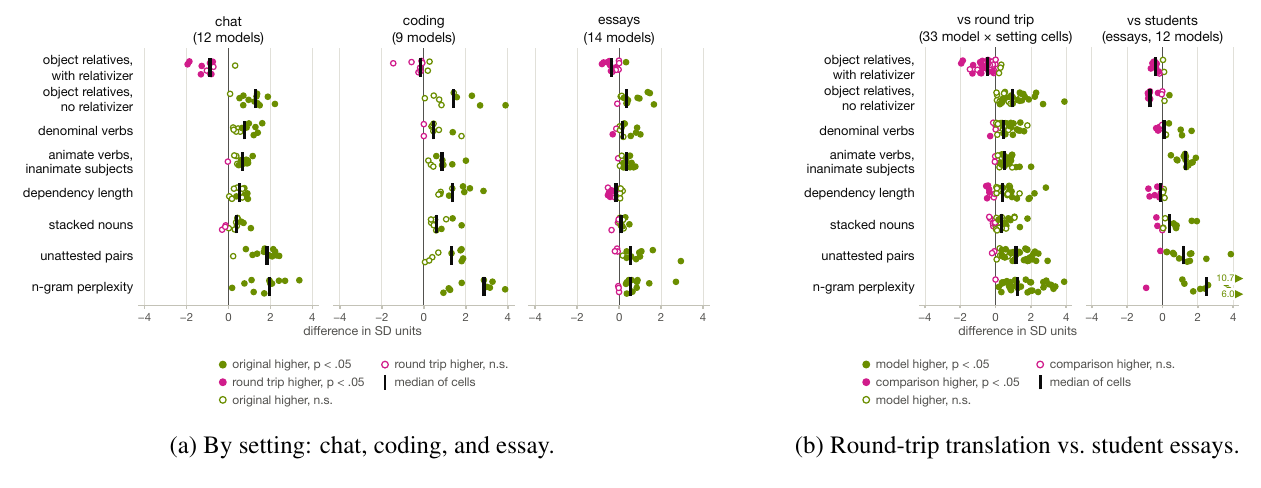 그림: 논문 그림 3, 설정별 언어적 특징 변화 요약. 막대가 높을수록 해당 모델이 그 특징을 더 빈번하게 사용했음을 의미. 출처: arXiv:2610.29162
긴 문장 구조에 짓눌린 작업기억, 번역기 누명 벗다
대화 환경에서 대다수 모델은 세 가지 악습을 추가로 드러냈습니다. 긴 의존 관계 거리(Dependency Distance), 과도한 복합명사 나열(Noun Compounding), 목적격 관계대명사 생략 구문(Reduced Object Relative Clauses)입니다. 인간의 뇌가 글을 읽을 때는 쟁반을 든 분류 작업자처럼 작동합니다. 주어를 접하면 서술어 동사를 발견할 때까지 쟁반에 주어를 올려둔 채 유지해야 하며, 동사를 만나야 비로소 인지적 짐을 내려놓을 수 있습니다. 하지만 AI는 주어와 동사 사이에 수식어를 잔뜩 집어넣어 의존 거리를 끝없이 늘려놓았고, 접속사까지 생략해 여러 겹의 문장을 마치 러시아 인형처럼 얽어놓았습니다.
이처럼 부자연스러운 문장을 두고 이전에는 ‘기계 번역투’의 문제라거나 다국어 학습 데이터로 인한 부작용으로 돌리곤 했습니다. 이 가설을 확인하기 위해 연구팀은 오픈소스 번역 모델인 NLLB-200을 활용해 대조 실험을 진행했습니다. 사람이 작성한 영문 텍스트를 먼저 일본어로 번역한 뒤, 다시 영어로 역번역하는 방식을 적용했습니다. 이러한 왕복 번역은 인간 고유의 글 구조를 유지하면서 기계 번역 특유의 표현 껍질만 덧씌우게 됩니다.
실험 결과는 번역기의 누명을 완전히 벗겨주었습니다. 9개 대형 모델이 복잡한 구문에 의존하는 정도는 NLLB-200의 일본어 왕복 번역본보다 훨씬 심각했습니다. 단순한 기계 번역 과정만으로는 이처럼 극단적인 독해 피로를 만들어낼 수 없습니다. 문장을 이토록 뻑뻑하고 난해하게 만든 진짜 범인은 사후 학습 과정에서 모델 스스로 체득한 언어 운용 편향이었습니다.
벤치마크 점수에만 쏟아부은 연산 자원, 독자에게 남겨진 압축 파일
뛰어난 성능의 모델들이 왜 굳이 읽기 힘든 문장을 쏟아내는 것일까요? 논문은 진화적 압력의 왜곡을 지적합니다. 수만 년의 언어 역사 속에서 유일한 심사위원은 맞은편에서 말을 듣는 청자였으며, 문장은 ‘원활한 소통’을 위해 자연스레 다듬어졌습니다. 그러나 오늘날 대형 모델들이 훈련장에서 마주하는 심사위원은 수학 문제집, 코드 컴파일러, 자동 평가 점수기입니다.
학습 중심축이 수학, 프로그래밍, 추론으로 옮겨가면서 최적화 압력은 온전히 ‘정보 밀도’에 쏠렸습니다. 논문은 분석 대상을 사전 프론티어 기초 모델, 대규모 사후 훈련을 거친 프론티어 모델, 오픈 가중치 준프론티어 모델, 그리고 GPT 제품군 등 4대 계열로 나누었습니다. 네 계열의 구문 구조 지문은 뚜렷한 차이를 보였으며, 사후 훈련 강도가 높고 추론 벤치마크 점수를 더 노골적으로 추구한 모델일수록 명사 벽돌을 훨씬 두텁게 쌓아 올렸습니다.
Hacker News 커뮤니티 토론에서는 실제 업무 이메일과의 비교가 이루어졌습니다. Gmail에서 오가는 전문적인 업무 메일도 문장당 평균 약 1.3개의 질문이나 요청을 담고 있습니다. 인간의 전문적인 글쓰기도 밀도가 높지만, 그 압축은 수신자가 신속하게 파악하고 답장할 수 있도록 돕는 데 맞춰져 있습니다. 반면 AI의 압축은 오직 정답 밀도를 높이는 데만 쓰입니다. 모든 문장을 고배율 압축 파일처럼 포장할 뿐, 독자가 이를 풀 때 뇌에 과부하가 걸리는지 여부는 평가기의 채점 기준표에 전혀 반영되지 않습니다.
감점 기준 하나 바꿨을 뿐인데, 순식간에 달라진 말씨
읽기 어려운 원인이 훈련 목표의 왜곡 때문이라면, 목표 기준을 살짝 바꾸는 것만으로도 문체가 달라질 수 있을까요? 연구팀은 이를 확인하기 위해 개념 검증 실험을 진행했습니다. 강화학습(RL) 단계에 출력이 길어질 경우 점수를 깎는 간단한 ‘길이 페널티(Length Penalty)’ 규칙을 추가한 것입니다.
결과는 논문 그림 7에 명확하게 드러났습니다. 길이 페널티가 부여되자마자 모델의 언어적 선호는 인간의 정상적인 의사소통 궤적에서 급격하게 벗어났습니다. 더 짧은 분량 안에 동일한 배점 요소를 욱여넣기 위해, 모델은 접속사를 더욱 가혹하게 쳐내고 복합명사를 닥치는 대로 이어 붙여 단일 문장의 정보 농도를 한계치까지 밀어붙였습니다.
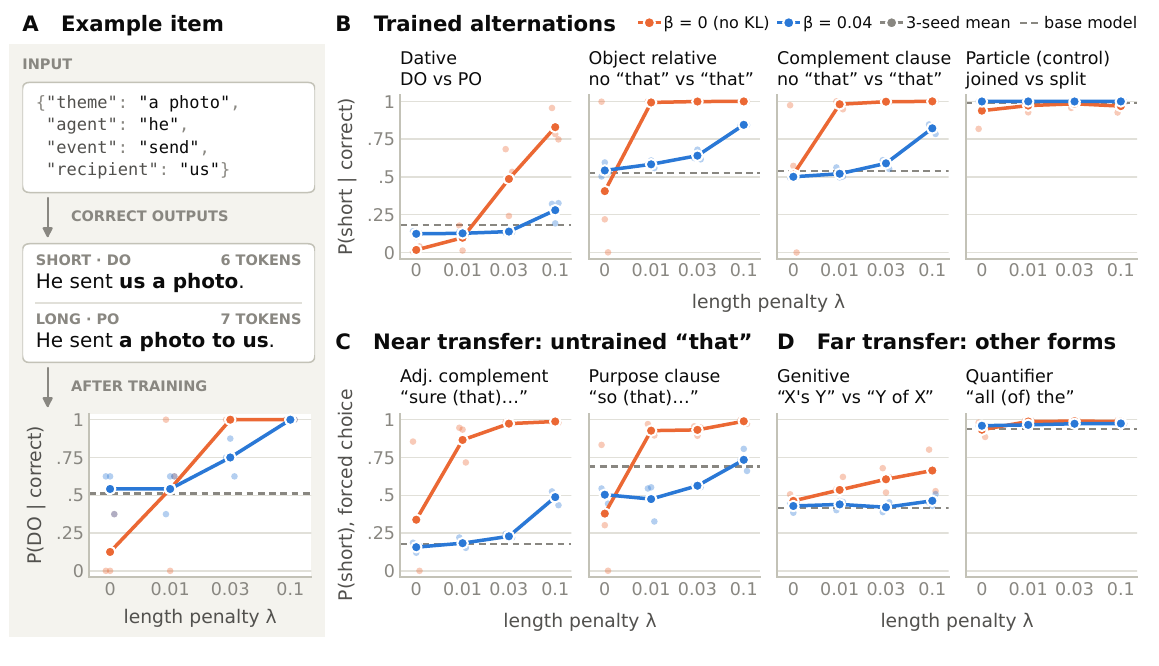 그림: 논문 그림 7, 강화학습에 ‘글을 짧게 쓰라’는 페널티를 주자 모델의 언어 선호도가 인간의 기준에서 급격히 멀어지는 모습. 출처: arXiv:2610.29162
이 실험은 ‘AI 언어 능력이 한계에 부딪혔다’는 오해를 단번에 해소했습니다. 모델은 원래 자연스럽고 매끄러운 일상어를 구사할 기본 역량을 갖추고 있었습니다. 어려운 전문용어와 경직된 구문만을 고집했던 것은, 순전히 강화학습의 보상 채찍이 그 방향을 향해 휘둘러졌기 때문입니다. 최적화 목표가 가리키는 곳으로 모델의 문체는 그대로 따라갑니다. 높은 점수를 따내기 위한 경쟁 속에서 가독성은 가장 먼저 버려진 협상 카드였습니다.
모범 답안만 편애하는 채점기, 끝내 희생된 가독성
커뮤니티 토론에서 나온 또 다른 통찰은 훈련 과정의 마지막 퍼즐을 맞춰줍니다. 오늘날 강화학습 사후 훈련(RL Post-training)은 한 가지 뚜렷한 편향을 지니고 있습니다. 바로 ‘모범 답안의 형식을 갖춘 글’에 높은 점수를 몰아준다는 점입니다. 사람 평가자는 불과 몇 초 만에 훑어보며 채점하고, 심사 AI 모델 역시 기계적인 기준에 따라 검토합니다. 따라서 깔끔한 단락 구분과 전문용어가 빽빽한 답변이 언제나 안정적으로 높은 점수를 챙겨갑니다.
시간이 흐르면서 평가기 입맛에 맞추는 생존 전략은 모델 가중치에 단단히 굳어졌습니다. 사용자가 가벼운 안부 메일을 쓰거나 일상적인 상식을 묻더라도, 모델은 시험장 모범 답안을 내놓듯 무생물 주어와 여러 겹 축약된 복합절로 문장을 채워 넣습니다.
AI 글이 읽을수록 피곤하게 느껴지는 것은 지능의 퇴화와 아무 관련이 없습니다. arXiv:2610.29162 논문이 분석한 9개 모델의 성적표부터 그림 7의 길이 페널티 실험에 이르기까지, 모든 데이터가 가리키는 결론은 하나입니다. 대형 모델들은 화면 뒤의 채점기를 만족시키는 데만 온 힘을 쏟고 있으며, 화면 앞에서 글을 읽는 실제 인간 독자는 완전히 뒷전으로 밀려나 있습니다.
참고 링크:
- arXiv 논문: 《Why is AI-generated language so hard to understand?》(arXiv:2610.29162)
- Hacker News 커뮤니티 토론