9 个主流模型染上同一种文风病
2026 年 10 月 21 日,三位研究者 Thomas Hikaru Clark、Matias B. Martin 和 Kyle Mahowald 向 arXiv 提交了编号为 2610.29162 的论文。这篇归在计算与语言(cs.CL)分类下的研究,直接把人们读 AI 文本时的烦躁感摆上了解剖台。很多人都有过这种体会:打开聊天机器人写的报告,明明每个字都认识;连在一起却像嚼蜡一样进不了脑子。作者实测了市面上 9 个前沿与准前沿大模型;难读的毛病遍布全行业,根源在于训练打分机制把可读性挤出了门外。
为了摸清 AI 说话的底细,三位作者自建了一个跨领域的 AI 文本语料库,测试场景横跨日常对话、代码解析和命题作文。他们在 Amazon Bedrock 等平台上批量调接口跑数据;论文附录的表 1 还按每百万输入与输出 token 列出了详细的 API 账单。在这套统一标准的体检下,9 个模型无一幸免。它们集体抛弃了人类几万年演化出的沟通习惯,染上了一套高密度的机器文风。
拆开具体句式看,9 个模型全都更频繁地使用「无生命主语 + 有生命动词」结构。人类习惯说「工程师用这套算法找出了漏洞」;AI 偏要写成「这套算法审视并抓捕了潜在漏洞」。同时,9 个模型全部高频堆砌罕见的低频词组(低频 n-gram,即连续几个词的生僻搭配)。放着现成的家常话不用,它们非要挑生冷的书面词往一块凑。
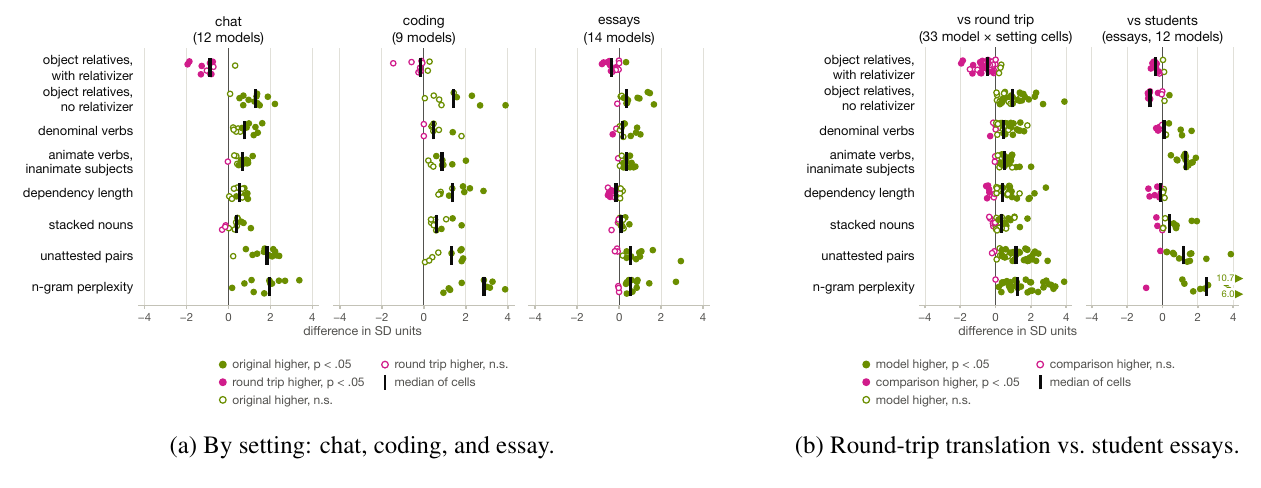 图:论文图 3,各语言特征在不同设置下的变化汇总,柱子越高说明模型用得越频繁。来源:arXiv 2610.29162
大脑内存被长句塞满,翻译机洗清多年黑锅
多数模型在对话场景下还暴露出另外三项坏习惯。它们分别是拉长依存距离(Dependency Distance)与名词堆叠(Noun Compounding);此外还有缩减的宾语关系从句(Reduced Object Relative Clauses)。人类大脑阅读时像一个端着托盘的分拣员;看到主语后必须一直端着它,直到找着谓语动词才能卸货。AI 偏爱在主语和动词之间塞满修饰语,把依存距离拉得老长;它还省掉从句连接词,让几层意思像套娃一样咬在一起。
面对这种拧巴的句子,外界过去常把责任推给「机器翻译腔」,怀疑是语料转写留下的后遗症。为了验证这个猜测,研究团队用开源翻译模型 NLLB-200 做了一组对照实验。他们把人类写的文章先翻成日语,再从日语翻回英语。这种往返翻译式改写保留了人类原本的沟通框架,只套上一层机器转写的外壳。
实验结果当场洗清了翻译机的冤屈。9 个 AI 大模型对上述高难度句式的依赖程度,远高于 NLLB-200 的日语往返改写版本。单纯的机器转写造不出这么密集的阅读障碍。真正让文字变得拗口难啃的,是模型在训练中自己养成的语用偏好。
算力全砸向解题跑分,留给读者的只剩压缩包
为什么聪明的模型偏要写出让人头疼的句子?论文把矛头指向了演化压力的错位。人类语言经过几万年演化,唯一的考官是对面听话的人;句式天然为「成功沟通」服务。今天的大模型在训练场上却换了一批铁面裁判:数学题库、代码编译器和自动评分器。
训练重心转向数学、代码与推理后,优化压力全压在「信息密度」上。论文把测试对象分成四大模型家族:基础预前沿模型、经重度后训练的前沿模型、开源权重准前沿模型,以及 GPT 系列模型。四大家族的句法指纹差异显著;后训练越激进、越追求推理跑分的模型,句式里的名词砖块就垒得越厚。
在 Hacker News 社区讨论里,有读者拿人类职场邮件做过对比:Gmail 里的专业工作邮件,平均每句话也包含约 1.3 个问题或诉求。人类写专业邮件同样紧凑;但那种紧凑是为了让收件人快速看懂并回信。AI 的紧凑只服务于答题密度;它把每句话都当成高倍率压缩包来封装,至于读者解压时大不大脑过载,根本不在评分器的考核表里。
改一条扣分规则,AI 立刻换掉说话方式
既然难读是因为训练目标偏了,改一下目标能不能当场改变文风?研究团队为此设计了一个概念验证实验。他们在强化学习(RL,Reinforcement Learning)阶段加上一条简单的「长度惩罚(Length Penalty)」,只要模型写长了就扣分。
实验结果直接反映在论文图 7 中。加上长度惩罚后,模型的语言偏好立刻大幅偏离人类的正常行为轨迹。为了在更短的篇幅里塞进同样多的得分点,模型开始变本加厉地删减连接词;它们拼命堆叠复合名词,把单句信息浓度推向极限。
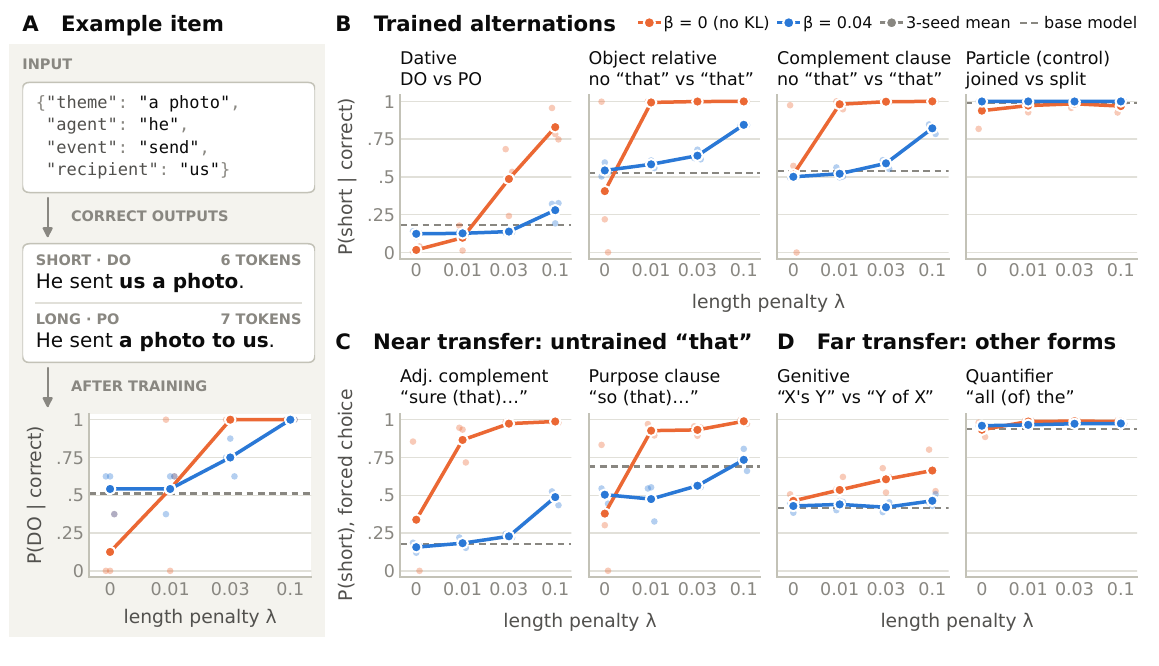 图:论文图 7,给强化学习加一个「写短一点」的惩罚,模型的语言偏好立刻偏离人类行为。来源:arXiv 2610.29162
这个实验戳破了「AI 语言能力见顶」的错觉。模型原本具备写出通顺家常话的底子;它之所以满嘴黑话、句式发硬,纯粹是因为强化学习的奖惩指挥棒往那边挥。优化目标指哪,模型的语言风格就打哪;可读性是在争夺高分的博弈中被主动牺牲掉的筹码。
打分器奖励标准答案,可读性成了牺牲品
社区讨论中的另一条观察,补上了训练管线的最后一环。现在的强化学习后训练(RL Post-training)有个核心偏好;它专门奖励那些「长相酷似标准答案」的表达。人工标注员往往在几秒内快速打分,裁判模型也在自动批改;排版工整、术语密集的文本总能稳拿高分。
久而久之,这套讨好评分器的生存策略就固化进了模型的权重参数。哪怕用户只是让它写封家常便饭的邮件,或者解释一个基础常识,它也会本能地端出考场范文;字里行间塞满「无生命主语」和多重缩减从句。
AI 写的字越读越累,从来都无关模型的智商退化。从 arXiv 2610.29162 测出的 9 个模型体检表,到图 7 的强化学习长度惩罚实验,所有证据都指向同一个结论。大模型正在全力讨好后台的评分器,而把屏幕前真正读字的人类晾在了一边。
参考链接:
- arXiv 论文《Why is AI-generated language so hard to understand?》(arXiv:2610.29162)
- Hacker News 社区讨论