9つの主要モデルに共通する文体の病巣
2026年10月21日、Thomas Hikaru Clark氏、Matias B. Martin氏、Kyle Mahowald氏の3名の研究者が、論文「Why is AI-generated language so hard to understand?」(arXiv:2610.29162)を計算と言語(cs.CL)カテゴリに投稿した。本研究は、AIが生成したテキストを読む際に誰もが感じるあの苛立ちと疲労感を正面から解剖している。チャットボットが書いたレポートを開くと、一つひとつの単語は理解できるのに、文章全体としては噛みごたえのない蝋のように頭に入ってこない。研究チームが市場のフロンティアおよび準フロンティアモデル9種を実測したところ、難解化の傾向は業界全体に及んでおり、その根底には訓練評価の仕組みが可読性を排除してしまった実態があった。
AIの言語的実態を正確に捉えるため、著者らは日常会話、コード解説、自由記述のテーマ英作文にわたる独自のドメイン横断コーパスを構築した。Amazon Bedrockなどのプラットフォームを経由してAPIをバッチ実行し、論文付録の表1には入出力100万トークンあたりのAPI利用料まで詳細に記録されている。この統一基準による診断の結果、9つのモデルすべてが同様の傾向を示した。人類が数万年かけて培ってきた円滑なコミュニケーション慣習を捨て去り、極めて高密度で機械的な文体に染まっていたのである。
具体的な構文を分析すると、9つのモデルはいずれも「無生物主語+生物的動詞」の構造を多用していた。人間なら「エンジニアがこのアルゴリズムを用いて脆弱性を検出した」と書くところを、AIは「このアルゴリズムが潜在的な脆弱性を精査し捕捉した」と表現したがる。さらに、すべてのモデルで低頻度n-gram(滅多に共起しない単語の組み合わせ)が異常な高頻度で詰め込まれていた。日常的に使われる平易な語彙を避け、不自然に硬い書面語を強引に結びつける傾向が顕著に見られた。
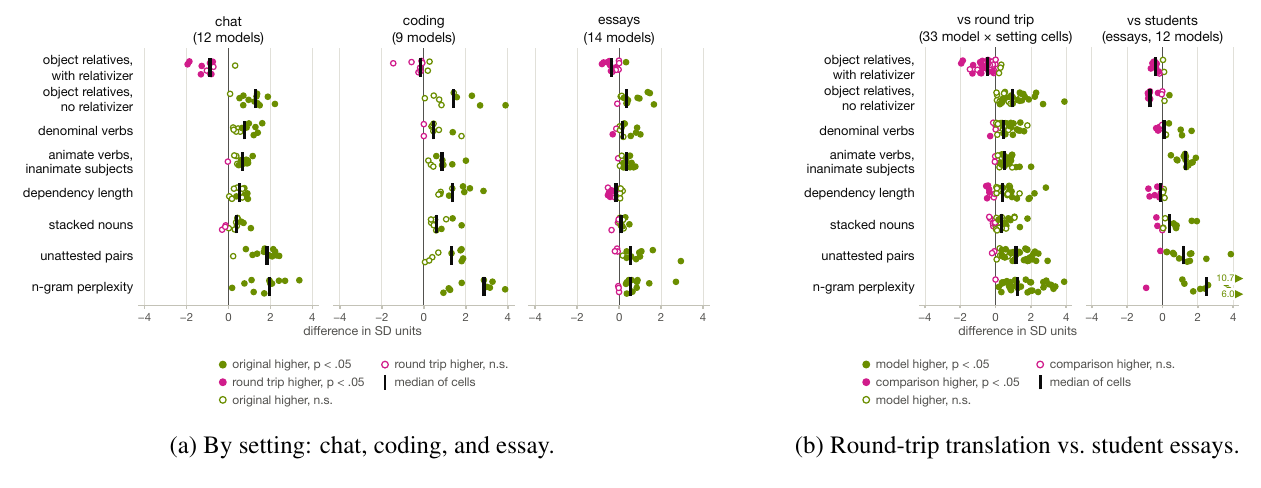 図:論文図3。各言語的特徴の設定別変化まとめ。バーが高いほどモデルがその特徴を頻繁に使用していることを示す。出典:arXiv:2610.29162
長大な依存構造で圧迫されるワーキングメモリ、翻訳エンジンの濡れ衣が晴れる
対話シナリオにおいて、多くのモデルにはさらに3つの悪癖が見られた。依存関係距離(Dependency Distance)の肥大化、名詞の過剰な連続結合(Noun Compounding)、そして目的格関係代名詞の省略による関係節(Reduced Object Relative Clauses)の多用である。人間の脳は、文章を読む際にトレイを抱えた仕分け作業員のように働く。主語に出会うと、述語動詞を見つけるまでその主語をトレイ上に保持し続けなければならず、動詞に到達して初めて負荷を解放できる。AIは主語と動詞の間に長大な修飾句を詰め込んで依存距離を極端に引き伸ばし、さらに接続詞を省いてマトリョーシカのように何重もの節を噛み合わせる。
このようなぎこちない文章について、従来は「機械翻訳調の癖」が原因であり、多言語学習データの弊害ではないかと疑われてきた。この仮説を検証するため、研究チームはオープンソースの翻訳モデル「NLLB-200」を用いた対照実験を実施した。人間が書いた文章を一度日本語に翻訳し、それを再び英語に逆翻訳する手法である。この往復翻訳アプローチは、人間が本来持つ論理構成を保ったまま、機械翻訳特有の言い回しだけを上乗せする。
実験結果は翻訳エンジンの潔白を証明した。9つの大規模モデルが上記の難解な構文へ依存する度合いは、NLLB-200による日本語往復翻訳版よりもはるかに高かったのである。単なる機械翻訳の過程だけでは、これほど過密な認知的負荷は生じない。文章を難解で読みにくいものに変貌させていた真因は、モデルが事後学習の過程で自ら身につけた言語運用の選好にあった。
ベンチマーク採点に浪費される計算資源、読者に残された高圧縮ファイル
なぜ優れた知能を持つはずのモデルが、読者を疲弊させる文章を書くのか。論文はその原因を進化圧のねじれに見出している。人類の言語が数万年かけて進化する中で、唯一の採点者は対面で話を聞く相手であり、構文は自然と「意思疎通を成功させること」に最適化されてきた。しかし現代のフロンティアモデルが直面する訓練場の採点官は、数学の問題集、コードコンパイラ、そして自動スコアリングエンジンである。
訓練の重心が数学、コード、論理推論へと傾斜した結果、最適化の圧力はもっぱら「情報の凝縮度」に集中した。論文では検証対象をプレフロンティア基礎モデル、強力な事後学習を施したフロンティアモデル、オープンウェイト準フロンティアモデル、そしてGPTファミリーの4系統に分類している。4系統の構文パターンには明確な差異が見られ、事後学習が先鋭化し推論ベンチマークのスコアを追求したモデルほど、文章中に積み上げられる名詞のブロックは厚くなっていた。
Hacker Newsのコミュニティ議論では、ビジネスメールとの比較が挙げられた。Gmailで交わされる専門的な業務メールでも、1文あたり平均約1.3件の要望や質問が含まれている。人間のプロフェッショナルな文章も十分に簡潔だが、その簡潔さは受信者が迅速に理解して返信できるように設計されている。一方、AIの簡潔さは回答密度を高めることだけを目的としている。一文一文を高圧縮アーカイブのようにパッケージングしており、読者の脳が展開処理でパンクするかどうかは、評価器の採点基準に微塵も含まれていない。
減点ルールを1行変えるだけで、AIの語り口は即座に変容する
可読性の低下が訓練目標の歪みに起因するならば、目標を変更すれば文体も即座に変わるのか。研究チームはこの問いに答える概念実証実験を行った。強化学習(RL)のプロセスに、「長さペナルティ(Length Penalty)」というシンプルなルールを追加し、出力が長くなった場合に減点するようにしたのである。
実験の結果は論文の図7に如実に現れている。長さペナルティを導入した途端、モデルの言語的選好は人間本来の行動軌跡から劇的に乖離した。限られた文字数の中に同等の採点ポイントを無理やり詰め込むため、モデルは接続詞を容赦なく削ぎ落とし、複合名詞を猛烈にスタックさせ、単句の情報濃度を極限まで引き上げた。
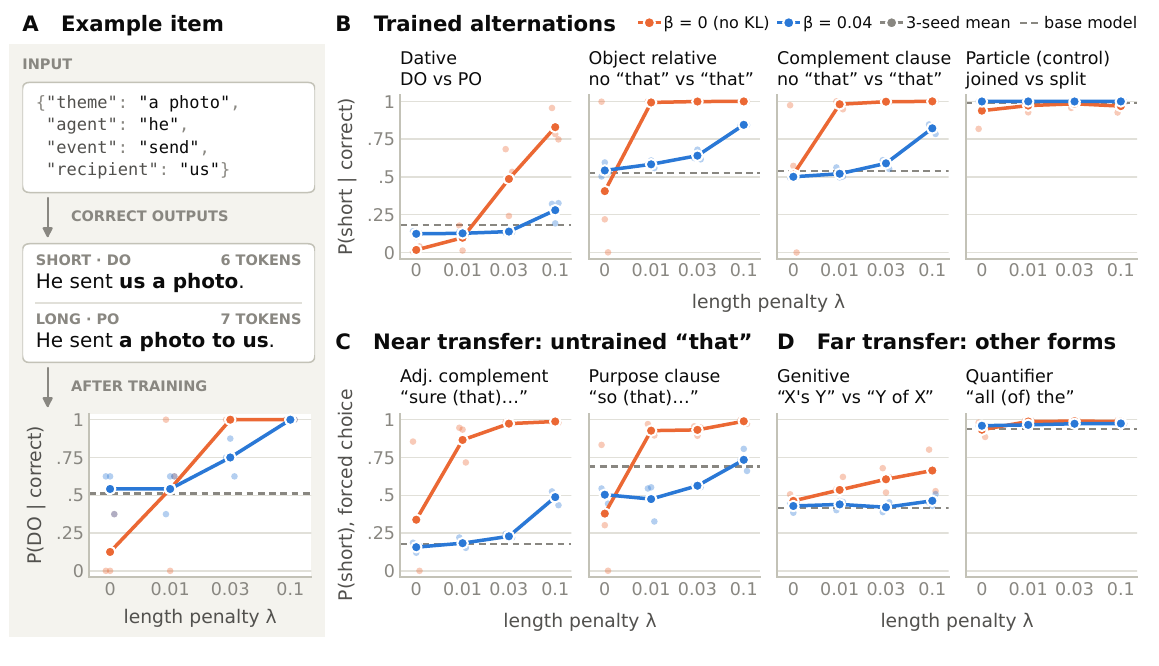 図:論文図7。強化学習に「短く書け」というペナルティを課すと、モデルの言語的選好は人間の自然な振る舞いから急速に乖離する。出典:arXiv:2610.29162
この実験は、「AIの言語能力が頭打ちになった」という世間の錯覚を打ち破った。モデルには本来、平易で読みやすい自然な文章を出力する素地が備わっている。専門用語を並べ立て、硬直した構文を吐き出していたのは、純粋に強化学習の報酬という指揮棒がそちらを指していたからに過ぎない。最適化の目標が向く方向へ、モデルの文体はどこまでも追従する。可読性は高スコアを奪取する競争の中で、真っ先に差し出された犠牲の駒に過ぎなかった。
評価器が模範解答を称賛し、可読性が切り捨てられる構造
コミュニティでの指摘は、訓練パイプラインの最後のパズルを埋める。現代の強化学習事後学習(RL Post-training)には、ある根深い偏向が存在する。それは「模範解答の佇まいをした出力」を過度に優遇する点だ。人間のアノテーターは数秒の流し読みで採点を行い、ジャッジモデルも機械的なルールで評価を下す。整然とした箇条書きと専門用語が密集したテキストは、常に高いスコアを安定して獲得してしまう。
その結果、評価器に阿る生存戦略がモデルの重みパラメータに強固に定着した。ユーザーが気楽な日常メールの作成や初歩的な常識の説明を求めた場合でも、モデルは無意識に試験会場の答案のような文体を繰り出し、無生物主語と幾重にも縮約された複文で紙面を埋め尽くす。
AIの文章が読みにくさを増している現象は、モデルの知能低下とは何の関係もない。arXiv:2610.29162が提示した9つのモデルの診断結果から、図7の長さペナルティ実験に至るまで、すべての証拠は単一の結論を物語っている。大規模言語モデルはバックエンドの採点評価器を喜ばせることに全力を注ぎ、画面の向こうで実際に文章を読む生身の人間を完全に置き去りにしているのだ。
参考リンク:
- arXiv論文: 『Why is AI-generated language so hard to understand?』 (arXiv:2610.29162)
- Hacker News コミュニティ議論