Neuf modèles de pointe atteints de la même pathologie de style
Le 21 octobre 2026, les chercheurs Thomas Hikaru Clark, Matias B. Martin et Kyle Mahowald ont déposé sur arXiv l’article 2610.29162 dans la catégorie Calcul et langage (cs.CL). Cette étude met directement en lumière l’épuisement cognitif que suscite la lecture de contenus générés par l’IA. L’expérience est familière à beaucoup : en ouvrant un rapport rédigé par un agent conversationnel, chaque terme pris isolément semble compréhensible, mais l’ensemble forme une prose compacte et difficilement assimilable. En testant neuf grands modèles de pointe et quasi-pointe du marché, les auteurs ont constaté que cette opacité traverse toute l’industrie, née de mécanismes d’évaluation qui ont relégué la lisibilité au second plan.
Pour disséquer les mécanismes d’écriture des modèles, les trois auteurs ont conçu un corpus textuel couvrant la conversation courante, l’analyse de code et la rédaction libre. Ils ont mobilisé les API à grande échelle via des plateformes comme Amazon Bedrock ; le tableau 1 de l’annexe détaille précisément les coûts par million de tokens en entrée et en sortie. Face à cette grille d’analyse standardisée, aucun modèle n’a fait exception. Ensemble, ils ont délaissé les réflexes de communication forgés par l’humanité au fil des millénaires pour adopter une prose machinique dense et artificielle.
En observant les structures grammaticales, les neuf modèles se distinguent par l’emploi disproportionné du schéma « sujet inanimé + verbe animé ». Là où un rédacteur humain écrit naturellement : « Les ingénieurs ont utilisé cet algorithme pour identifier des failles », l’IA préfère écrire : « Cet algorithme inspecte et intercepte les vulnérabilités potentielles ». De surcroît, tous les modèles accumulent des n-grammes de faible fréquence, c’est-à-dire des associations de plusieurs mots rarement observées ensemble dans l’usage spontané. Au lieu d’employer des formulations simples, ils privilégient des juxtapositions formelles et ampoulées.
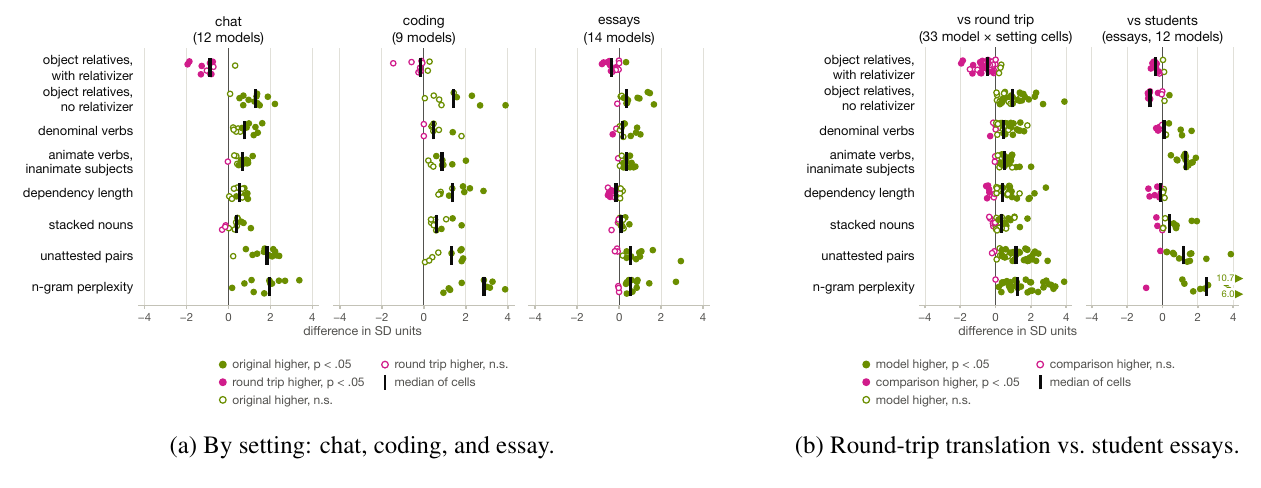 Figure : Figure 3 de l’article, synthèse de l’évolution des traits linguistiques selon les contextes. Une barre élevée signale une utilisation particulièrement fréquente par le modèle. Source : arXiv:2610.29162
La mémoire de travail saturée par des phrases à rallonge : la traduction automatique mise hors de cause
En contexte conversationnel, la plupart des modèles ont manifesté trois autres travers : une distance de dépendance (Dependency Distance) allongée, une prolifération de noms composés (Noun Compounding) et un usage récurrent de propositions relatives objets réduites (Reduced Object Relative Clauses). Le cerveau humain lit à la manière d’un opérateur tenant un plateau de tri : lorsqu’il rencontre un sujet, il doit le conserver en mémoire vive jusqu’à parvenir au verbe principal pour libérer sa charge cognitive. L’IA multiplie les modificateurs entre sujet et verbe, étirant démesurément cette distance ; elle omet également les conjonctions, emboîtant les subordonnées comme des poupées russes.
Jusqu’alors, cette syntaxe tarabiscotée était souvent attribuée aux « tics de traduction automatique », suspectée d’être un effet secondaire des corpus multilingues. Pour vérifier cette intuition, l’équipe a mené une expérience témoin avec le modèle libre NLLB-200. Des textes rédigés par des humains ont été traduits en japonais, puis traduits à nouveau du japonais vers l’anglais. Cette rétro-traduction préserve l’armature logique humaine tout en y superposant les tournures mécaniques de la transposition automatisée.
Les résultats ont totalement disculpé les outils de traduction. Les neuf grands modèles recourent bien plus massivement à ces structures alambiquées que la version rétro-traduite par NLLB-200. La seule traduction automatique ne produit pas une telle rugosité de lecture. Le véritable coupable de cette lourdeur stylistique réside dans les préférences pragmatiques que les modèles ont acquises au cours de leur post-entraînement.
La puissance de calcul dédiée aux classements : au lecteur ne reste qu’un fichier compressé
Pourquoi des modèles aussi performants s’entêtent-ils à produire des phrases si pénibles ? L’article pointe un décalage dans la pression de sélection. Tout au long de l’évolution du langage humain, l’unique juge était l’interlocuteur en face de soi ; la construction des phrases s’est naturellement ajustée pour réussir la communication. Aujourd’hui, les grands modèles affrontent des juges bien différents lors de leur entraînement : banques de problèmes mathématiques, compilateurs de code et barèmes de notation automatisés.
Lorsque les priorités se sont déplacées vers les mathématiques, la programmation et le raisonnement formel, toute la tension d’optimisation s’est focalisée sur la densité d’information. L’article regroupe les modèles testés en quatre familles : modèles de base pré-frontière, modèles de pointe lourdement post-entraînés, modèles quasi-pointe en poids ouverts et famille GPT. Leurs empreintes syntaxiques divergent nettement : plus le post-entraînement est intensif et axé sur les scores de raisonnement, plus les blocs de substantifs s’empilent.
Dans les échanges sur Hacker News, des lecteurs ont dressé un parallèle avec les courriels professionnels : les messages de travail types sur Gmail comptent en moyenne environ 1,3 demande ou question par phrase. La communication professionnelle humaine est également concise, mais cette brièveté est conçue pour permettre au destinataire de réagir rapidement. La concision de l’IA ne sert qu’à maximiser la densité de réponses correctes. Elle conditionne chaque phrase comme une archive fortement compressée, sans se soucier de savoir si la décompression sature l’esprit du lecteur, car la charge cognitive ne figure sur aucune grille d’évaluation.
Modifier une seule règle de pénalité transforme aussitôt la voix de l’IA
Puisque cette difficulté de lecture découle d’objectifs d’entraînement biaisés, suffit-il d’ajuster le barème pour infléchir le style ? L’équipe de recherche a conçu une expérience de validation de principe. Durant la phase d’apprentissage par renforcement (RL), les chercheurs ont introduit une pénalité de longueur (Length Penalty) élémentaire, retirant des points dès qu’une réponse s’allongeait.
Les conséquences sont exposées à la figure 7 de l’étude. Dès l’application de cette pénalité, les choix linguistiques du modèle se sont écartés de manière spectaculaire des repères humains habituels. Pour concentrer les mêmes éléments de réponse dans un volume restreint, le modèle a supprimé davantage de connecteurs, empilé les noms composés et poussé la densité d’information de chaque proposition à l’extrême.
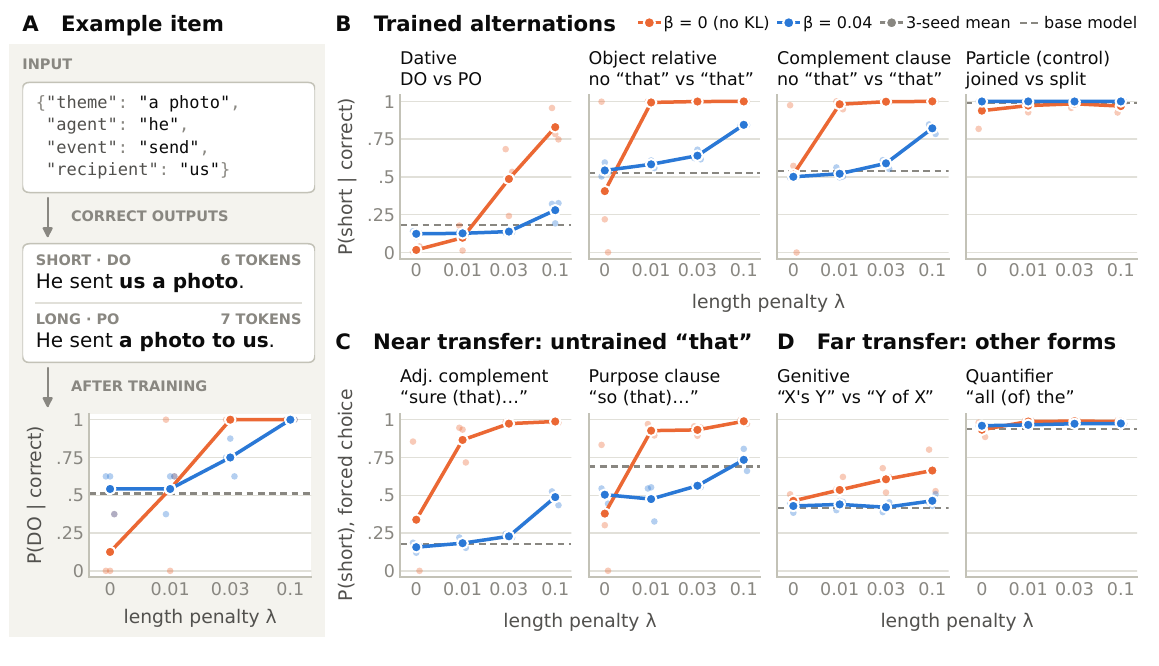 Figure : Figure 7 de l’article. L’ajout d’une consigne de brièveté dans l’apprentissage par renforcement éloigne brutalement le style du modèle des usages humains naturels. Source : arXiv:2610.29162
Cette expérience démonte l’idée selon laquelle les capacités linguistiques de l’IA auraient atteint un plafond. Les modèles conservent la faculté d’écrire avec clarté et naturel. S’ils abusent de jargon et de tournures rigides, c’est uniquement parce que la baguette des récompenses de l’apprentissage par renforcement les oriente dans cette direction. Là où pointe l’objectif d’optimisation, le style du modèle s’aligne immédiatement. La lisibilité n’a été qu’un pion sacrifié dans la course aux scores de référence.
Les évaluateurs prônent les réponses types, la lisibilité est sacrifiée
Une autre observation formulée dans la communauté technologique éclaire la dernière étape de la chaîne d’entraînement. Le post-entraînement par apprentissage par renforcement (RL Post-training) actuel comporte un biais structurel : il valorise systématiquement les productions qui adoptent l’aspect visuel d’un corrigé type. Les annotateurs humains notent souvent en quelques secondes d’un simple coup d’œil, et les modèles juges appliquent des critères stéréotypés. Les textes rigoureusement mis en page et surchargés de vocabulaire technique obtiennent invariablement les meilleures notes.
Avec le temps, cette stratégie visant à complaire aux évaluateurs s’est ancrée dans les paramètres mêmes des modèles. Même lorsqu’un utilisateur sollicite un mot informel ou l’explication d’un fait courant, le modèle adopte d’instinct la posture d’une copie d’examen, saturée de sujets inanimés et de relatives imbriquées.
Si les écrits de l’IA se révèlent de plus en plus fastidieux à lire, cela ne traduit nullement une régression intellectuelle des modèles. Du bilan des neuf architectures analysées dans arXiv:2610.29162 aux tests de pénalité de longueur de la figure 7, toutes les observations mènent au même constat. Les grands modèles déploient toute leur énergie pour séduire les barèmes automatisés en arrière-plan, en ignorant royalement les humains qui cherchent simplement à les lire sur leur écran.
Liens de référence :
- Article arXiv : Why is AI-generated language so hard to understand? (arXiv:2610.29162)
- Échanges sur la communauté Hacker News