Con el portátil desconectado a diez mil metros de altura: programando un simulador de vuelo en pleno vuelo
A diez mil metros de altitud, en la clase turista de un vuelo comercial con las puertas selladas y los teléfonos móviles sin conexión, un investigador de Thinking Machines Lab bajó la bandeja del asiento. Sin acceso a internet, ejecutó en un MacBook Pro tareas de generación de código local. En cuestión de pocos minutos, la pantalla mostraba un simulador de vuelo en 3D plenamente interactivo y dotado de motor de física.
La escena ilustra el potencial de Inkling 2 Mini, un modelo de pesos abiertos lanzado el 20 de noviembre de 2026 bajo la permisiva licencia Apache 2.0 y sin barreras comerciales. Su presentación envía un mensaje contundente al sector: desarrollar software sofisticado ya no depende de forma ineludible de costosos clústeres en la nube.
Durante años, la corriente dominante en inteligencia artificial ha confiado en la fuerza bruta del escalado de parámetros físicos. Los gigantes tecnológicos adquieren decenas de miles de GPU dedicadas, consumiendo ingentes cantidades de electricidad en centros de supercomputación. Inkling 2 Mini adopta una vía alternativa y reduce el tamaño en memoria del modelo a unos 20 GB. Tareas de inferencia complejas que antes exigían grandes servidores operan ahora de manera estable en un ordenador portátil convencional.
24 capas físicas que rinden como 48: reutilización sistemática de los mismos pesos
El secreto de esta alta densidad de cálculo radica en la reestructuración de las capas neuronales. La arquitectura Transformer habitual funciona como una cadena de montaje unidireccional: al generar un token, la información atraviesa cada capa de principio a fin una única vez. El nuevo modelo rompe esa secuencia lineal mediante una arquitectura Transformer recurrente (Recurrent Transformer), en la que determinadas capas intermedias se ejecutan de manera repetida.
La estructura física del modelo cuenta con 24 capas. Durante la generación de cada palabra, las capas 1 a 5 llevan a cabo la extracción inicial de características. A continuación, el bloque intermedio, compuesto por las capas 6 a 17 (12 capas en total), se ejecuta de forma consecutiva tres veces. Por último, las capas finales sintetizan y proyectan la salida. En términos de profundidad de cómputo, este flujo equivale en la práctica a una red de 48 capas.
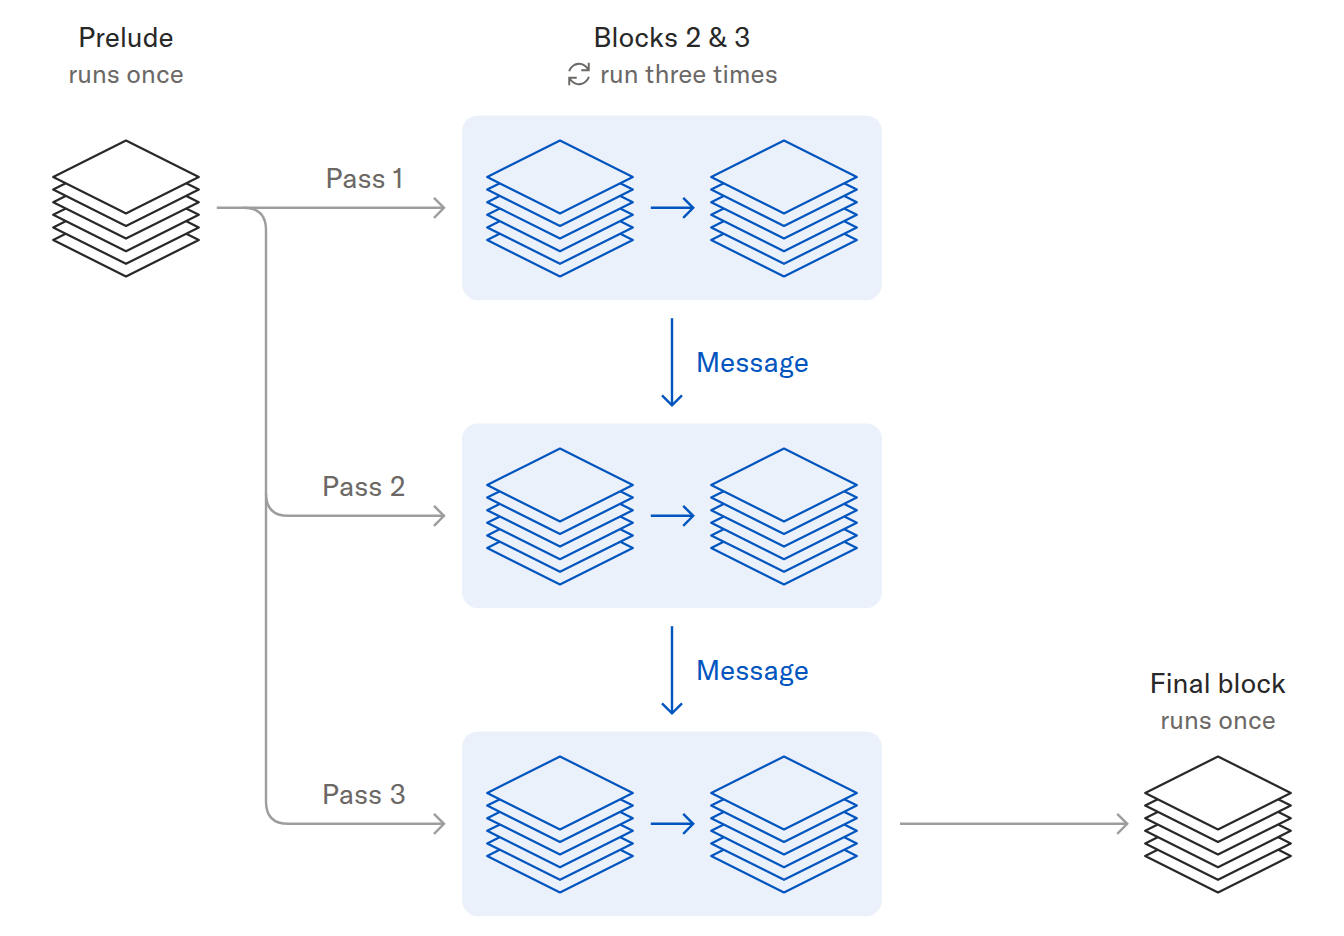 Figura: Esquema de la arquitectura: el tramo inicial se ejecuta una vez, el bloque intermedio se repite tres veces y el tramo final una vez. Fuente: Thinking Machines Lab
Las tres pasadas recurrentes comparten exactamente el mismo conjunto físico de pesos. El volumen total de parámetros se mantiene en 26,4B, con solo 3,4B de parámetros activos iniciales. Al reutilizar el bloque intermedio tres veces, el cómputo efectivo activo por token se eleva al equivalente de 5,4B de parámetros. La carga adicional de trabajo se traduce en tiempo de procesamiento sobre el silicio, sin sobrecargar la memoria RAM.
Este mecanismo traslada la exigencia de hardware desde la capacidad de VRAM hacia el aprovechamiento de la potencia de cálculo. Para alcanzar una profundidad equivalente a 48 capas en un dispositivo local, hasta ahora se requería hardware profesional con memorias descomunales. Inkling 2 Mini intercambia tiempo por espacio, duplicando los pasos lógicos de deducción dentro del mismo volumen de parámetros.
Cómputo comprimido en 20 GB de RAM: baja precisión nativa sin tijeretazos posteriores
Una vez diseñada la arquitectura, conseguir una ejecución fluida en ordenadores personales exige superar la barrera de la precisión numérica. La mayoría de los modelos abiertos se entrenan en coma flotante de 16 bits (FP16/BF16) y posteriormente se comprimen mediante algoritmos de cuantización a 4 u 8 bits. Este recorte a posteriori suele degradar pesos críticos, provocando fallos en la deducción de código complejo.
Inkling 2 Mini abordó este problema desde la raíz adoptando formatos de baja precisión nativa durante el preentrenamiento. Las primeras 20 capas emplean de forma nativa el formato de coma flotante de 4 bits NVFP4 impulsado por Nvidia, mientras que las cuatro capas finales utilizan el formato microescalado MXFP8. Al nacer optimizado en baja precisión, no requiere conversiones secundarias que mermen su calidad. El consumo en memoria de los pesos se mantiene firmemente acotado en torno a los 20 GB.
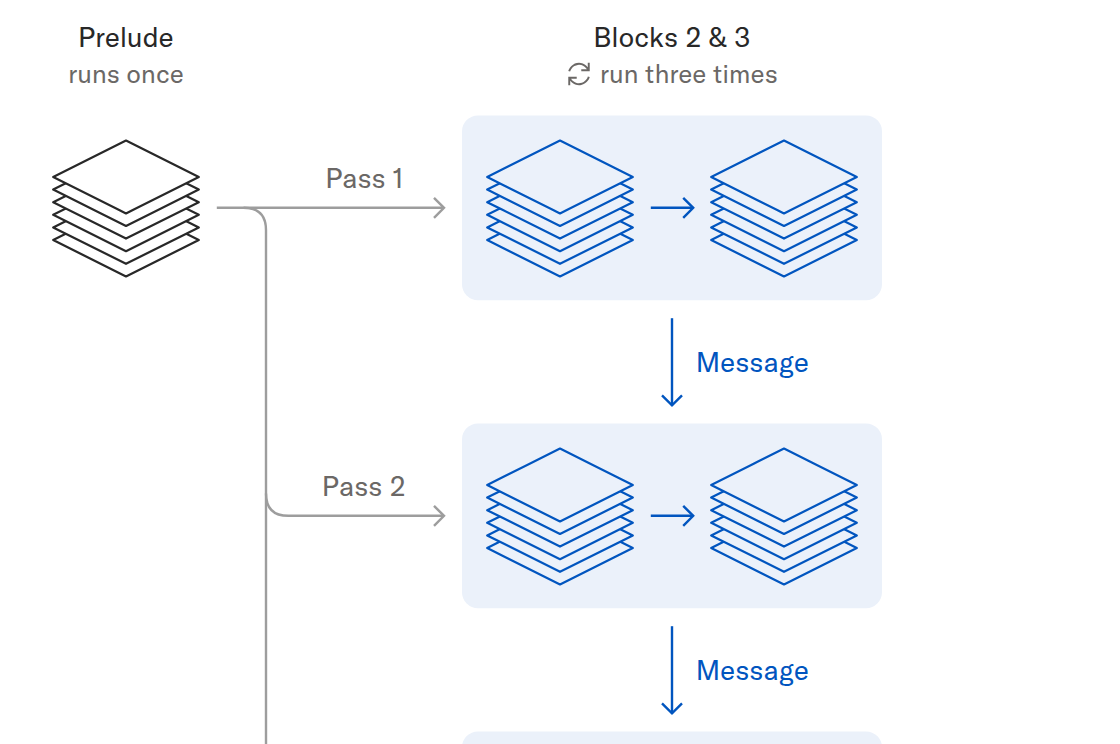 Figura: Gráfico oficial de evaluación: velocidad de decodificación frente a tasa de resolución de tareas. Fuente: Thinking Machines Lab
En las principales pruebas de ingeniería de software y razonamiento lógico, esta propuesta obtuvo registros notables. En el banco de pruebas DeepSWE v1.1, enfocado en resolución de problemas reales de ingeniería de software, alcanzó una tasa de éxito del 48,2%. En el Vals Index v2.2, que mide capacidades avanzadas de deducción lógica, logró una puntuación del 46,5%. Dentro de todos los modelos con pesos abiertos de menos de 100B de parámetros, ambas marcas ocupan el primer puesto.
El ecosistema de código abierto no tardó en reaccionar. Desarrolladores independientes crearon compiladores de cuantización específicos capaces de comprimir la memoria a 5,4 GB conservando una perplejidad superior a los formatos tradicionales Q4_K_M. En equipos con procesador Ryzen 395 y backend Vulkan, la inferencia local alcanza los 27 tokens por segundo, e incluso un chip M1 Pro de generaciones anteriores mantiene 10 tokens por segundo. La viabilidad de programar de forma plenamente autónoma en local ha dado un salto cualitativo.
Ocultar el razonamiento en capas latentes: ahorro de tokens a costa de puntos ciegos de seguridad
Tras este salto en rendimiento de inferencia subyace un cambio de paradigma computacional. Modelos de razonamiento profundo como OpenAI o1 dependen de cadenas de pensamiento explícitas (Chain of Thought), generando miles de tokens de texto visibles para que el usuario pueda auditar paso a paso su razonamiento. En cambio, Inkling 2 Mini condensa la deducción secuencial en sus estados ocultos internos (Hidden States), resolviendo el problema sin necesidad de generar cadenas de texto intermedias.
Los datos aportados por los laboratorios reflejan con claridad este comportamiento. Al prescindir de la emisión de texto explicativo, el tiempo de cálculo por paso pasó de 16 segundos con un ciclo a 37 segundos con tres iteraciones. En problemas de deducción lógica puramente secuencial, el rendimiento continuó aumentando incluso extendiendo los ciclos a diez repeticiones. La iteración interna permite que cada palabra generada concentre una densidad reflexiva notablemente superior.
El razonamiento implícito suprime la latencia asociada a la generación masiva de texto y reduce drásticamente el gasto en tokens. Sin embargo, plantea un serio dilema para la supervisión de la seguridad de la IA. Dado que la deducción ocurre íntegramente en el espacio vectorial interno, las herramientas de control externas no pueden detectar ni bloquear anomalías en la capa de texto. Aunque los ensayos del equipo no muestran una mayor propensión a comportamientos dañinos, las defensas tradicionales basadas en análisis textual pierden su ventana directa de intervención.
Las evaluaciones internas revelaron asimismo limitaciones prácticas evidentes. Ante diálogos de múltiples turnos con requerimientos densos y complejos, el modelo cayó al 50,0% en la prueba MultiChallenge y al 33,4% en ComplexConstraints. Sin la guía de prompts externos, en ocasiones entra en bucles de autoverificación que consumen computación de forma infructuosa. Además, en pruebas multilingües, la salida en chino llegó a presentar cortes abruptos y alternancias indeseadas de idioma.
Los límites físicos de los parámetros persisten: nueva táctica para modelos compactos
La arquitectura recurrente tiene fronteras bien definidas. Iterar sobre las capas de la red amplifica la profundidad de las inferencias secuenciales, pero no puede crear de la nada conocimiento factual sobre el mundo. Las pruebas de conocimientos generales corroboran que su bagaje no excede el propio de su escala física. La capacidad de memoria a largo plazo sigue sujeta al número total de parámetros físicos.
Para evitar que el modelo se enrede en bucles durante deducciones prolongadas, el equipo técnico recomienda aplicar medidas de ingeniería concretas. En entornos de producción, es fundamental fijar límites estrictos al número máximo de tokens por respuesta y a los turnos de conversación. Esta contención previene el desperdicio innecesario de potencia de cálculo y actúa como freno de seguridad en ejecuciones autónomas. El ajuste operativo compensa así las limitaciones intrínsecas del algoritmo.
El valor esencial de Inkling 2 Mini reside en ofrecer una alternativa viable a la escalada masiva de hardware. Frente a los costes desorbitados y los cuellos de botella de infraestructura, la reutilización recurrente de capas abre una vía táctica de escape sumamente eficiente. Desentrañar e interpretar los estados latentes antes de que se adopten decisiones críticas será la gran asignatura pendiente para consolidar la inteligencia artificial en el extremo de la red.
Enlaces de referencia:
- Informe técnico oficial de Thinking Machines Lab
- Debate técnico en la comunidad de Hacker News
- Tabla de clasificación del benchmark DeepSWE