ネット遮断の機内でノートPCを開き、その場で3Dフライトゲームを書き上げる
上空1万メートルを飛行する旅客機のエコノミークラス。キャビンドアは閉じられ、スマートフォンは機内モードでオフライン。Thinking Machines Labの研究員が座席のテーブルを引き倒し、ネットワークに一切接続されていないMacBook Proでローカルコード生成を実行した。わずか数分後、物理演算を備え、自由自在に操縦できる3Dフライトシミュレータが画面上で滑らかに動き始めた。
この光景は、2026年11月20日に公開されたオープンソースモデル「Inkling 2 Mini」によって実現された。同プロジェクトは制約の少ないApache 2.0ライセンスで無償公開され、商用利用のハードルも設けられていない。それはAI業界に対し、きわめて鮮烈な対比のシグナルを突きつけた。「複雑なソフトウェア構築に、もはや高価なクラウドクラスタは必須ではない」という事実である。
長年にわたり、業界には物理パラメータの規模をひたすら積み上げる「力任せ」の信仰が根強くあった。巨大テック企業は数万枚規模の専用GPUを調達し、データセンターで莫大な電力を消費し続けている。これに対しInkling 2 Miniはアプローチを根本から変え、モデルに必要なメモリ消費量を約20GBにまで圧縮した。従来は大型サーバーでしか動作しなかった高度な推論タスクが、個人のノートPC上にしっかりと着地したのである。
24層のネットワークで48層相当の深度を発揮:同一ウェイトを反復利用する設計
この高密度な計算効率を実現した秘密は、ネットワーク層の再構築にある。従来のTransformerモデルの構造は、一方向のベルトコンベアのようなものだった。トークンを1つ生成する際、各層は最初から最後まで一度しか通過しない。これに対して新モデルはこの単方向の制約を打破し、特定の層を繰り返し計算に組み込む「再帰型Transformer(Recurrent Transformer)」アーキテクチャを採用した。
モデルの物理的な構造は全24層で構成されている。1トークンを生成する際、まず第1〜5層が初期の特徴抽出を行う。続いて中間の第6〜17層(計12層)のネットワークブロックが、3回連続で繰り返し呼び出される。最後に後段の層が出力を収束させるため、全体の計算深度は実質48層分に匹敵する。
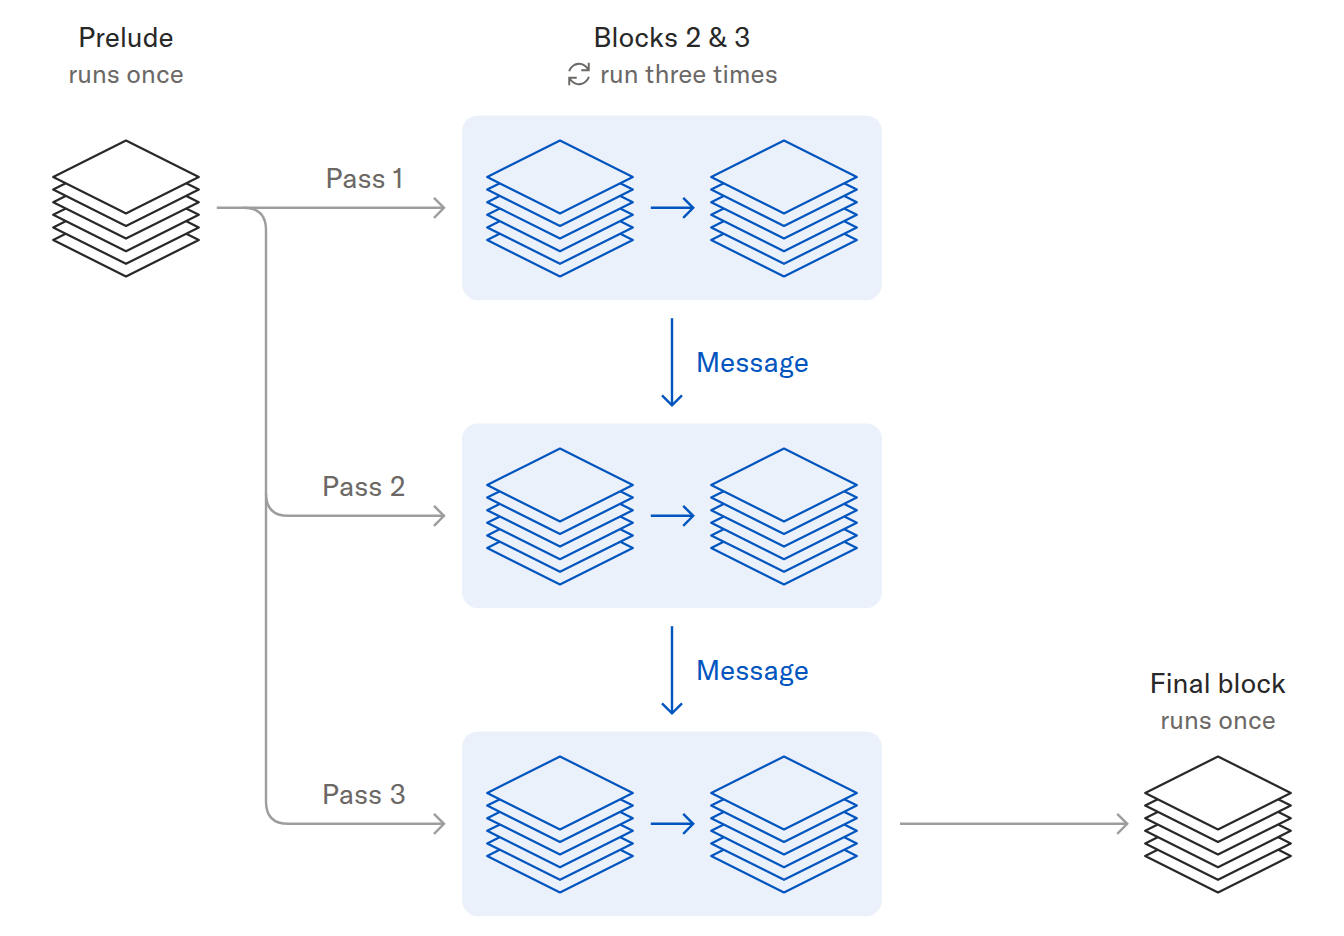 図:モデル構造の概念図。前段を1回実行後、中間ブロックを3回反復し、最後に終端層を1回実行する。出典:Thinking Machines Lab
この3回の反復ループでは、完全に同一の物理ウェイトがそのまま共有される。モデル全体の物理パラメータ数は26.4B、初期のアクティブパラメータは3.4Bにとどまる。しかし中間層を3回再帰的に使い回すことで、1トークン生成あたりの実効アクティブ計算ウェイトは5.4B相当まで引き上げられる。余剰の計算負荷はチップの演算時間として消費されるだけであり、メモリ容量を一切圧迫しない。
この仕組みは、ハードウェアにかかる負荷を「VRAM容量」から「演算器の利用効率」へと巧みに転換する。従来、端末側で48層相当の推論深度を得ようとすれば、莫大なVRAMを備えた特殊なワークステーションが不可欠だった。Inkling 2 Miniは時間と空間をトレードオフし、同一のパラメータフットプリントの中で論理演算の思考ステップを倍増させることに成功した。
20GBメモリに収まる演算規模:事後圧縮に頼らない「ネイティブ低精度」
優れたアーキテクチャを設計しても、個人用PC上で軽快に動作させるには精度の壁を乗り越える必要がある。従来のオープンソースモデルの多くは16ビット浮動小数点(FP16/BF16)で事前学習を行い、後から量子化アルゴリズムによって4ビットや8ビットへと間引くのが通例だった。しかし、この事後的な切り捨ては重要ウェイトの欠落を招きやすく、複雑なコードの論理推論でエラーを誘発する要因となっていた。
Inkling 2 Miniは、事前学習の初期段階からネイティブな低精度フォーマットを採用した。最初の20層にはNvidiaが主導するネイティブ4ビット浮動小数点「NVFP4」を直接適用し、末尾の4層にはマイクロスケール浮動小数点「MXFP8」を配置した。公開時点で最初から低精度最適化されているため、後から精度の落ちる非可逆変換を行う必要がない。ウェイト全体のメモリ消費量は、約20GBというコンパクトな範囲に厳格に抑えられている。
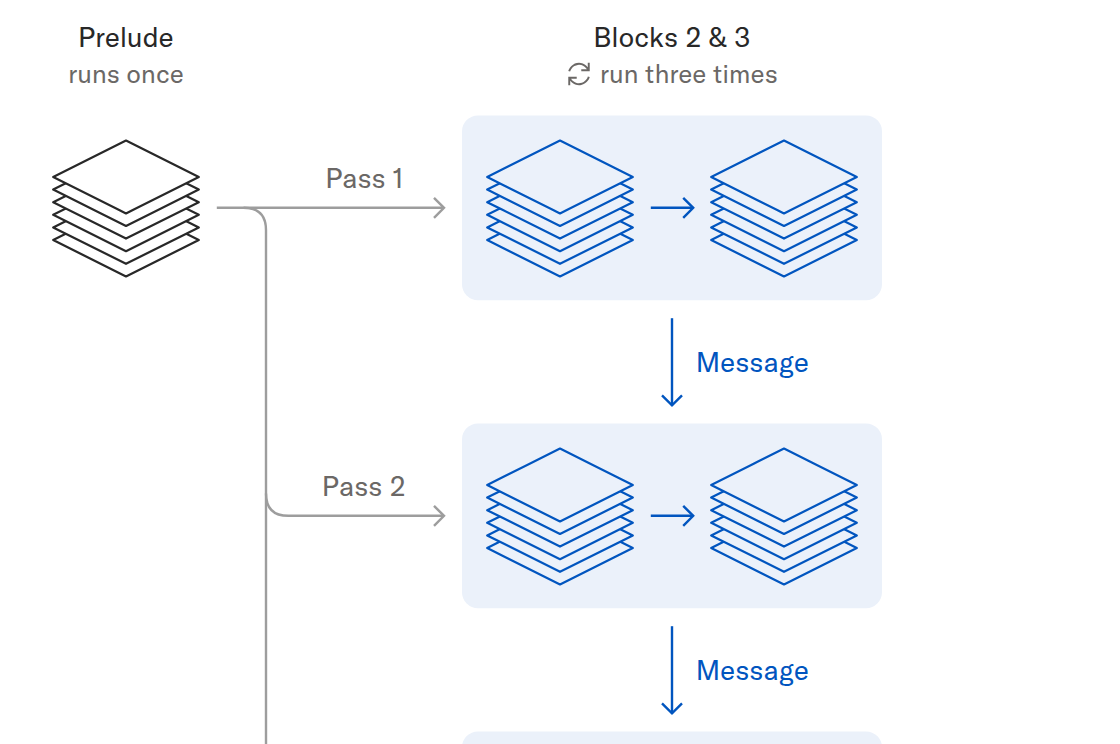 図:公式ベンチマーク図。横軸はデコード速度、縦軸はタスク解決率を示す。出典:Thinking Machines Lab
ソフトウェアエンジニアリングと論理推論に関する業界標準の評価において、この設計は際立ったスコアを記録した。実世界の複雑なソフトウェア課題を模した「DeepSWE v1.1」ベンチマークで48.2%の解決率を達成。高度な推論力を測る「Vals Index v2.2」でも46.5%のスコアをマークした。パラメータ数100B未満のオープンウェイトモデルのカテゴリーにおいて、これらはいずれも首位に立つ成績である。
オープンソースコミュニティの追随も迅速だった。有志の開発者が公開した専用量子化コンパイラを用いれば、メモリ消費量を5.4GBまで圧縮でき、従来のQ4_K_M形式よりも優れたパープレキシティを維持できる。Ryzen 395マシン上でVulkanバックエンドを用いた場合、ローカル環境で毎秒27トークンの推論速度を記録。初期型のM1 Proでも実用的な毎秒10トークンで動作する。エッジ端末における完全スタンドアロン開発の現実味が一気に高まった。
思考を隠れ層に潜潜させ、トークン数を削減する一方で監視の死角が拡大
推論性能が大きく跳ね上がった背景には、推論計算のパラダイムシフトが存在する。OpenAI o1のような深層推論モデルは、人間が読める数千〜数万のトークンを外に出力する「明示的な思考の連鎖(Chain of Thought)」に依存してきた。これに対しInkling 2 Miniは、一連の論理的思考を内部の隠れ状態(Hidden States)の中に直接圧縮し、無駄なテキストを出力することなく推論を完結させる。
公式ラボの検証データがその特性を雄弁に物語っている。思考プロセスをテキストとして出力しない場合、1回のステップに要する計算時間は1回ループの16秒から、3回ループでは37秒へと伸長した。直列的な論理パズルにおいては、ループ回数を10回まで増やしてもスコアが向上し続けた。反復計算によって、出力される1語1語が極めて高密度の「思考の重み」を帯びるようになったのである。
潜在的な推論はテキスト生成のレイテンシを大幅に削ぎ落とし、トークンコストも最小限に抑える。しかしその代償として、AIの安全監督には新たな難題が突きつけられた。推論の全過程が高次元のベクトル空間内部で完結するため、外部のセキュリティモジュールがテキスト層で異常な振る舞いを検知・遮断することが不可能になったのだ。開発チームの検証では、現状悪意ある挙動の増加は見られないとしているものの、テキストベースの防御策が直接機能する窓口が失われたことは否定できない。
さらに内部評価では、モデルの現実的な弱点も浮き彫りになった。入り組んだ制約が課される複数ターンの対話テスト「MultiChallenge」ではスコアが50.0%、「ComplexConstraints」では33.4%に落ち込んだ。外部からのプロンプト介入がない場合、自己検証のデッドロックに陥り、計算資源を空費したまま前進できなくなる現象も散見された。また多言語評価においては、中国語の出力において文末の欠落や英中混ざりの不自然な表現が見られる場面もあった。
パラメータの物理的限界と、小規模モデルが切り開く新戦術
当然ながら、再帰型アーキテクチャにも明確な物理的限界が存在する。ネットワーク層を反復実行することで直列的な論理推論の深度を深めることはできても、モデルの中に存在しない世界の知識を無から生み出すことはできない。事実知識を問うベンチマークでは、本モデルの知識量は同等の物理パラメータ規模の枠を出ていないことが示されている。長期記憶の容量は、依然として物理パラメータの総量によって厳密に規定されているのだ。
長時間の推論によってモデルが自己ループに囚われる現象を防ぐため、開発チームは運用のベストプラクティスを提示している。実装時には、最大生成トークン数や対話ターン数に強制的なリミットを設けることが推奨される。これにより演算リソースの無駄な浪費を防ぎ、自律実行に対する安全ブレーキを確保できる。エンジニアリングによる精緻な制御が、アルゴリズム固有の死角を補う形だ。
Inkling 2 Miniが持つ真の価値は、ハードウェアの物量投入競争に対抗する現実的なオルタナティブを切り拓いた点にある。コストとハードウェアの供給制約に直面する現場にとって、ネットワーク層の反復利用は極めて合理的な突破口となる。エッジ知能の普及を目前に控え、ブラックボックス化する潜在空間の思考をいかに解釈し、安全性を担保するか——開発者たちは今、新たな問いの前に立たされている。
参考リンク:
- Thinking Machines Lab 公式テクニカルレポート
- Hacker News コミュニティ技術ディスカッション
- DeepSWE ベンチマークリーダーボード