À 10 000 mètres d’altitude et sans connexion : programmer un simulateur 3D en plein vol
À dix mille mètres d’altitude dans la classe économique d’un vol commercial, portes verrouillées et téléphones en mode avion, un chercheur de Thinking Machines Lab abaisse sa tablette de siège. Sans la moindre connexion internet, il lance la génération locale de code sur un MacBook Pro. En l’espace de quelques minutes, un simulateur de vol en 3D complet, doté d’un moteur physique fonctionnel et pilotable en temps réel, tourne avec fluidité sur son écran.
Cette démonstration illustre les capacités d’Inkling 2 Mini, un modèle open source dévoilé le 20 novembre 2026 sous licence permissive Apache 2.0, sans restriction commerciale. Le projet envoie un signal fort qui bouscule les certitudes de l’industrie : concevoir des architectures logicielles complexes ne nécessite plus obligatoirement de lourds clusters dans le cloud.
Pendant longtemps, le secteur de l’intelligence artificielle s’est retranché derrière une logique de passage à l’échelle par la force brute. Les géants de la tech achètent des dizaines de milliers de cartes graphiques dédiées, engloutissant des volumes colossaux d’électricité dans leurs centres de supercalcul. Inkling 2 Mini propose un changement de paradigme en condensant l’empreinte mémoire du modèle autour de 20 Go. Des tâches d’inférence avancées, autrefois tributaires de serveurs massifs, s’exécutent désormais avec aisance sur un simple ordinateur portable.
24 couches physiques pour une profondeur de 48 : la réutilisation cyclique des mêmes poids
Le secret de cette densité de calcul réside dans une réorganisation fondamentale de l’exécution des couches neuronales. L’architecture Transformer conventionnelle fonctionne comme une chaîne d’assemblage unidirectionnelle : pour chaque jeton produit, les données traversent les différentes couches du début à la fin une seule et unique fois. Inkling 2 Mini s’affranchit de cette séquence linéaire grâce à une architecture Transformer récurrente (Recurrent Transformer), qui sollicite certaines couches intermédiaires à plusieurs reprises.
Le modèle se compose de 24 couches physiques. Lors de la génération d’un jeton, les couches 1 à 5 assurent l’extraction initiale des caractéristiques. Ensuite, le bloc intermédiaire, qui regroupe les couches 6 à 17 (soit 12 couches au total), est exécuté trois fois de suite de manière cyclique. Enfin, les couches terminales synthétisent et projettent la sortie. Sur le plan de la profondeur de calcul, ce traitement équivaut en pratique à un réseau de 48 couches.
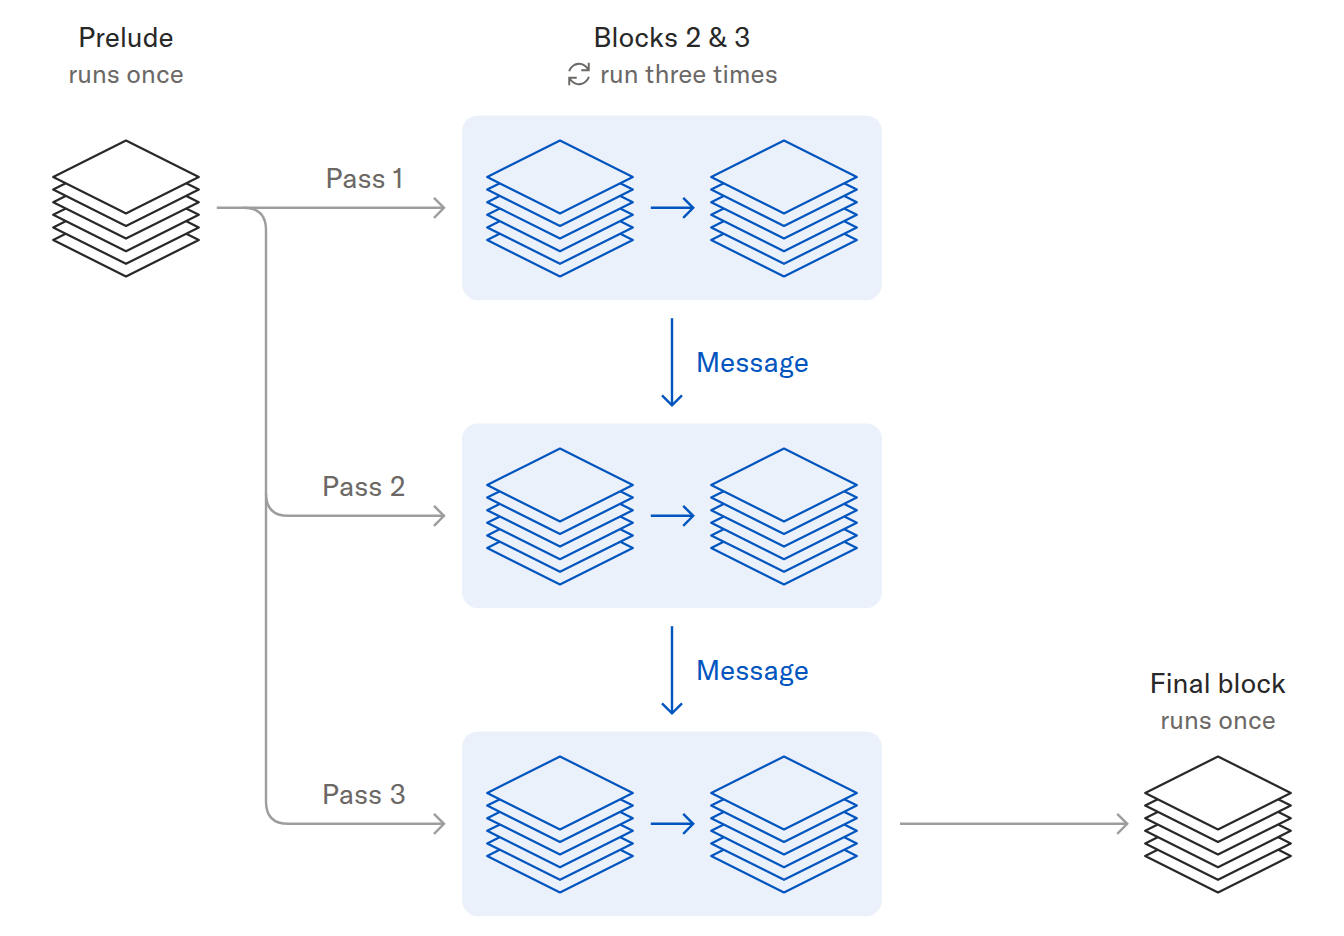 Figure : Schéma d’architecture : le bloc initial s’exécute une fois, le bloc central est répété trois fois, et le bloc terminal s’exécute une fois. Source : Thinking Machines Lab
Ces trois passages récurrents exploitent rigoureusement le même ensemble de poids physiques. Le volume total de paramètres physiques reste fixé à 26,4B, avec seulement 3,4B de paramètres actifs initiaux. Grâce à la triple réutilisation des couches médianes, le volume effectif de calcul actif par jeton grimpe à l’équivalent de 5,4B de paramètres. La charge supplémentaire est absorbée par le temps de calcul du processeur, sans surcharger la mémoire vive.
Ce procédé reporte la contrainte matérielle de la capacité de mémoire vidéo (VRAM) vers le taux d’exploitation de la puissance de calcul. Auparavant, atteindre une profondeur de 48 couches en local exigeait des stations de travail très onéreuses dotées de mémoires colossales. Inkling 2 Mini échange du temps contre de l’espace, doublant les étapes de déduction logique dans un volume de paramètres inchangé.
Faire tenir la puissance dans 20 Go de RAM : une faible précision native sans coupes a posteriori
Une fois l’architecture posée, assurer une fluidité optimale sur un ordinateur personnel requiert de surmonter le défi de la précision numérique. La plupart des modèles ouverts s’entraînent en virgule flottante 16 bits (FP16/BF16), avant d’être tronqués par des algorithmes de quantification en 4 ou 8 bits. Cette dégradation ultérieure fait souvent perdre des poids névralgiques, provoquant des erreurs dans les chaînes de déduction logicielle complexes.
Inkling 2 Mini a fait le choix d’intégrer des formats de faible précision directement lors du pré-entraînement. Les 20 premières couches adoptent nativement le format en virgule flottante 4 bits NVFP4 promu par Nvidia, tandis que les 4 dernières couches emploient le format à micro-échelle MXFP8. Prévu dès l’origine pour une faible précision, le modèle ne subit aucune conversion dégradante. L’empreinte mémoire totale des poids reste ainsi contenue autour de 20 Go.
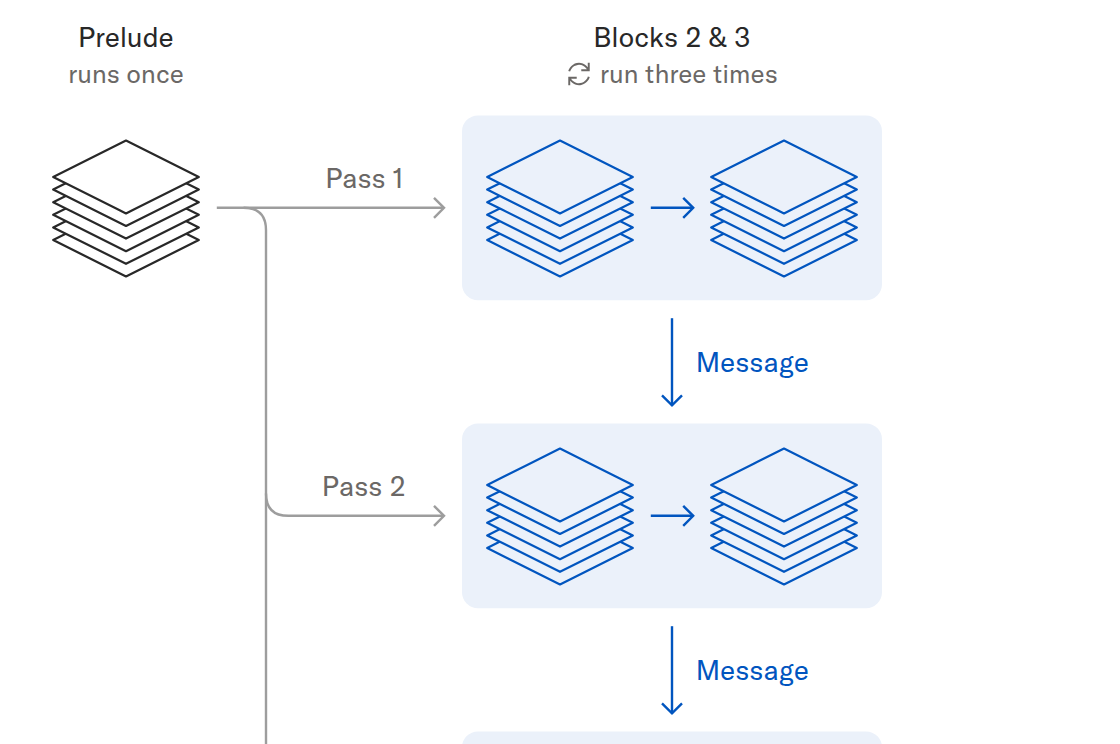 Figure : Graphique officiel des tests : vitesse de décodage en fonction du taux de résolution des tâches. Source : Thinking Machines Lab
Sur les bancs d’essai de référence évaluant le génie logiciel et le raisonnement formel, cette approche a livré d’excellents résultats. Sur le benchmark DeepSWE v1.1, axé sur la résolution de problèmes réels d’ingénierie logicielle, le modèle affiche un taux de réussite de 48,2 %. Sur l’indice Vals v2.2, qui jauge le raisonnement logique poussé, il atteint un score de 46,5 %. Parmi l’ensemble des modèles à poids ouverts de moins de 100B de paramètres, il s’octroie la première place sur ces deux évaluations.
L’écosystème open source n’a pas tardé à s’emparer de l’innovation. Des développeurs ont mis au point des compilateurs de quantification dédiés capables de compresser l’empreinte mémoire à 5,4 Go tout en préservant une perplexité supérieure aux formats traditionnels Q4_K_M. Sur une machine équipée d’un Ryzen 395 et du backend Vulkan, l’inférence locale atteint 27 jetons par seconde ; un MacBook doté d’une puce M1 Pro plus ancienne maintient une cadence très fonctionnelle de 10 jetons par seconde. L’autonomie totale du développement sur terminal local franchit ainsi un cap décisif.
Dissimuler la réflexion dans les couches cachées : économie de jetons et opacité du contrôle
Cette poussée des performances d’inférence masque une évolution notable du paradigme de calcul. Les modèles axés sur le raisonnement approfondi comme OpenAI o1 s’appuient sur des chaînes de pensée explicites (Chain of Thought), générant des milliers de jetons de texte lisibles afin que l’utilisateur puisse auditer leur démarche étape par étape. Inkling 2 Mini compresse quant à lui ses déductions directement au sein d’états cachés internes (Hidden States), complétant son raisonnement sans produire de texte intermédiaire.
Les tests officiels documentent précisément ce comportement : en l’absence de chaîne de pensée textuelle, le temps de calcul dédié à une étape s’est allongé de 16 secondes pour une seule passe à 37 secondes pour trois cycles. Sur des exercices de pure logique séquentielle, les performances continuent de progresser même en portant la récurrence à dix passages. La répétition cyclique confère à chaque mot généré une densité de réflexion considérablement plus riche.
Ce raisonnement implicite élimine la latence propre aux longs développements textuels et fait chuter drastiquement les coûts en jetons. En revanche, il complique singulièrement la tâche de surveillance de la sécurité des modèles. La chaîne de déduction se déroulant entièrement dans un espace vectoriel abstrait, les filtres externes ne disposent plus d’accroche au niveau textuel pour intercepter un comportement déviant. Bien que les expérimentations menées n’aient révélé aucune propension accrue à la malveillance, les garde-fous classiques fondés sur l’analyse de texte perdent leur levier d’action direct.
Les évaluations internes soulignent également des faiblesses bien concrètes. Confronté à des échanges multi-tours assortis de contraintes particulièrement denses, le modèle n’a obtenu que 50,0 % au test MultiChallenge et 33,4 % sur l’indicateur ComplexConstraints. Privé d’indications de cadrage externes, il lui arrive de s’enliser dans des boucles d’autocontrôle sans fin, gaspillant ses cycles de calcul sans parvenir à conclure. Lors de tests multilingues, la génération en chinois a en outre révélé des ruptures de syntaxe et des mélanges sporadiques d’anglais.
Les contraintes physiques des paramètres demeurent : une nouvelle tactique pour les modèles compacts
L’architecture récurrente se heurte à des limites structurelles évidentes. Faire boucler les couches de réseau affine la rigueur des déductions séquentielles, mais ne saurait faire émerger de nouvelles connaissances factuelles ex nihilo. Les bancs d’essai consacrés aux savoirs généraux confirment que sa culture reste calée sur celle de sa classe de paramètres physiques. La mémoire factuelle demeure irrévocablement tributaire du nombre total de poids.
Pour pallier la tendance du modèle à tourner en rond lors d’exercices d’inférence prolongés, le laboratoire formule des recommandations claires. En environnement de production, les systèmes doivent imposer des limites strictes sur le nombre maximal de jetons par réponse et le nombre de tours de conversation. Ces garde-fous empêchent l’épuisement stérile des ressources de calcul tout en assurant un arrêt d’urgence salutaire lors d’exécutions autonomes. Des mesures d’ingénierie rigoureuses viennent ainsi pallier les angles morts intrinsèques de l’algorithme.
La portée essentielle d’Inkling 2 Mini réside dans sa capacité à offrir une alternative concrète à la course aux armements matériels. Face à l’explosion des coûts et aux pénuries d’équipements de pointe, la réutilisation cyclique des couches s’impose comme une manœuvre tactique particulièrement féconde. La façon dont la recherche parviendra à décrypter les états cachés pour en garantir la sûreté avant chaque prise de décision constituera le prochain grand défi de l’intelligence artificielle embarquée.
Liens de référence :
- Rapport technique officiel de Thinking Machines Lab
- Discussion technique sur la communauté Hacker News
- Classement du benchmark DeepSWE