Ohne Internetverbindung über den Wolken: 3D-Flugsimulator direkt im Flugzeug gecodet
In zehntausend Metern Höhe in der Economy-Klasse eines Passagierflugzeugs, bei verriegelter Kabinentür und Smartphones im Offlinemodus, klappte ein Forscher von Thinking Machines Lab den Klapptisch herunter. Völlig ohne Verbindung zum Internet ließ er auf einem MacBook Pro lokalen Programmcode generieren. Innerhalb weniger Minuten lief auf dem Bildschirm ein interaktiver 3D-Flugsimulator mit vollständiger Physik-Engine.
Dieses Szenario demonstriert das Potenzial des am 20. November 2026 veröffentlichten Open-Source-Modells Inkling 2 Mini. Das Projekt wurde unter der freizügigen Apache-2.0-Lizenz ohne kommerzielle Einschränkungen freigegeben. Es setzt ein klares Kontrapunkt-Signal zur gängigen Branchenpraxis: Die Entwicklung hochkomplexer Software setzt nicht mehr zwingend teure Cloud-Rechencluster voraus.
Lange Zeit dominierte in der KI-Branche das Dogma der reinen Skalierung physikalischer Parameter. Tech-Giganten beschaffen routinemäßig zehntausende Spezial-Grafikkarten und verbrauchen in Supercomputer-Rechenzentren gigantische Mengen Strom. Inkling 2 Mini wählt einen anderen Weg und komprimiert den Speicherbedarf des Modells auf rund 20 GB RAM. Anspruchsvolle Inferenzaufgaben, die bislang großen Rechenzentren vorbehalten waren, laufen nun reibungslos auf mobilen Arbeitsgeräten.
24 physische Schichten für 48 Schichten Rechentiefe: Wiederverwendung identischer Gewichte
Die außerordentliche Rechendichte gelingt durch eine fundamentale Restrukturierung der Netzwerkschichten. Die Transformer-Architektur herkömmlicher Sprachmodelle agiert wie ein klassisches Fließband: Bei jedem erzeugten Token durchläuft die Information die Schichten von vorne bis hinten exakt einmal. Das neue Modell bricht mit dieser Einbahnstraße und nutzt eine rekurrente Transformer-Architektur (Recurrent Transformer), bei der ausgewählte Schichten mehrfach durchlaufen werden.
Das Modell verfügt über 24 physische Schichten. Bei der Token-Generierung übernehmen Schichten 1 bis 5 zunächst die Extraktion grundlegender Merkmale. Anschließend wird der mittlere Block aus den Schichten 6 bis 17 (insgesamt 12 Schichten) dreimal hintereinander repetitiv durchlaufen. Die abschließenden Schichten fassen die Ergebnisse zusammen, sodass der Gesamtprozess einer Berechnungstiefe von 48 Schichten entspricht.
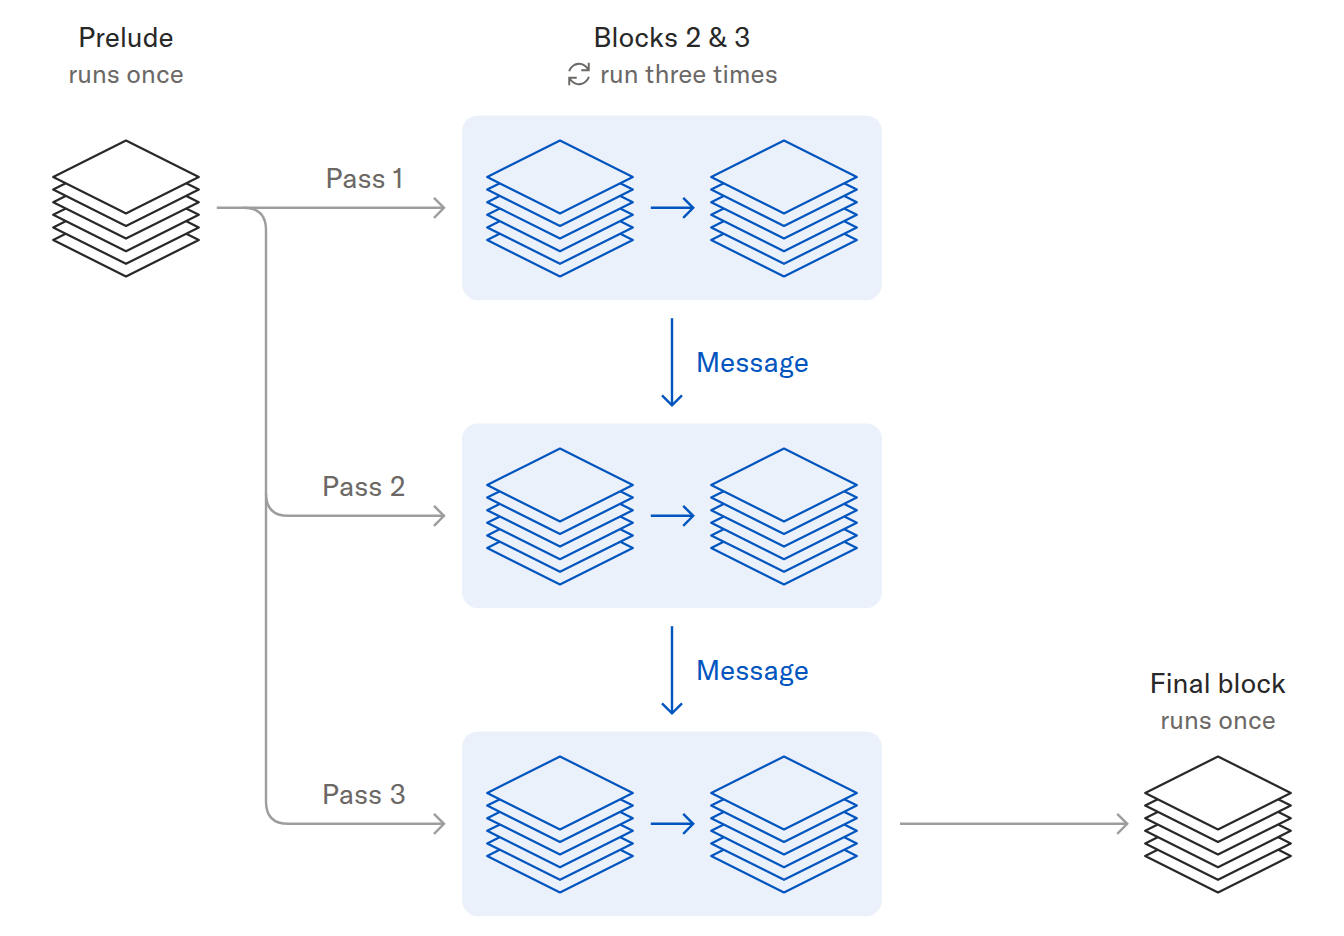 Abb.: Schematische Darstellung der Architektur: Vordere Schichten laufen einmal, der mittlere Block dreimal zyklisch, die Endschichten einmal. Quelle: Thinking Machines Lab
Bei allen drei Durchläufen greift das System auf exakt denselben physischen Gewichtssatz zu. Die physikalische Gesamtparameterzahl bleibt konstant bei 26,4 Milliarden (26.4B), wobei die anfänglich aktiven Parameter lediglich 3,4 Milliarden betragen. Durch die dreifache Wiederverwendung der Zwischenschichten steigt die effektive Rechenleistung pro Token auf ein Äquivalent von 5,4 Milliarden Parametern. Die zusätzliche Rechenlast schlägt sich in der Ausführungszeit des Prozessors nieder, belastet jedoch nicht den Arbeitsspeicher.
Dieser Mechanismus verlagert den Hardware-Flaschenhals von der VRAM-Kapazität auf die Auslastung der Rechenkerne. Um bisher eine Inferenz-Tiefe von 48 Schichten auf Edge-Geräten zu erzielen, benötigten Anwender teure Spezialhardware mit enormen VRAM-Kapazitäten. Inkling 2 Mini tauscht Rechenzeit gegen Speicherplatz und holt bei identischem Speicherbedarf die doppelte logische Rechentiefe heraus.
Rechenleistung in 20 GB Arbeitsspeicher: Nativ niedrige Präzision ohne nachträgliche Rundungsverluste
Neben der passenden Architektur entscheidet vor allem das Datenformat darüber, ob ein Modell flüssig auf Endgeräten läuft. Bisherige Open-Source-Modelle werden typischerweise mit 16-Bit-Gleitkommazahlen (FP16/BF16) trainiert und erst im Nachhinein über Quantisierungsverfahren auf 4 oder 8 Bit gestutzt. Bei diesem nachträglichen Beschnitt gehen häufig sensible Gewichtsinformationen verloren, was bei mehrstufigen Programmieraufgaben zu gravierenden Logikfehlern führt.
Inkling 2 Mini setzt daher von Beginn des Vortrainings an auf ein natives Niedrigpräzisionsformat. Die ersten 20 Schichten basieren nativ auf dem von Nvidia forcierten 4-Bit-Gleitkommaformat NVFP4; die finalen vier Schichten nutzen das mikroskalierte Gleitkommaformat MXFP8. Da das Modell ab Werk nativ optimiert vorliegt, entfällt jede verlustbehaftete Nachkonvertierung. Der Speicherbedarf des gesamten Gewichtssatzes bleibt stabil bei rund 20 GB.
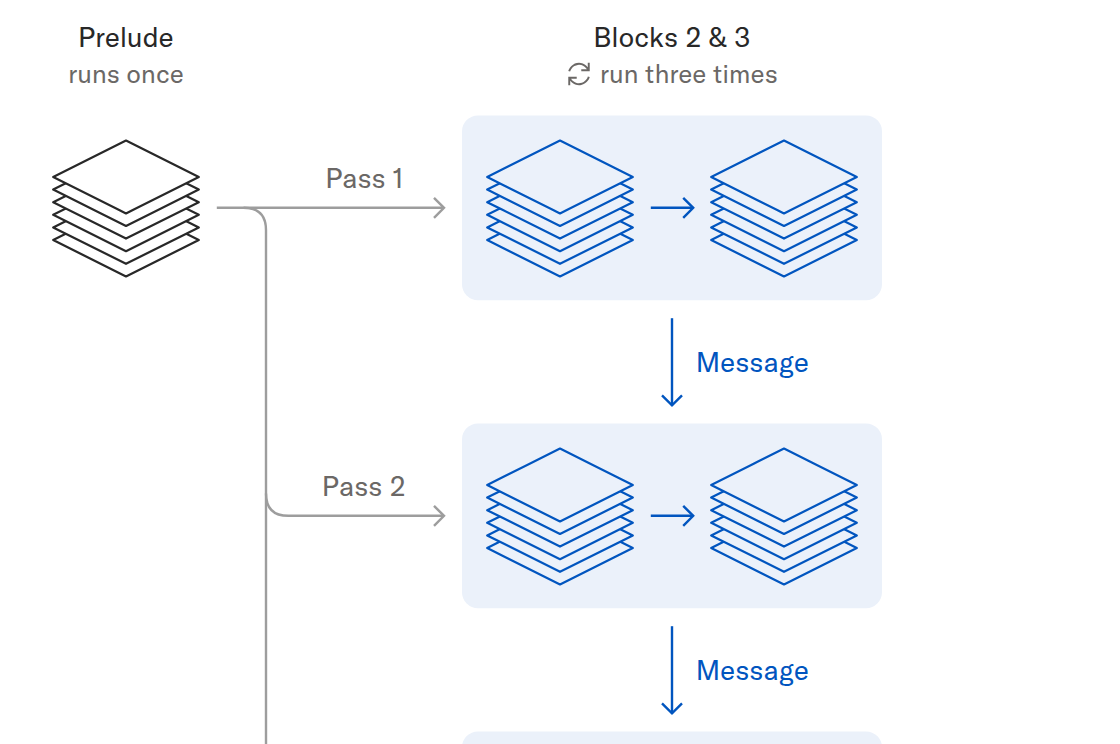 Abb.: Offizielle Benchmark-Grafik: Dekodierungsgeschwindigkeit im Verhältnis zur Lösungsquote. Quelle: Thinking Machines Lab
In praxisnahen Benchmarks für Softwaretechnik und logisches Schließen erzielte dieses Design herausragende Ergebnisse. Im anspruchsvollen DeepSWE v1.1-Benchmark für reale Software-Engineering-Probleme erreichte das Modell eine Lösungsquote von 48,2 %. Im Vals Index v2.2, der komplexe logische Deduktion misst, erzielte es 46,5 %. In der Kategorie aller Open-Weight-Modelle unter 100 Milliarden Parametern belegt Inkling 2 Mini damit in beiden Prüfungen den ersten Platz.
Die Open-Source-Community reagierte umgehend. Entwickler stellten spezialisierte Quantisierungs-Compiler bereit, die den Speicherbedarf auf bis zu 5,4 GB reduzieren und dabei bessere Perplexitätswerte als traditionelle Q4_K_M-Formate liefern. Auf Systemen mit Ryzen 395 und Vulkan-Backend erreicht die lokale Inferenz 27 Token pro Sekunde; selbst ein älteres M1 Pro erreicht alltagstaugliche 10 Token pro Sekunde. Die autarke Entwicklung direkt auf dem Endgerät ist damit greifbare Realität geworden.
Gedankengänge im Verborgenen: Token-Einsparung auf Kosten der Sicherheitskontrolle
Hinter diesem Effizienzsprung verbirgt sich ein technologischer Paradigmenwechsel. Modelle wie OpenAI o1 setzen auf explizite Gedankenketten (Chain of Thought), bei denen tausende Text-Token generiert werden, um den internen Denkpfad sichtbar zu machen. Inkling 2 Mini komprimiert die sequentielle Logik hingegen direkt in verborgene Zustände (Hidden States) des Netzwerks, ohne dass hierfür Zwischenschritte als Text ausgegeben werden müssen.
Labormessungen untermauern dieses Prinzip: Ohne textuelle Ausgabe verlängerte sich die Rechenzeit für einen einzelnen Gedankenschritt von 16 Sekunden (bei einem Durchlauf) auf 37 Sekunden bei drei Zyklen. Bei rein sequentiellen Logikrätseln stieg die Lösungsqualität selbst bei bis zu zehn Durchläufen weiter an. Die Schichten-Rekurrenz verleiht jedem einzelnen erzeugten Token eine ungleich höhere gedankliche Informationsdichte.
Diese implizite Deduktion eliminiert die Ausgabelatenz textintensiver Denkketten und senkt die Token-Kosten drastisch. Gleichzeitig stellt sie die Sicherheitsaufsicht vor ein gravierendes Problem: Da die gesamte logische Deduktion im hochdimensionalen Vektorraum stattfindet, können externe Schutzmechanismen verdächtige Muster nicht mehr auf Text-Token-Ebene erkennen oder abfangen. Zwar zeigt das Modell in Tests keine gesteigerten Schadensneigungen, klassische textbasierte Sicherheitsfilter verlieren jedoch ihr direktes Eingriffsfenster.
Interne Evaluierungen machten zudem praxisrelevante Grenzen deutlich. Bei komplexen Multi-Turn-Dialogen mit dichten Restriktionen fiel das Modell im MultiChallenge-Test auf 50,0 % und bei den ComplexConstraints auf 33,4 % ab. Ohne steuernde externe Prompts verfiel das Modell gelegentlich in endlose Selbstkontrollschleifen, bei denen Rechenleistung verpuffte, ohne dass ein Fortschritt erzielt wurde. Bei mehrsprachigen Tests zeigten sich in chinesischen Ausgaben zudem stellenweise syntaktische Unschärfen und unmotivierte Sprachwechsel.
Physikalische Parametergrenzen bleiben bestehen: Neue Taktik für kompakte Modelle
Trotz aller Stärken stößt auch die rekurrente Architektur an klare Grenzen. Das mehrfache Durchlaufen von Netzwerkschichten vertieft die sequentiellen Schlussfolgerungen, erzeugt jedoch kein neues Weltwissen. Faktische Wissens-Benchmarks belegen eindeutig, dass der Wissensumfang des Modells dem Standard seiner physikalischen Größenklasse entspricht. Das Wissensgedächtnis bleibt strikt an das physikalische Gesamtgewicht gekoppelt.
Um zu verhindern, dass sich das Modell bei komplexen Aufgaben in iterativen Schleifen verfängt, empfehlen die Entwickler klare Leitplanken im produktiven Einsatz. So sollten Systeme feste Obergrenzen für die maximale Token-Anzahl und die Dialogrunden vorgeben. Diese Vorgaben verhindern eine sinnlose Auslastung der Rechenressourcen und schaffen eine wirksame Notbremse im autonomen Betrieb. Systemische Kontrollmechanismen gleichen somit die konzeptionellen Schwächen des Algorithmus aus.
Die eigentliche Leistung von Inkling 2 Mini liegt im Nachweis, dass der Zwang zur bloßen Hardware-Skalierung durchbrochen werden kann. Angesichts explodierender Infrastrukturkosten und Chip-Engpässen bietet die zirkuläre Mehrfachnutzung von Netzwerkschichten einen eleganten Ausweg. Wie sich verdeckte Repräsentationen in Vektorräumen künftig transparent interpretieren und absichern lassen, wird zur Kernfrage der kommenden Generation mobiler KI-Systeme.
Weiterführende Links:
- Offizieller technischer Bericht von Thinking Machines Lab
- Technische Diskussion in der Hacker News Community
- DeepSWE Benchmark-Rangliste