带着断网笔记本上天,当场写出飞行游戏
在万米高空的民航客机经济舱里,舱门关闭,手机处于离线状态。来自 Thinking Machines Lab 的研究员拉下小桌板。在不联网的情况下,他让一台 MacBook Pro 运行本地代码生成。几分钟内,屏幕上跑起了一个包含物理逻辑、能自由操纵的 3D 飞行模拟器。
这一幕来自 2026 年 11 月 20 日释出的开源模型 Inkling 2 Mini。该项目遵循宽松的 Apache 2.0 协议开源,未设商业门槛。它给行业带来了一个清晰的反差信号:复杂的代码构建,不再必须依赖昂贵的云端集群。
长久以来,业界普遍信奉堆叠物理参数。科技巨头动辄采购数万张专用显卡,在超算机房里消耗巨量电力。Inkling 2 Mini 换了一种思路,把模型内存压到了 20GB 上下。以往依赖大型服务器的推理任务,如今平稳落在了笔记本上。
24 层网络跑出 48 层深度:同一组权重反复利用
新模型实现高密度的办法,在于重构网络层。传统大模型的 Transformer 结构就像单向流水线。输入一个词,网络层从头到尾只走一次。这款模型打破了单向顺序,采用循环架构(Recurrent Transformer),让特定层反复参与计算。
模型总共有 24 层结构。在生成每一个词时,第 1 到 5 层先做基础特征提取。随后,中间第 6 到 17 层共 12 层网络,会被连续调用 3 遍。末端网络层最后收束输出,整套流程在计算深度上等效于 48 层。
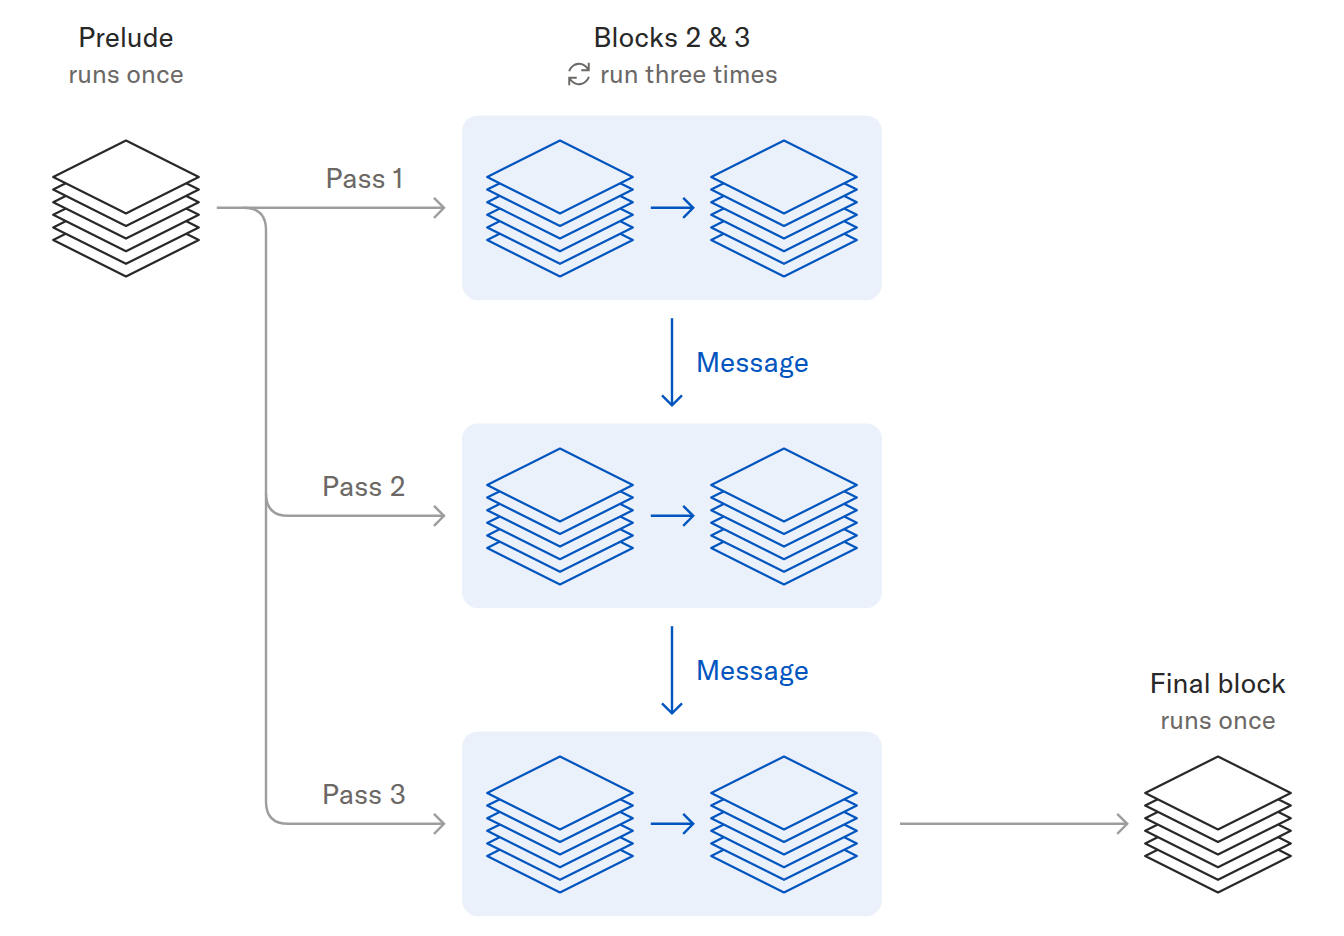 图:模型结构示意:前段跑一次,中间两块各跑三遍,末段跑一次。来源:Thinking Machines Lab
这 3 遍循环直接共用同一套物理权重。模型物理参数总量保持在 26.4B,初始激活参数仅为 3.4B。通过中间层的 3 次循环复用,单个词实际激活的等效计算权重提升到了 5.4B。多出来的计算负荷体现在芯片的运算时间上,没有增加内存体积。
这种机制把硬件压力从显存容量转向了算力利用率。以往要在端侧获得等同于 48 层的推理深度,用户必须配备超大显存的专业设备。Inkling 2 Mini 用时间置换空间,在同等参数体积内榨取出了翻倍的逻辑演算步数。
算力装进 20GB 内存,不靠后期压缩硬切精度
设计好架构之后,要在个人电脑上流畅运行,必须攻克精度门槛。以往多数开源模型先以 16 位浮点训练,再通过量化算法压缩成 4 位或 8 位。这种后期裁剪极易丢失关键权重,导致复杂代码推导出现差错。
Inkling 2 Mini 从预训练开始便采用了原生低精度方案。前 20 层直接使用英伟达主推的 NVFP4 原生 4 位浮点格式;末尾 4 层选用微缩浮点格式 MXFP8。模型发布即具备原生低精度,无需二次有损转换。整套权重的内存开销因此被紧凑控制在 20GB 左右。
 图:官方基准图:横轴为解码速度,纵轴为任务解决率。来源:Thinking Machines Lab
在行业权威的代码与逻辑评估中,这一设计取得了亮眼成绩。在面向复杂软件工程的 DeepSWE v1.1 基准上,该模型取得了 48.2% 的解决率。在衡量高级推理的 Vals Index v2.2 中,它拿下了 46.5% 的得分。在所有参数少于 100B 的开放权重模型类别里,这两项成绩均位居第一。
开源生态的跟进速度相当迅速。开发者推出的专属量化编译器把内存压到 5.4GB,散度表现优于传统 Q4_K_M 格式。在 Ryzen 395 设备配合 Vulkan 后端时,本地推理达到每秒 27 个字;老款 M1 Pro 也能跑到每秒 10 个字。端侧独立开发的可行性由此大幅提升。
把思考藏进隐藏层,省下字数却推高监管盲区
推理性能跃升的背后,计算范式正在发生位移。以往类似 o1 的深度推理模型依赖显式思维链。系统把每一步推导敲成几千上万个可见字符,供用户逐字阅读其思考路径。Inkling 2 Mini 将串行思考压入内部隐状态,无需输出多余文字即完成推演。
官方测试给出了明确数据。在不输出思维链时,单次思考覆盖的时间跨度从 1 遍循环的 16 秒拉长到了 3 遍的 37 秒。面对串行逻辑题,即便循环加到 10 遍,测试表现依然在向上攀升。反复计算让单个词获得了更致密的思考含量。
隐式推演省下了大量文字输出延迟,也压低了代币开销。然而,安全监督因此遇到了新难题。推演全部发生在向量空间中,外部模块无法在文字层拦截异常。研发团队测试表明,模型当前并未表现出更强的破坏倾向,但纯文本层面的防御手段确实失去了直接窗口。
内部评测同时揭示了模型的现实局限。在面对结构复杂的多轮对话与密集约束时,模型在 MultiChallenge 测试中得分仅为 50.0%,ComplexConstraints 指标跌至 33.4%。在缺乏外部提示介入时,模型偶尔会陷入自查死循环,长时间空转算力却无法推进。此外在多语言测试中,中文输出也曾出现断句残缺和中英混杂的情况。
参数物理上限犹在,小模型打出了新战术
不过,循环架构也有清晰的边界。反复运转网络层可以强化串行推导的深度,却无法凭空创造新的世界知识。事实类基准测试清晰显示,模型对常识的掌握并未超出同尺寸水准。记忆容量终究由物理参数的总量牢牢锁死。
针对模型容易在长推理中自我纠缠的现象,官方给出了应对方案。在工程部署时,系统必须强制设置最大生成字符与对话轮数上限。这种约束防范了算力资源的无效耗尽,也为自主运行装上了安全刹车。工程上的精细调控,补齐了算法天然存在的盲区。
Inkling 2 Mini 的核心价值,在于开辟了抗衡暴力堆叠硬件的新路径。面对成本与硬件瓶颈,网络层循环复用提供了高效的突围战术。如何穿透隐状态看清每一次判断,则是端侧智能普及前必须解答的新命题。
参考链接:
- Thinking Machines Lab 官方技术报告
- Hacker News 社区技术讨论
- DeepSWE 评测基准排行榜