Am 6. Oktober 2026 veröffentlichte OpenAI ohne Vorankündigung ein umfangreiches Code-Paket in einem GitHub-Repository: 722 mathematische Manuskripte, generiert von neuesten Spitzenmodellen. Bei diesen Dokumenten, die sich über 372 sogenannte Ergebnisfamilien (result families) erstrecken, fehlt bei mehr als einem Drittel der maschinell verifizierbare Beweiscode. Während das Repository innerhalb von 24 Stunden 9.300 Sterne und 903 Forks verzeichnete, versah OpenAI 137 dieser Ergebnisfamilien selbst mit dem Vermerk, dass sie potenziell fehlerhaft seien.
722 Manuskripte, aber nur 235 maschinenlesbare Beweise
Die unter dem Titel „Sharing AI progress in mathematics“ veröffentlichte Sammlung umfasst gewaltige mathematische Deduktionen. Der Inhalt des Repositorys besteht zu 92,1 Prozent aus Lean-Formalisierungscode, die restlichen 7,8 Prozent entfallen auf mit LaTeX gesetzte Dokumente. Die 722 Manuskripte sind in 372 Ergebnisfamilien gegliedert, von denen jede einen Hauptsatz nebst begleitenden Lemmata umfasst. Das thematische Spektrum reicht von elementarer Zahlentheorie bis hin zu fortgeschrittener Strömungsmechanik.
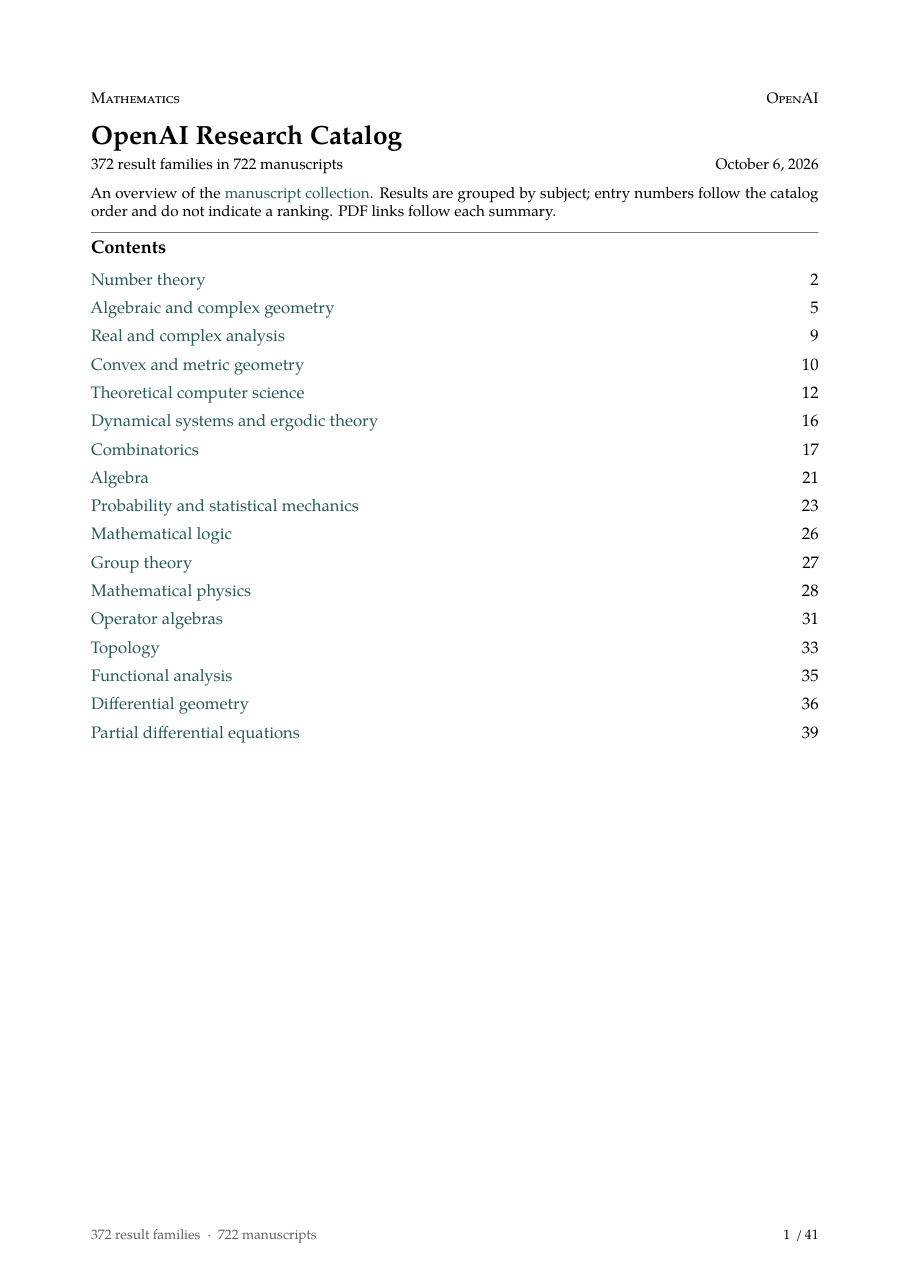 Abbildung: Titelseite der Datei overview.pdf mit Angaben zu 372 Ergebnisfamilien und 722 Manuskripten. Quelle: OpenAI Math-Repository overview.pdf
Hinter dem schieren Umfang verbirgt sich jedoch ein extremes Ungleichgewicht: Von den 372 Ergebnisfamilien verfügen lediglich 235 über lauffähige, formal geprüfte Lean-Beweise. Die restlichen 137 Dokumente, die von OpenAI selbst als zweifelhaft eingestuft wurden, wurden der Open-Source-Gemeinschaft ohne formale Absicherung übergeben. Dem Repository liegt eine 41-seitige overview.pdf als Gesamtverzeichnis bei, die den Release in eine Art überprüfbare Rechenleistungs-Bilanz verwandelt.
Laut dieser Bilanz erforderte die Generierung eines solchen mathematischen Ergebnisses im Schnitt lediglich drei Stunden Inferenz-Rechenleistung auf ChatGPT Pro. Die Grenzkosten für das Erzeugen mathematischer Beweise wurden durch massive Rechenkapazitäten drastisch gesenkt – die Kosten für deren Verifikation hingegen blieben unverändert hoch. Diese gewaltige Diskrepanz zwischen Generierungs- und Verifikationskapazität wälzt die mühsame Fehlersuche de facto auf die akademische Mathematik ab.
Drei Stunden Rechenzeit gegen vierundzwanzig Menschenjahre
Unter den Manuskripten ohne formalen Maschinenbeweis finden sich Angriffe auf notorisch hartnäckige historische Probleme. Ergebnis 001 widmet sich Milnes rationaler Vermutung, während Ergebnis 002 auf die Vermutung von Birch und Swinnerton-Dyer (BSD) zielt. Am bemerkenswertesten ist Ergebnis 180: ein vollständiges Preprint mit einem Beweisversuch der Barnette-Vermutung – allerdings gänzlich ohne ausführbaren Lean-Code.
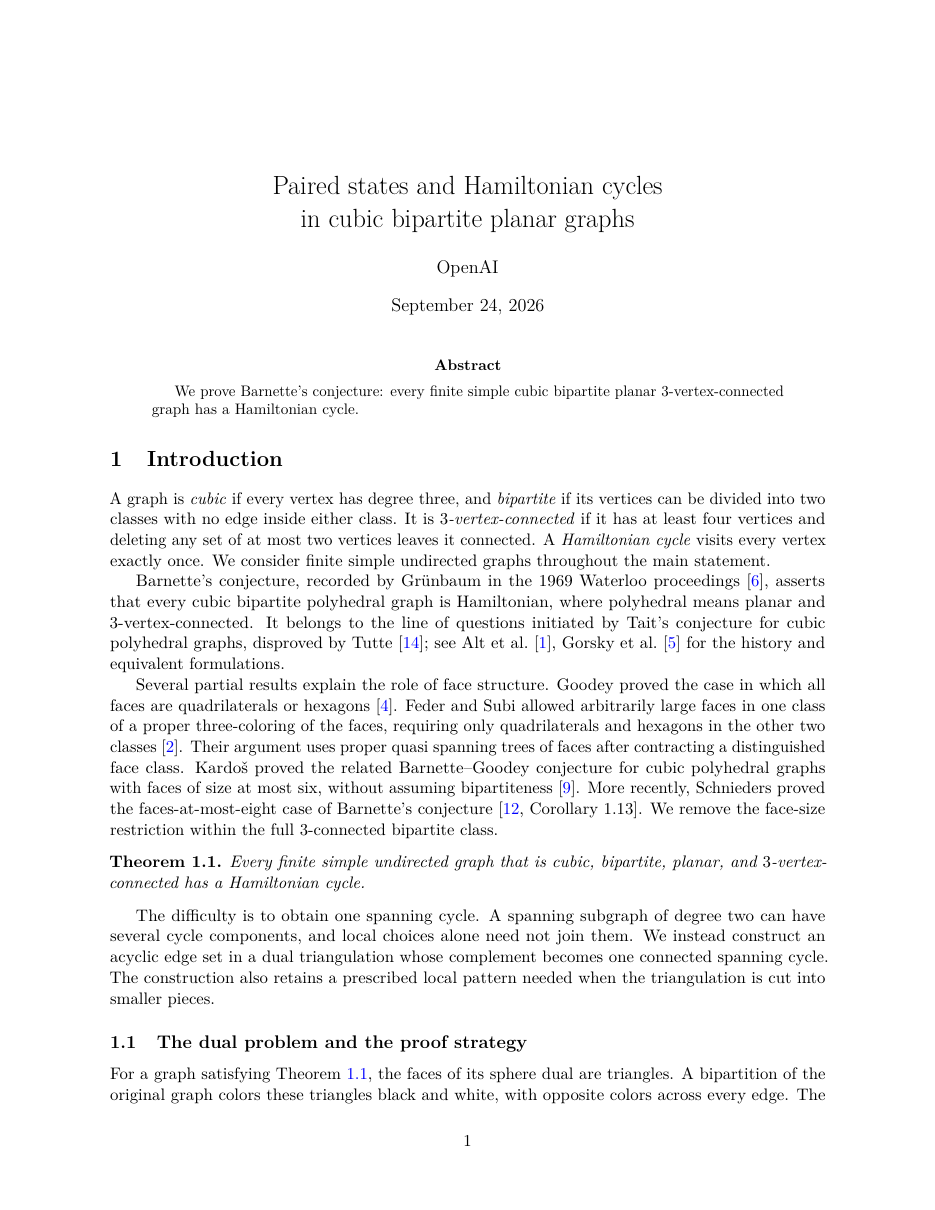 Abbildung: Titelseite der Arbeit zur Barnette-Vermutung mit OpenAI als Autor. Quelle: OpenAI Math-Repository preprints-Verzeichnis
Andere Arbeiten zeugen von ingenieurtechnischer Finesse. Ergebnis 376 demonstriert die Konstruktion universeller Berechenbarkeit (Turing-Vollständigkeit) über die Navier-Stokes-Gleichungen: Das Modell entwarf eine spezielle, glatte äußere Kraft, die bewirkt, dass eine Flüssigkeit in einem begrenzten Gebiet eine Turingmaschine simuliert, wobei der Eintritt eines Teilchens in eine bestimmte Region dem Haltezustand der Maschine entspricht. Früher benötigten interdisziplinäre Forschungsteams Jahre für derartige Durchbrüche; heute entstehen daraus Hunderte von PDF-Seiten ohne jede institutionelle Bürgschaft.
Ein Forscher, der 24 Jahre seines Lebens der Barnette-Vermutung gewidmet hatte, gestand nach der Lektüre des unvollständig verifizierten Vorabdrucks, der Schock habe sich angefühlt, als erfahre man vom tödlichen Unfall einer früheren Partnerin. Angesichts solch intransparenter Ergebnisse stehen Wissenschaftler vor der Hürde, dass ihnen nicht nur die Zeit zur manuellen Verifikation der logischen Ketten fehlt, sondern bereits die Hardwarebasis, um vergleichbare Rechengänge überhaupt zu replizieren. Rechenleistung und Modellgewichte bleiben in den Rechenzentren kommerzieller Konzerne verschlossen. Die Voraussetzung, um Spitzenmathematik nachzuvollziehen, ist nicht mehr allein das Beherrschen partieller Differentialgleichungen, sondern der Zugriff auf Cluster mit zehntausenden Hochleistungsbeschleunigern.
Unabhängiger Beirat kann die Veröffentlichungswelle nicht stoppen
Der eigentliche Konflikt liegt in der Missachtung akademischer Schutzmechanismen. Bereits am 29. September hatte die Advisory Group on Mathematics and Artificial Intelligence (AGMAI) – ein von OpenAI selbst initiiertes und am Institute for Advanced Study in Princeton angesiedeltes unabhängiges Beratungsgremium – eine deutliche Warnung publiziert.
Die Kernforderung der AGMAI war unmissverständlich: Führende KI-Labore sollten davon absehen, mit proprietären, geschlossenen Modellen im Alleingang ungelöste mathematische Probleme anzugreifen oder Ranglisten zu überfluten. Ein solches Vorgehen gefährde den jahrhundertealten Konsens über wissenschaftliche Begutachtungsprozesse und verunreinige das akademische Bewertungssystem.
Nur sieben Tage später zitierte OpenAI diese Empfehlung in seinem Veröffentlichungsbeitrag – und stellte gleichzeitig alle 722 Manuskripte online. Zwar betonte das Unternehmen, weiterhin mit Fachgesellschaften über verantwortungsvolle Publikationsformate sprechen zu wollen, schuf jedoch faktenbasiert vollendete Tatsachen. Ein kommerzielles Unternehmen, das fähig ist, über Nacht hunderte anspruchsvolle Abhandlungen zu publizieren, hat faktisch die Deutungs- und Themenhoheit über das gesamte Fachgebiet übernommen.
Die Barriere beim Lösen komplexer Aufgaben wurde durch schiere Rechengewalt durchbrochen. Diese 722 Manuskripte führen schonungslos vor Augen, dass die Massenproduktion komplexen, aber ungeprüften Wissens spottbillig geworden ist. Der Engpass der Mathematik hat sich verlagert: Es geht nicht mehr darum, wer den Lösungsweg findet, sondern wer die Ressourcen besitzt, um die Verifikation durchzurechnen. In diesem neuen Paradigma konzentriert sich das Privileg, mathematische Wahrheiten verbindlich zu beglaubigen, unaufhaltsam bei den wenigen Technologiekonzernen, die über die nötigen Serverfarmen verfügen.
Referenzen:
- OpenAI-Veröffentlichungsbeitrag
- GitHub-Repository openai/math
- Manuskriptverzeichnis CONTENTS.md
- Öffentliche Empfehlungen der AGMAI
- Hacker-News-Diskussion