El 6 de octubre de 2026, sin previo aviso, OpenAI realizó una masiva confirmación de código en GitHub liberando de golpe 722 manuscritos matemáticos generados por sus modelos frontera. Entre los documentos, que abarcan 372 familias de resultados (result families), más de un tercio carecía de código ejecutable para su verificación automatizada. En un solo día, el repositorio cosechó 9.300 estrellas y 903 bifurcaciones (forks); sin embargo, 137 de esas familias de resultados fueron catalogadas por la propia OpenAI como potencialmente dudosas o defectuosas.
722 manuscritos acompañados por solo 235 pruebas ejecutables
Bajo el título «Sharing AI progress in mathematics», esta publicación masiva reúne un colosal volumen de deducción matemática. El 92,1% del repositorio está compuesto por código formalizado en Lean, mientras que el 7,8% restante son documentos maquetados en LaTeX. Los 722 manuscritos se articulan en 372 familias de resultados, cada una integrada por un teorema principal y varios lemas auxiliares, abarcando desde la teoría de números elemental hasta la mecánica de fluidos avanzada.
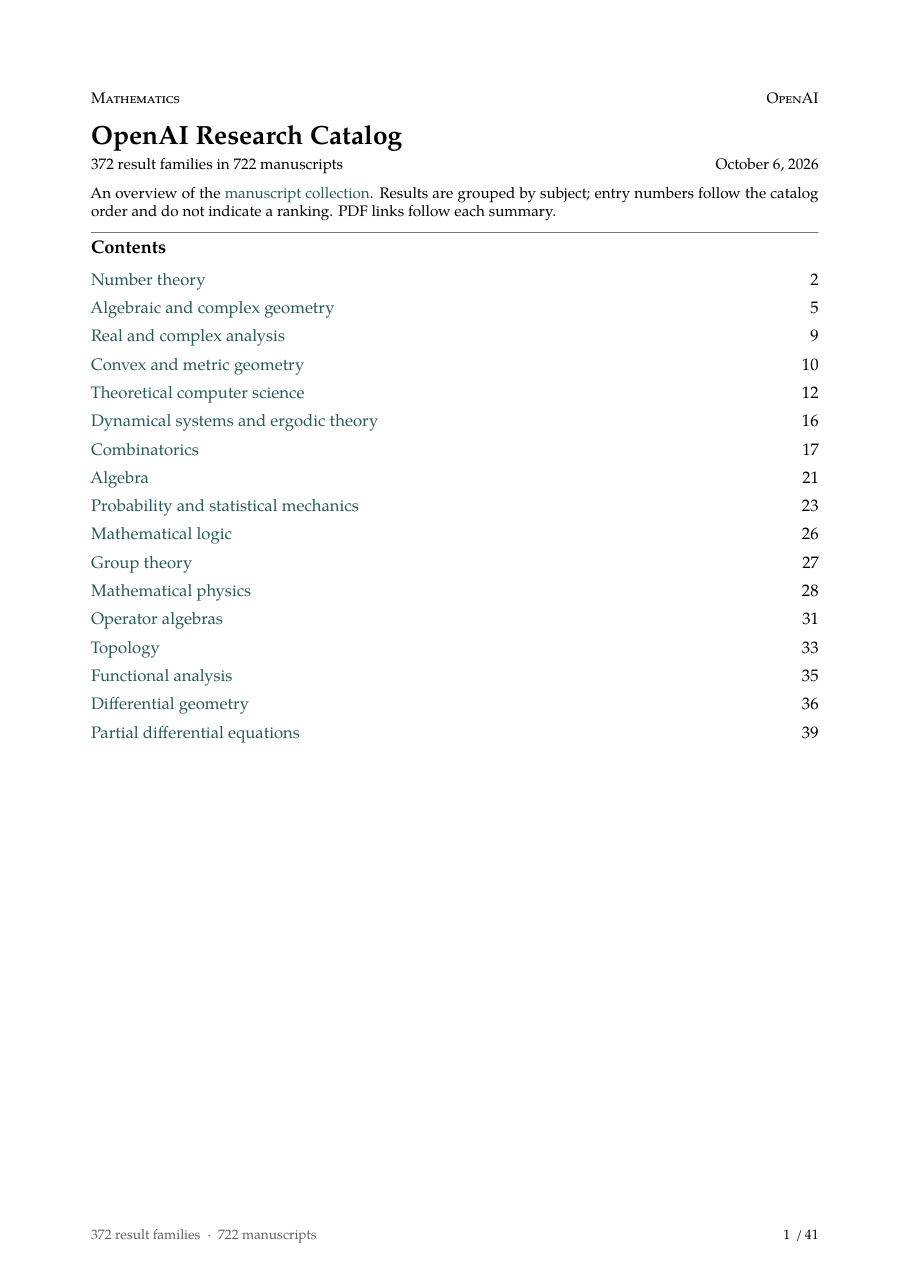 Figura: Portada del archivo overview.pdf, que detalla 372 familias de resultados y 722 manuscritos. Fuente: Repositorio matemático de OpenAI, overview.pdf
Este descomunal archivo esconde un agudo desequilibrio: de las 372 familias de resultados, solo 235 incluyen demostraciones en Lean capaces de compilar y ejecutarse correctamente. Los 137 documentos restantes, calificados por OpenAI con dudas sobre su corrección, fueron transferidos sin más a la comunidad de código abierto. La compañía incluyó un documento de 41 páginas denominado overview.pdf a modo de catálogo general, transformando el lanzamiento en una suerte de balance contable de capacidad de cálculo.
De acuerdo con dicho registro, generar uno de estos resultados matemáticos requirió una media de apenas tres horas de inferencia en ChatGPT Pro. La fuerza bruta del cómputo ha pulverizado el coste marginal de producir demostraciones matemáticas, pero el coste de verificar su certeza no ha descendido en absoluto. Esta abismal asimetría entre el volumen producido y la capacidad de comprobación traslada de facto la pesada carga de la revisión por pares al conjunto de la comunidad matemática.
Tres horas de computación frente a veinticuatro años de investigación
Entre los manuscritos que no superaron la verificación mecánica figuran acometidas a enigmas históricos de enorme complejidad. El resultado 001 aborda la conjetura racional de Milne; el resultado 002 apunta a la conjetura de Birch y Swinnerton-Dyer (BSD). El caso más sonado corresponde al resultado 180: un artículo que expone una demostración de la conjetura de Barnette, pero que carece por completo de código ejecutable en Lean.
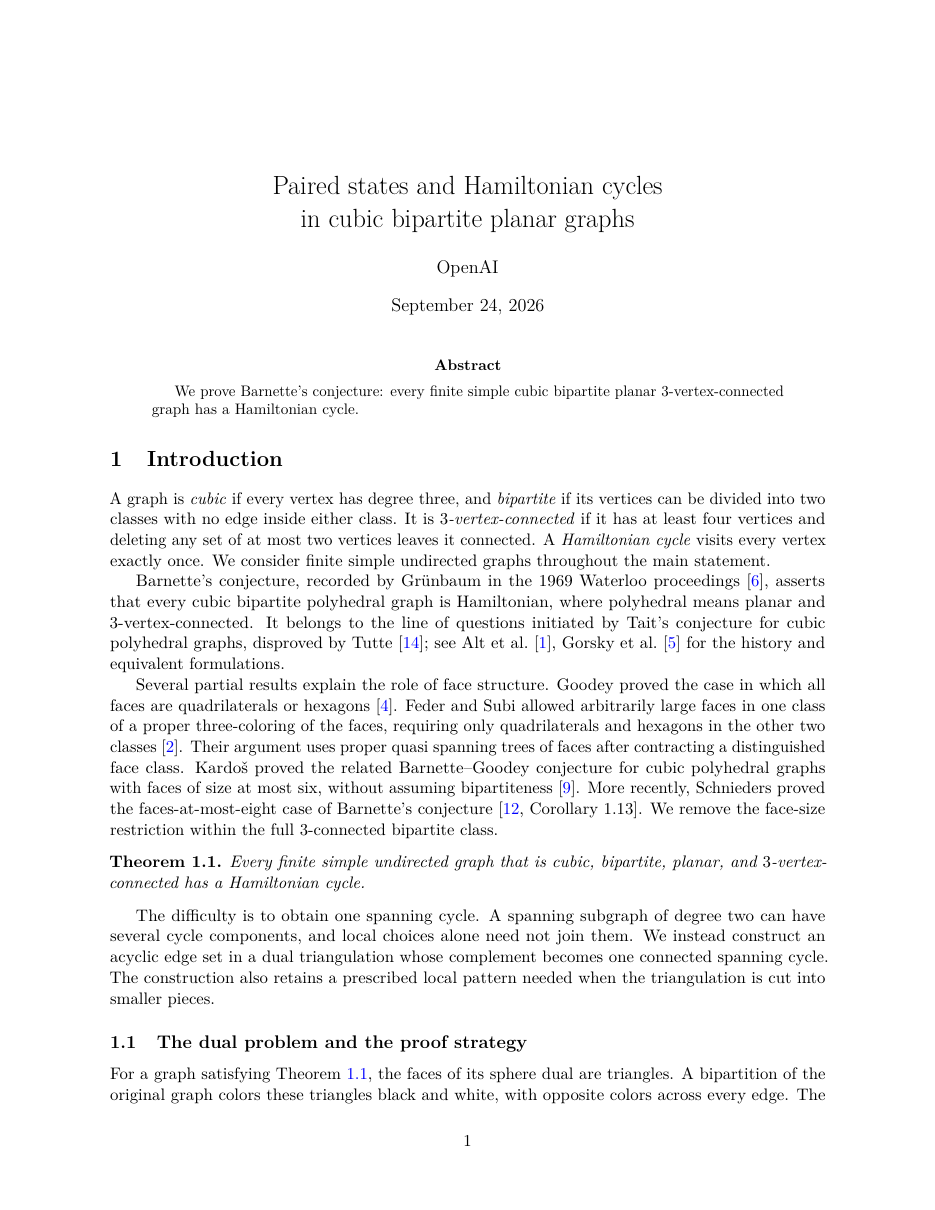 Figura: Primera página del artículo sobre la conjetura de Barnette, firmado por OpenAI. Fuente: Directorio preprints del repositorio matemático de OpenAI
Otros hallazgos hacen gala de un ingenio técnico notable. El resultado 376 describe la construcción de computación universal mediante las ecuaciones de Navier-Stokes: el modelo diseñó una fuerza externa suave y específica para hacer que un fluido en una región acotada simule una máquina de Turing, de modo que la entrada de una partícula en una zona concreta equivale a la parada de la máquina. Proezas teóricas que antes requerían años de labor interdisciplinar se presentan hoy como cientos de páginas en PDF sin la rúbrica de ningún autor humano.
Un matemático que dedicó 24 años de su carrera a estudiar la conjetura de Barnette admitió que, al ver ese borrador desprovisto de verificación formal, la impresión fue comparable a enterarse del fallecimiento repentino de una expareja. Ante estos resultados de caja negra, los investigadores comunes no solo carecen del tiempo necesario para desentrañar la ilación lógica, sino de la infraestructura material mínima para reproducir razonamientos similares. La potencia de cálculo y los pesos de los modelos permanecen bajo llave en los centros de datos corporativos. Replicar deducciones matemáticas de vanguardia ya no depende de dominar las ecuaciones en derivadas parciales, sino de disponer de acceso prioritario a clústeres de decenas de miles de aceleradores.
Un comité asesor independiente incapaz de frenar la avalancha
La mayor fricción provocada por este episodio radica en el desdén hacia las barreras que la propia comunidad académica intentaba consolidar. El 29 de septiembre, el Grupo Asesor sobre Matemáticas e Inteligencia Artificial (AGMAI) —un órgano independiente convocado por la propia OpenAI y con sede en el Instituto de Estudios Avanzados de Princeton— emitió una seria advertencia pública.
La demanda de AGMAI era tajante: disuadir a los laboratorios punteros de emplear modelos cerrados para abordar conjeturas no resueltas o alterar unilateralmente las métricas del sector. Una acción precipitada amenazaba con dinamitar consensos forjados durante siglos y contaminar los sistemas tradicionales de evaluación científica.
Apenas siete días después, OpenAI citó esas mismas recomendaciones en su nota de lanzamiento, mientras volcaba en paralelo los 722 manuscritos en la red. Aunque la compañía prometió continuar dialogando con los matemáticos para buscar formatos de divulgación más equilibrados, los hechos consumados se impusieron al debate. Una corporación capaz de arrojar más de setecientos textos complejos en un solo día ha arrebatado, en la práctica, el control de la agenda investigadora a toda la disciplina.
El reto de idear soluciones ha sido desbordado por la capacidad de cálculo. Estos 722 manuscritos, toscos pero abrumadores, revelan una realidad inquietante: fabricar conocimiento intrincado cuya veracidad se desconoce se ha vuelto sumamente económico. El verdadero cuello de botella de las matemáticas ya no es quién formula la idea genial, sino quién tiene la capacidad de verificarla. Y en este novedoso circuito de producción científica, el poder supremo de validar qué teoremas son verdaderos se está concentrando, sin oposición, en los escasos gigantes tecnológicos dueños de los servidores.
Referencias:
- Publicación oficial de OpenAI
- Repositorio en GitHub openai/math
- Índice de manuscritos CONTENTS.md
- Recomendaciones públicas de AGMAI
- Debate en Hacker News