2026년 10월 6일, OpenAI는 사전 예고도 없이 GitHub 저장소에 커밋을 올리며 프론티어 모델이 생성한 722편의 수학 원고를 한꺼번에 공개했다. 총 372개 결과군(result families)에 걸친 이 방대한 문서 중 3분의 1 이상은 기계로 검증 가능한 증명 코드가 누락되어 있었다. 단 하루 만에 스타 9,300개와 포크 903개를 기록하며 폭발적인 관심을 모은 이 저장소에서, 137개 결과군은 심지어 OpenAI 공식 측에서 직접 “오류 가능성 있음(questionable)“이라는 딱지를 붙여놓은 상태였다.
722편의 원고에 실행 가능한 검증 코드는 단 235개
“Sharing AI progress in mathematics”라는 이름으로 단행된 이번 대규모 공개는 방대한 양의 수학적 연역을 담고 있다. 저장소 파일의 92.1%는 린(Lean) 정형화 코드이며, 나머지 7.8%는 LaTeX로 조판된 논문 문서다. 722편의 원고는 372개 결과군으로 분류되어 있으며, 각 결과군은 핵심 정리 하나와 부수적인 보조정리들로 구성된다. 다루는 분야 역시 기초 정수론부터 고등 유체역학에 이르기까지 광범위한 스펙트럼을 아우른다.
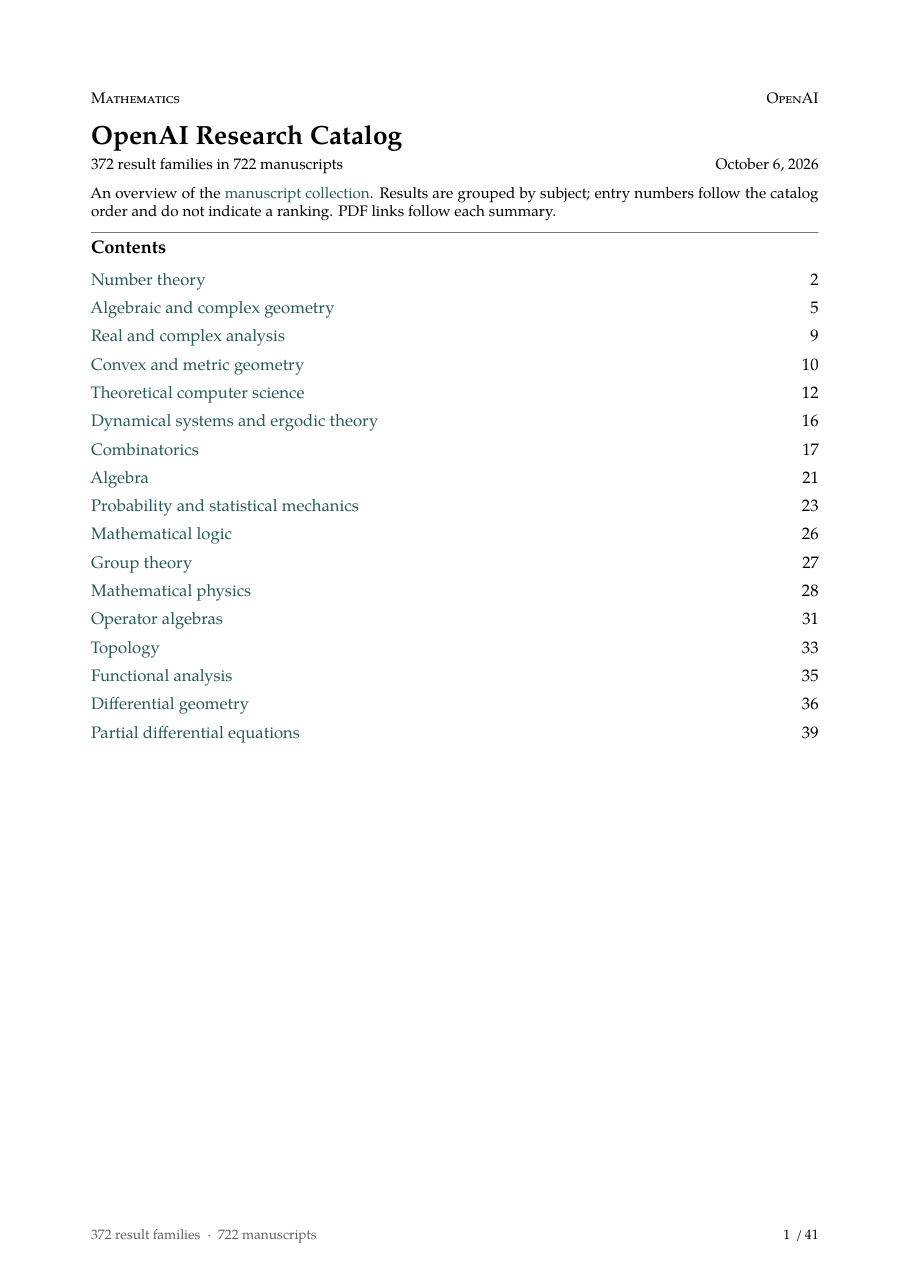 그림: 저장소 내 overview.pdf 표지. 372개 결과군과 722편의 원고를 명시하고 있다. 출처: OpenAI 수학 원고 저장소 overview.pdf
그러나 겉보기의 웅장함 이면에는 치명적인 불균형이 자리 잡고 있었다. 372개 결과군 가운데 실제로 컴파일되어 기계 검증을 통과하는 Lean 증명 코드가 붙어 있는 것은 235개에 불과했다. OpenAI 스스로 결함 가능성을 표시해 둔 나머지 137개 문서는 아무런 담보 없이 오픈소스 커뮤니티로 던져졌다. 공식 저장소에는 41쪽짜리 overview.pdf 문서가 총목록 형태로 포함되어 이번 배포를 확인 가능한 컴퓨팅 결산서처럼 정리해 두었다.
공개된 연산 장부에 따르면, 이러한 수학적 결과 하나를 산출하는 데 소모된 연산량은 ChatGPT Pro 기준으로 평균 3시간의 추론 컴퓨팅에 불과했다. 기계가 수학적 증명을 만들어내는 한계비용은 대규모 연산 자원에 의해 완전히 붕괴되었지만, 이를 검증하는 비용은 조금도 줄어들지 않았다. 생성 속도와 검증 역량 사이의 이 거대한 격차는 오류 검증이라는 고된 노동을 고스란히 수학계 전반에 전가하고 있다.
3시간의 컴퓨팅 연산이 뒤흔든 수학자의 24년
기계 검증을 거치지 못한 원고들 중에는 수학사에서 난공불락으로 여겨지던 난제들이 대거 포함되어 있다. 결과 001번은 밀른(Milne)의 유리수 추측에 도전하고, 결과 002번은 버치-스위너턴다이어(BSD) 추측을 정조준한다. 가장 충격적인 것은 바넷(Barnette) 추측을 다룬 결과 180번으로, 완성된 논문 형태를 갖추고 있으면서도 실행 가능한 Lean 코드는 전혀 제공되지 않았다.
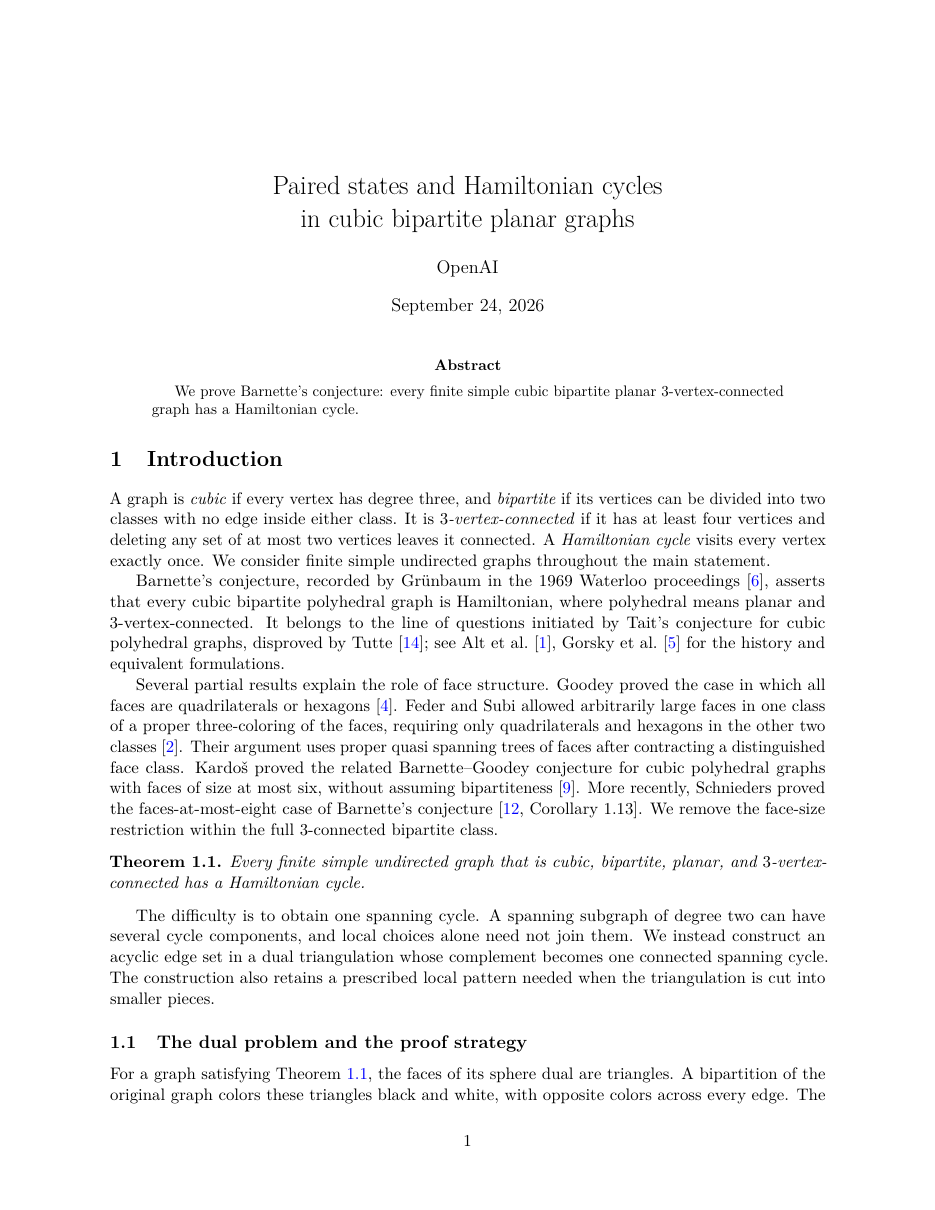 그림: Barnette 추측을 다룬 논문 첫 페이지, 저자는 OpenAI로 표기됨. 출처: OpenAI 수학 원고 저장소 preprints 디렉터리
공학적 기지를 발휘한 결과물들도 눈에 띈다. 결과 376번은 나비에-스토크스 방정식을 이용해 범용 계산(튜링 완전성)을 구현하는 구성을 담았다. AI는 특수한 매끄러운 외력을 설계하여 닫힌 영역 내부의 유체가 튜링 머신을 모사하도록 만들었으며, 유체 입자가 특정 영역에 도달하는 과정을 튜링 머신의 정지 문제와 동치로 연결했다. 과거에는 다학제 연구팀이 수년간 매달려야 했던 연구가 이제는 누구의 서명도 보증도 없는 수백 쪽의 PDF 파일로 쏟아져 나온 것이다.
바넷 추측에 무려 24년의 세월을 바쳐온 한 연구자는 형식 검증이 빠진 이 논문을 접한 뒤, 마치 옛 연인이 교통사고로 세상을 떠났다는 소식을 들었을 때와 같은 상실감을 느꼈다고 털어놓았다. 이러한 블랙박스형 결과물 앞에서 일반 연구자들은 논리적 전개의 무결성을 따져보기는커녕, 유사한 아이디어를 재현해 볼 하드웨어 인프라조차 갖추지 못하고 있다. 컴퓨팅 자원과 모델 가중치는 상업 기업의 데이터센터 안에 단단히 갇혀 있다. 고난도 수학적 추론을 재현하기 위한 전제 조건은 이제 편미분방정식을 깊이 이해하는 능력이 아니라, 수만 장의 가속기 클러스터를 가동할 권한을 가졌는가로 바뀌었다.
독립 자문단의 권고를 앞질러 간 프론티어 모델의 독주
이번 사태의 가장 본질적인 갈등은 학술 생태계가 지키고자 했던 최소한의 방어선마저 무력화했다는 데 있다. 앞서 9월 29일, OpenAI 스스로 소집하고 프린스턴 고등연구소(IAS)에 둥지를 튼 독립 자문 기구 AGMAI는 엄중한 공개 권고안을 내놓은 바 있다.
AGMAI의 핵심 요구는 분명했다. 최전선 AI 연구소들이 폐쇄형 모델을 사용해 미해결 수학 난제를 일방적으로 발표하거나 벤치마크 순위를 독식하지 말라는 경고였다. 검증 없는 일방적 행동은 수백 년간 축적되어 온 학술적 평가 체계의 합의를 깨뜨리고 학계 전반을 오염시킬 수 있기 때문이다.
그러나 불과 7일 뒤, OpenAI는 공식 발표문에서 해당 권고안을 인용하면서도 뒤로는 722편의 원고 전체를 인터넷에 공개해 버렸다. 수학계와 더 나은 공개 방식을 논의하겠다는 입장을 덧붙였지만, 행동은 이미 합의를 앞질러 이루어졌다. 하룻밤 사이에 700편이 넘는 고품질 원고를 투하할 수 있는 거대 기업이 사실상 해당 학문 분야의 의제 설정권을 독점하게 된 셈이다.
‘문제를 푸는’ 단계의 장벽은 이미 압도적인 연산력에 의해 허물어졌다. 거칠지만 거대한 위압감을 풍기는 이 722편의 원고는 냉혹한 진실을 드러낸다. 참과 거짓이 불분명한 복잡한 지식을 대량 생산하는 행위는 이제 믿을 수 없을 만큼 저렴해졌다. 수학의 병목점은 ‘누가 기발한 해법을 떠올리는가’에서 ‘누가 검증 과정을 완주할 자원을 쥐고 있는가’로 완전히 이동했다. 그리고 이러한 새로운 지식 생산 파이프라인에서 정리의 옳고 그름을 공인하는 최종 권력은, 거대한 서버 클러스터를 장악한 극소수 빅테크 기업으로 막힘없이 집중되고 있다.
참고 링크:
- OpenAI 공식 발표
- GitHub openai/math 저장소
- CONTENTS.md 원고 목록
- AGMAI 공개 권고문
- Hacker News 토론