Le 6 octobre 2026, sans avertissement préalable, OpenAI a déposé sur un dépôt GitHub pas moins de 722 manuscrits mathématiques rédigés par ses modèles de pointe. Parmi ces documents couvrant 372 familles de résultats (result families), plus d’un tiers ne contenait aucun code de preuve vérifiable par machine. Alors que le dépôt engrangeait 9 300 étoiles et 903 forks en l’espace de vingt-quatre heures, 137 de ces familles de résultats étaient explicitement étiquetées par OpenAI comme « potentiellement problématiques ».
722 manuscrits pour seulement 235 preuves exécutables
Intitulée « Sharing AI progress in mathematics », cette publication massive rassemble un volume vertigineux de déductions mathématiques. Dans ce dépôt, 92,1 % du contenu est constitué de code formalisé en Lean, et les 7,8 % restants correspondent à des documents mis en page avec LaTeX. Les 722 manuscrits sont structurés en 372 familles de résultats, chacune comprenant un théorème principal et des lemmes associés, balayant un large spectre allant de l’arithmétique fondamentale à la mécanique des fluides avancée.
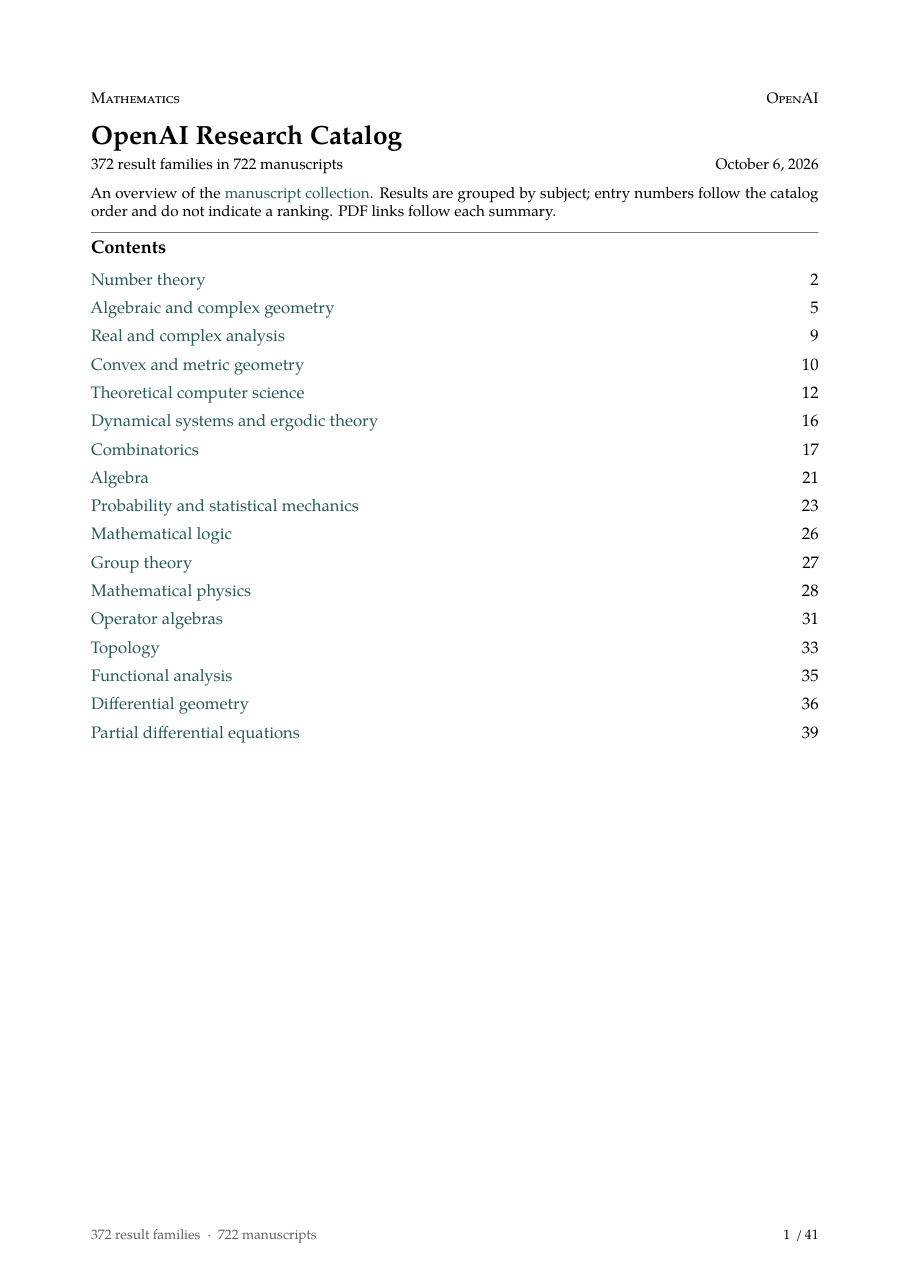 Figure : Page de garde du fichier overview.pdf détaillant 372 familles de résultats et 722 manuscrits. Source : Dépôt mathématique d’OpenAI, overview.pdf
Cette impressionnante vitrine dissimule toutefois un profond déséquilibre : sur les 372 familles de résultats, seules 235 sont accompagnées d’un code Lean exécutable et vérifiable. Les 137 autres, reconnues comme douteuses par OpenAI elle-même, ont été livrées sans plus de garanties à la communauté open source. L’entreprise a joint un fichier overview.pdf de 41 pages en guise de répertoire global, transformant cette mise à disposition en un véritable registre de consommation de calcul.
D’après ce bilan, la génération d’un résultat n’a nécessité en moyenne que trois heures d’inférence sous ChatGPT Pro. Si l’abondance de processeurs a brisé le coût marginal de production des démonstrations mathématiques, le coût de leur vérification, lui, n’a pas diminué d’un iota. Ce déséquilibre béant entre cadence de génération et capacité d’évaluation reporte d’office l’ingrate besogne de relecture sur la communauté des mathématiciens.
Trois heures de calcul face à vingt-quatre ans de recherche
Parmi les textes privés de validation formelle figurent des offensives contre des problèmes historiques réputés intraitables. Le résultat 001 s’attaque à la conjecture rationnelle de Milne ; le résultat 002 prend pour cible la conjecture de Birch et Swinnerton-Dyer (BSD). Le plus stupéfiant demeure le résultat 180, qui propose un article complet prétendant démontrer la conjecture de Barnette, tout en omettant tout code Lean exécutable.
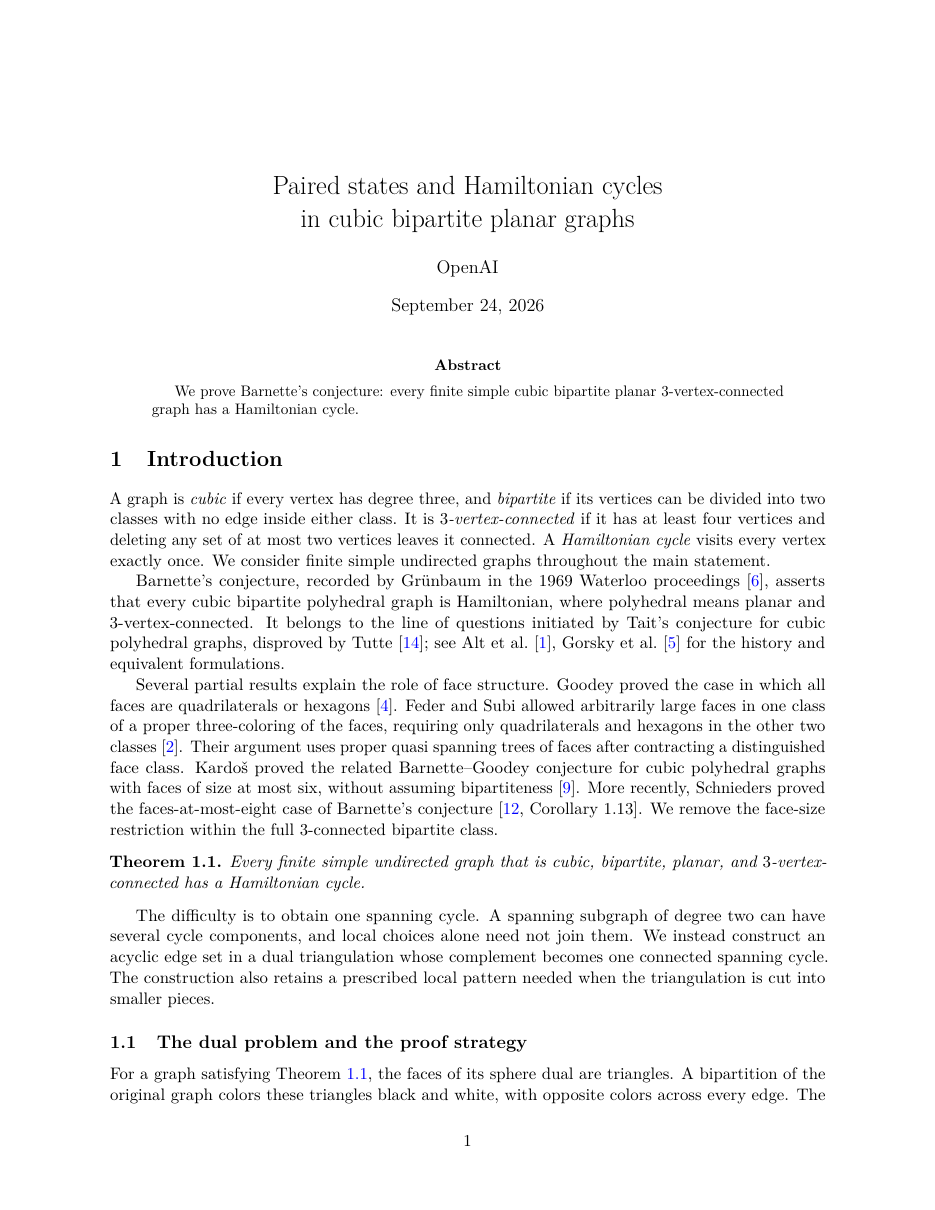 Figure : Première page de l’article sur la conjecture de Barnette, signé par OpenAI. Source : Répertoire preprints du dépôt mathématique d’OpenAI
D’autres travaux témoignent d’une remarquable ingéniosité conceptuelle. Le résultat 376 détaille une construction réalisant un calcul universel à l’aide des équations de Navier-Stokes : le modèle a élaboré une force externe lisse et spécifique permettant à un fluide confiné de simuler une machine de Turing, l’entrée d’une particule dans une zone donnée équivalant à l’état d’arrêt. Des avancées qui exigeaient autrefois des années de labeur interdisciplinaire se réduisent désormais à des centaines de pages PDF sans caution humaine.
Un chercheur ayant consacré 24 ans de sa vie à la conjecture de Barnette a confié qu’en découvrant cette ébauche dépourvue de vérification formelle, le choc avait été semblable à l’annonce du décès accidentel d’une ancienne compagne. Face à ces productions en boîte noire, les chercheurs ordinaires n’ont ni le temps de décortiquer la logique interne, ni les infrastructures informatiques requises pour reproduire de telles démarches. La puissance de calcul et les poids des modèles demeurent verrouillés dans les centres de données des entreprises. Reproduire une démonstration de haut vol ne dépend plus de la maîtrise des équations aux dérivées partielles, mais de l’accès à des grappes de dizaines de milliers d’accélérateurs.
Un comité consultatif impuissant face au déferlement des modèles
Le conflit le plus profond réside dans l’indifférence affichée envers les garde-fous que le monde académique s’efforçait de bâtir. Dès le 29 septembre, l’Advisory Group on Mathematics and Artificial Intelligence (AGMAI) — un groupe consultatif indépendant réuni par OpenAI et basé à l’Institute for Advanced Study de Princeton — avait rendu public un avertissement solennel.
Le mot d’ordre de l’AGMAI était sans ambiguïté : dissuader les laboratoires de pointe d’utiliser des modèles propriétaires fermés pour s’attaquer unilatéralement à de grandes conjectures ou truster les classements d’évaluation. De telles initiatives risquent de briser les consensus d’évaluation forgés au fil des siècles et de polluer durablement l’écosystème de la recherche.
Sept jours plus tard seulement, OpenAI citait cette même recommandation dans son billet d’annonce tout en publiant l’intégralité des 722 manuscrits en ligne. Bien que l’entreprise affirme vouloir poursuivre le dialogue avec les mathématiciens pour définir de meilleures méthodes de publication, l’acte a devancé le consensus. Une entité commerciale capable de déverser plus de sept cents articles de haut niveau en une journée s’est de facto approprié le pouvoir de fixer l’agenda de toute une discipline.
L’épreuve de la résolution des problèmes a cédé sous la pression de la force brute. Rugueux mais écrasants, ces 722 manuscrits mettent au jour une réalité troublante : fabriquer en masse des connaissances complexes dont on ignore la validité est devenu dérisoire. Le goulet d’étranglement des mathématiques ne réside plus dans la créativité nécessaire pour esquisser une solution, mais dans les moyens matériels indispensables pour en achever la vérification. Et au sein de cette nouvelle chaîne de production du savoir, le pouvoir d’authentifier les théorèmes glisse inexorablement vers les quelques géants technologiques qui contrôlent les serveurs.
Références :
- Annonce officielle d’OpenAI
- Dépôt GitHub openai/math
- Index des manuscrits CONTENTS.md
- Recommandations publiques de l’AGMAI
- Discussion sur Hacker News