C49D3608 86E70493 6A6678E1 139D26B7 819F7E90
Die obige 160-Bit-Hexadezimalzeichenkette ist der zentrale Seed-Parameter für die Kurve P-256 – eine elliptische Kurve, die Milliarden verschlüsselter Verbindungen im weltweiten Internet sichert. Am 15. Oktober 2026 wurde das von Filippo Valsorda ausgesetzte Kopfgeld in Höhe von 36.864 US-Dollar von einem Forschungsteam bei Anthropic beansprucht. Ein Rätsel, das die Kryptographie-Community ein Vierteljahrhundert lang beschäftigte, wurde von ihrem internen Forschungsmodell Claude in einer halben Stunde gelöst. Das Preisgeld wurde vollständig an die gemeinnützige Organisation ISRG (Internet Security Research Group) gespendet.
Der eigentliche Durchbruch lag im Wechsel des Hypothesenraums. Jahrzehntelang ging die Fachwelt davon aus, dass die Seeds aus dem SHA-1-Hash geheimer englischer Passphrasen stammten – eine Annahme, die Forscher über zwanzig Jahre lang in die Irre führte. Anstatt Passphrase-Wörterbücher per Brute-Force abzugleichen, untersuchte das Modell die statistischen Verhaltensmuster historischer Zufallszahlengeneratoren und lieferte mit der deterministischen Rekonstruktion von 10 Seeds über 1.600 Bit ein mathematisch unanfechtbares Ergebnis.
25 Jahre lang in die falsche Richtung gesucht
Im Jahr 2000 übernahm das NIST im Standard FIPS 186-2 eine Reihe von ECDSA-Kurven, darunter fünf Primkörperkurven von P-192 bis P-521. Jede Kurve enthielt einen hexadezimalen Seed-Wert, aus dessen Hash die Kurvenparameter deterministisch erzeugt wurden. Diese von der NSA eingereichten Seeds wurden jedoch ohne Dokumentation ihrer Herleitung veröffentlicht. Dieser Black-Box-Zustand löste in der akademischen Welt eine dauerhafte Vertrauenskrise aus.
Das hartnäckigste Gerücht verwies auf den NSA-Forscher Jerry Solinas. Man vermutete, Solinas habe humorvolle englische Phrasen gewählt und mit SHA-1 gehasht, um die Seeds zu erzeugen. Als Solinas 2023 verstarb, ging die letzte mündliche Spur verloren. Die Forschungsgemeinschaft wandte enorme Rechenkapazitäten auf, um Wortkombinationen per Brute-Force durchzuspielen und passende Hash-Präfixe zu finden – ein vergeblicher Aufwand in einer unbegründeten Sackgasse.
Der Mangel an Transparenz ließ die Spekulationen über absichtlich eingebaute Hintertüren (Backdoors) im Laufe der Jahre anschwellen. 2015 zeichneten Neal Koblitz und Alfred Menezes die Geschichte des Misstrauens akribisch nach. 2017 zeigten die Kryptographen Daniel J. Bernstein und Tanja Lange, dass der Seed-Auswahlprozess rund 70 Bit an Freiheitsgraden bot – theoretisch genug Spielraum, um gezielt schwache Kurven auszuwählen. Die Backdoor-Theorien schwächten über ein Jahrzehnt hinweg das Vertrauen der Industrie in kryptographische Standardkomponenten.
Um dem Rätsel ein Ende zu setzen, setzte der unabhängige Sicherheitsforscher Filippo Valsorda eine Community-Belohnung von 36.864 Dollar aus. Während einer Reise durch Taiwan kaufte er in einem FamilyMart-Supermarkt 20 Würfel, bedruckte sie als Fanartikel mit der Aufschrift „Geomys FIPS 140-3 Entropiequelle“ und verspottete mit einem einzigen Wurf von 6^20 (rund 51,7 Bit) physikalischer Entropie das Mysterium der Standard-Seeds. Solange der Quellcode der Generierung nicht exakt reproduziert werden konnte, blieb das Misstrauen bestehen.
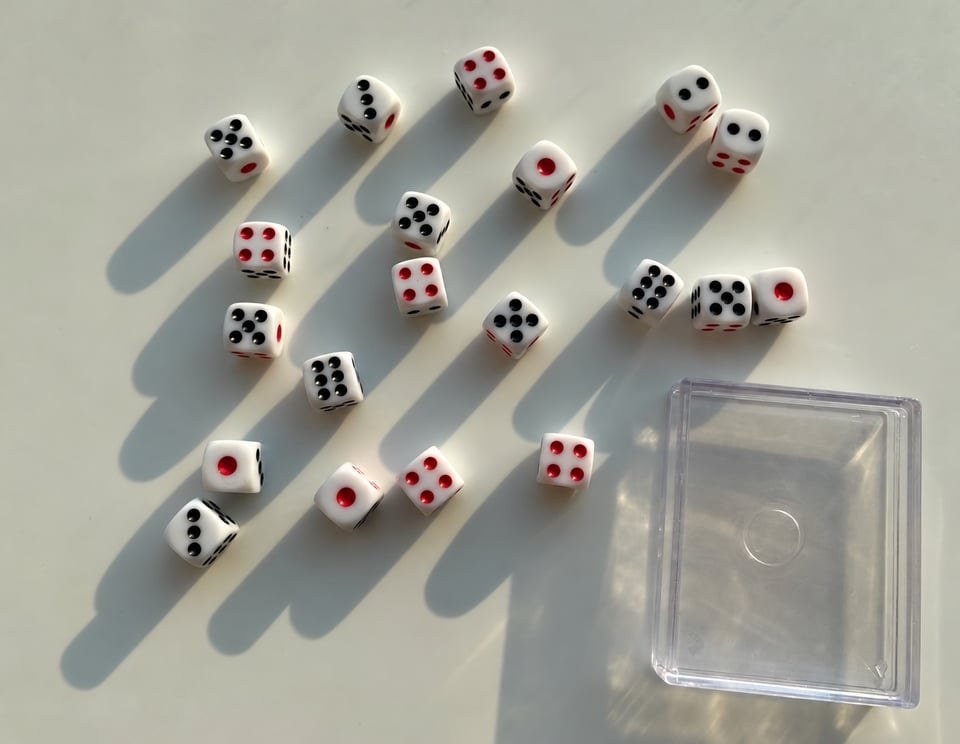 Bild: 20 Würfel aus einem taiwanesischen FamilyMart, die mit einem Wurf 6^20 (~51,7 Bit) physikalische Entropie liefern. Quelle: Filippo Valsorda
Rekonstruktion in 30 Minuten: Die Seeds stammen aus einer Systemuhr von 1997
Im Oktober 2026 legten Anthropic-Forscher dieses ungelöste Problem dem Forschungsmodell Claude vor. Der Prompt enthielt keinerlei Hinweise und forderte das Modell auf, den Ursprung der Seeds von Grund auf herzuleiten. Überraschenderweise fand das Modell die Lösung in weniger als einer halben Stunde. Der entscheidende Durchbruch gelang, weil Claude die statistischen Signaturen der Generatoralgorithmen analysierte, anstatt Hashes zu raten.
Claude schrieb ein automatisiertes Testskript, das 34 Kombinationen aus Pseudozufallszahlengeneratoren (PRNG) und Bit-Slicing-Mustern prüfte. Bei der Untersuchung des Byte-Layouts stieß das Modell auf einen auffälligen statistischen Fingerabdruck: Wurden die 10 veröffentlichten Seeds in jeweils fünf 32-Bit-Ganzzahlen zerlegt, waren bei vier Seeds sämtliche 20 höchstwertigen Bits (MSB) exakt 0. Bei einer gleichmäßigen Zufallsverteilung liegt die Wahrscheinlichkeit für ein solches Muster bei lediglich 1 zu 5.810. Diese Verzerrung konnte kein Zufall sein – sie musste aus der inneren Struktur des Generators stammen.
Dieses statistische Merkmal wies direkt auf die Funktion lrand48() hin, die in den 1990er Jahren standardmäßig in der C-Standardbibliothek von Unix enthalten war. Diese Funktion verwaltet einen internen Zustand von 48 Bit, gibt bei jedem Aufruf jedoch nur die oberen 31 Bit zurück. Da das höchste Bit des Rückgabewerts fest mit 0 aufgefüllt wird, hinterlässt es eine unverkennbare Signatur. Um den internen Zustand eines Schritts wiederherzustellen, mussten lediglich die 17 nicht offengelegten unteren Bits enumeriert werden – der Suchraum schrumpfte auf überschaubare 131.072 Möglichkeiten.
Für die Primkörper-Seeds mit komplexerer Bit-Trunkierung konstruierte das Modell ad hoc einen Löser auf Basis von Gitterbasenreduktion (Lattice Basis Reduction). Die Rekonstruktion von Zuständen abgeschnittener linearer Kongruenzgeneratoren (LCG) ist ein klassisches Gitterproblem. Das Modell wandte die Reduktion auf verschiedene Trunkierungsfenster an. Die Berechnungen ergaben, dass alle 10 Seeds exakt dem Trunkierungsmuster lrand48() >> 23 folgten. Aus jedem der rekonstruierten 48-Bit-Zustände ließen sich die vollständigen 160 Bit des jeweiligen Seeds deterministisch nachbilden.
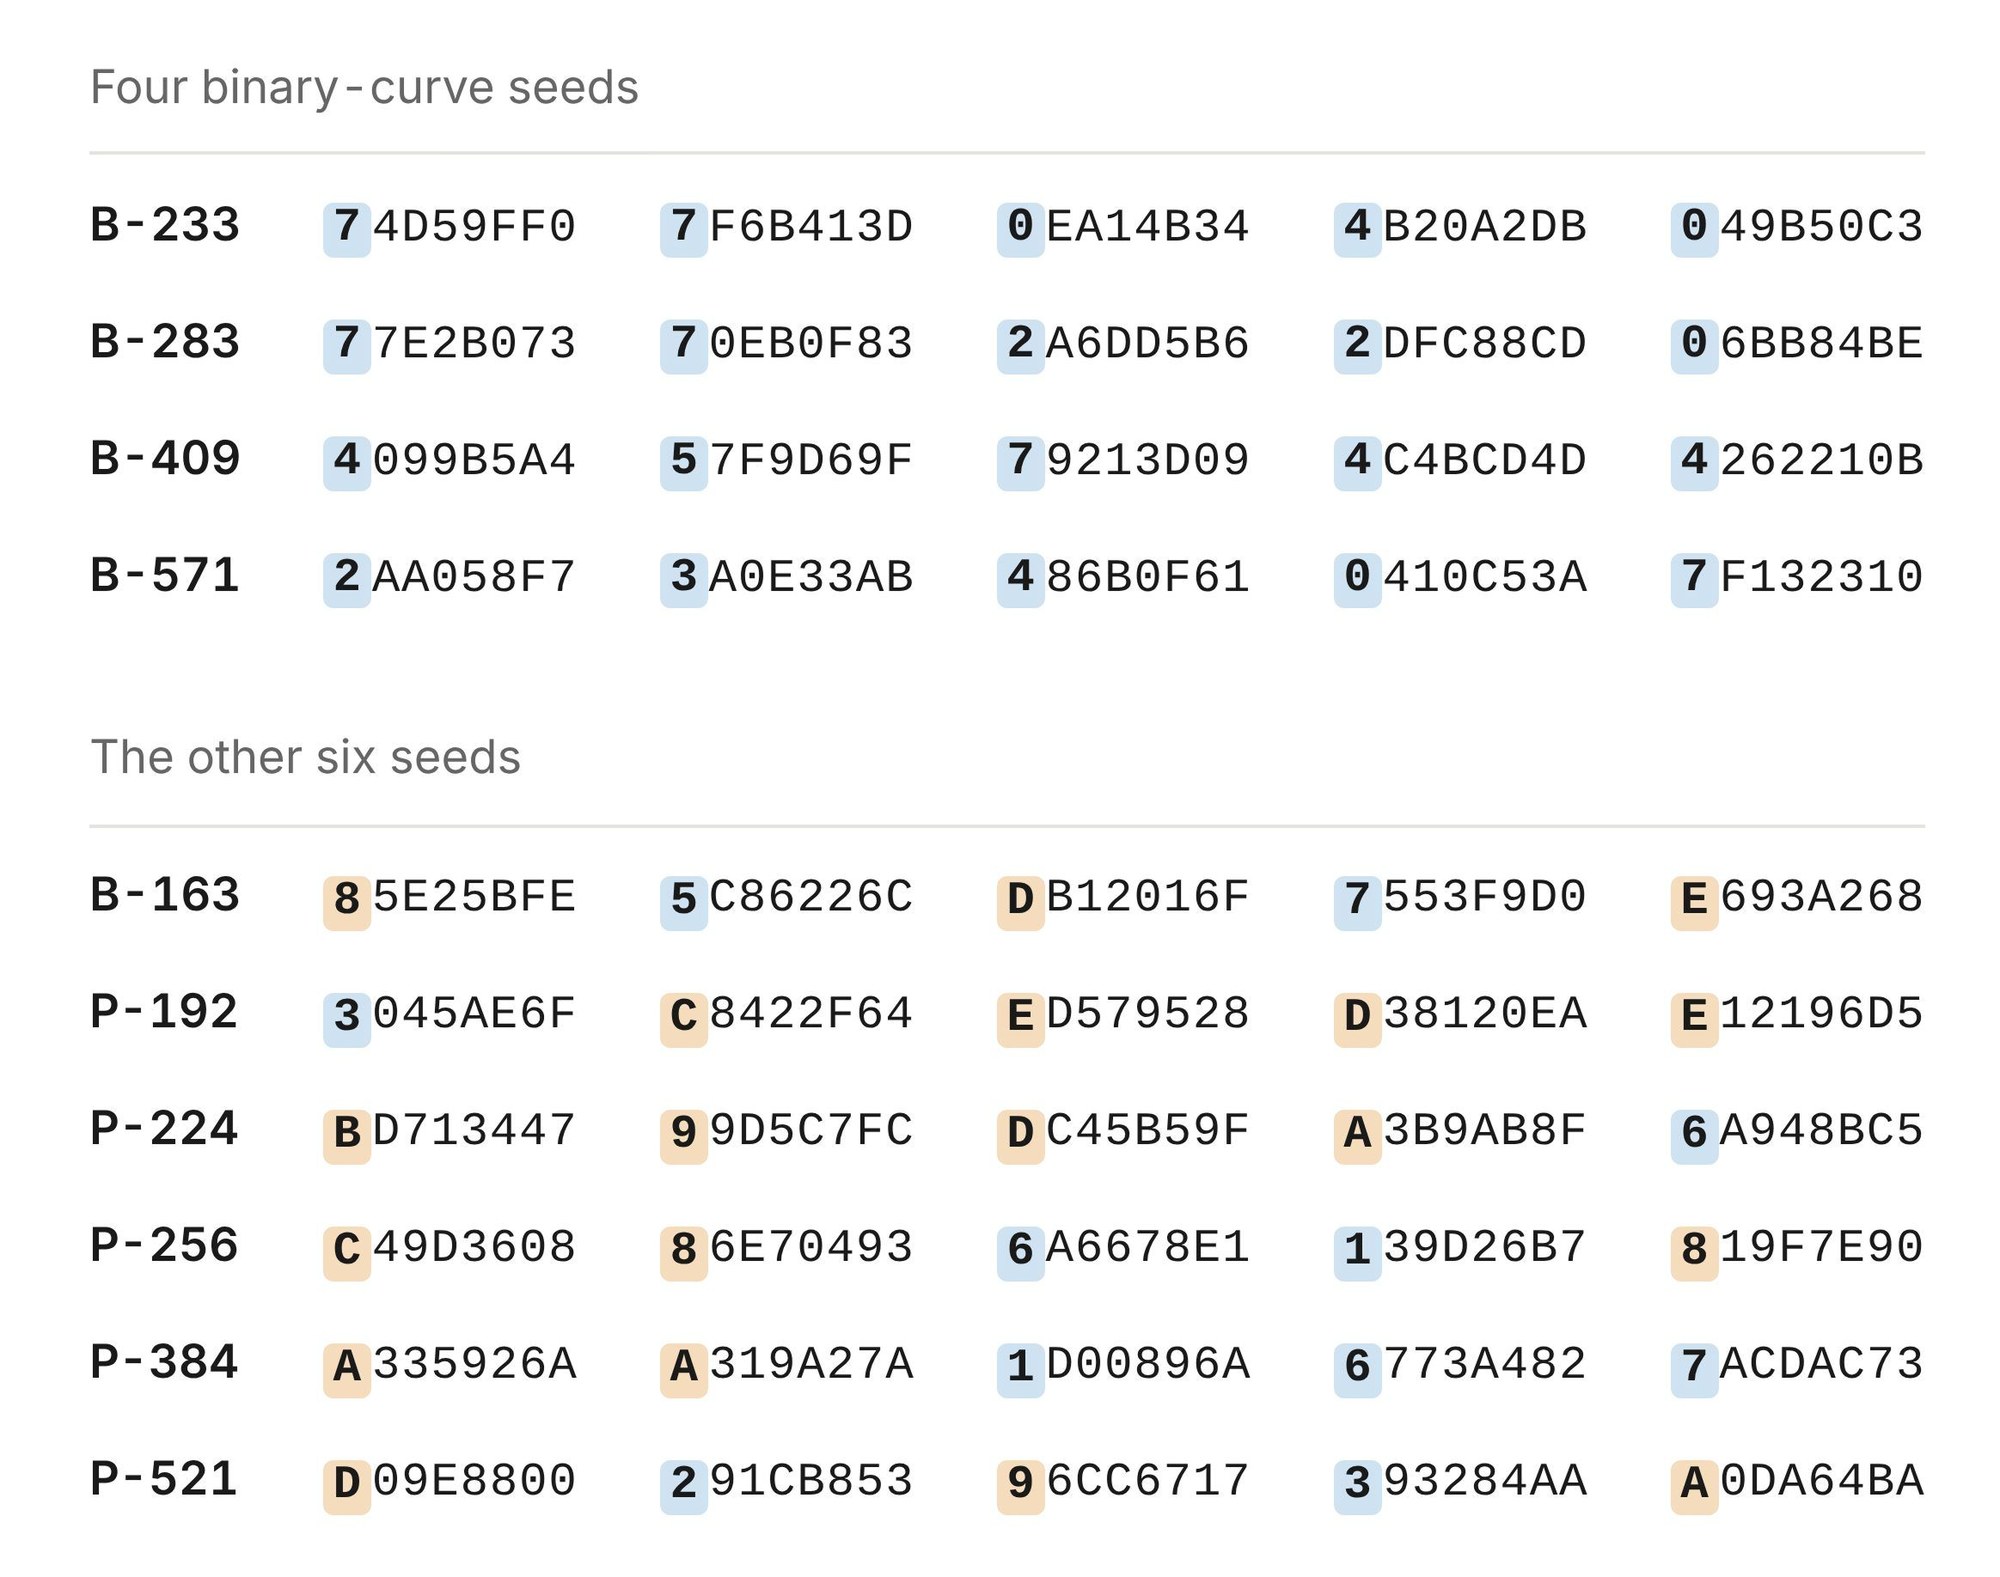 Bild: Bei bestimmten Seeds sind die höchstwertigen Bits durchgehend 0 – ein charakteristisches Muster von lrand48, das nur die oberen 31 Bit eines 48-Bit-Zustands zurückgibt (Zufallswahrscheinlichkeit: 1/5810). Quelle: Anthropic
1.600 Bit Zustandsdaten vollständig reproduziert
Die Zustandsübergänge eines linearen Kongruenzgenerators besitzen eine bidirektionale Symmetrie. Sobald der interne Zustand bekannt war, konnte das Modell entlang der Rekursionsformel rückwärts rechnen. Während dieses Rücklaufs suchte der Algorithmus nach Zuständen, die der Standard-Initialisierung über srand48(t) entsprachen, bei der die unteren 16 Bit fest auf den Hexadezimalwert 0x330E gesetzt werden. Diese Rückverfolgung verankerte den scheinbar willkürlichen Bytestrom wieder auf der realen Zeitachse.
Die Rückrechnung lieferte präzise Zeitstempel. Die Initialisierungszeitpunkte der 10 Primkörper-Seeds konzentrierten sich allesamt im Zeitraum zwischen Mai 1997 und April 1998. Der zentrale P-256-Seed entsprach exakt dem Zeitstempel 16. August 1997, 01:52:34 UTC. Das damalige Skript zog nach der Initialisierung jeweils Blöcke von 20 Bytes als Seed-Kandidaten; P-256 wurde beim 1.842. Kandidaten akzeptiert. Die deterministische Wiederholung von 1.842 Schritten schließt jeden Zufall aus.
Bei der Analyse der vier Binärkurven-Seeds stieß das Modell zunächst auf eine zeitliche Diskrepanz: Der zurückgerechnete Zeitstempel fiel in den Februar 1984. Eine Verdopplung des Werts ergab jedoch den 17. April 1998 – nur zwei Wochen vor der Erzeugung des P-224-Seeds. Der damalige Entwickler hatte beim Verfassen des Skripts die Systemzeit offenbar versehentlich durch zwei geteilt.
Die Replay-Experimente lieferten ein unanfechtbares Ergebnis: Sämtliche 1.600 Bit der 10 Test-Seeds stimmten mit den historischen Ausgaben überein. In den Argumentationsprotokollen hielt Claude sogar Momente des Zweifels fest, in denen das Modell vermutete, in einer künstlich präparierten Sandbox-Aufgabe zu arbeiten. Die globale Wahrscheinlichkeitsprüfung bestätigte den Fund: Die Seeds stammten aus einem simplen Pseudozufallszahlengenerator, der über die Systemuhr initialisiert worden war. Für eine absichtliche Manipulation gab es praktisch keinen Spielraum.
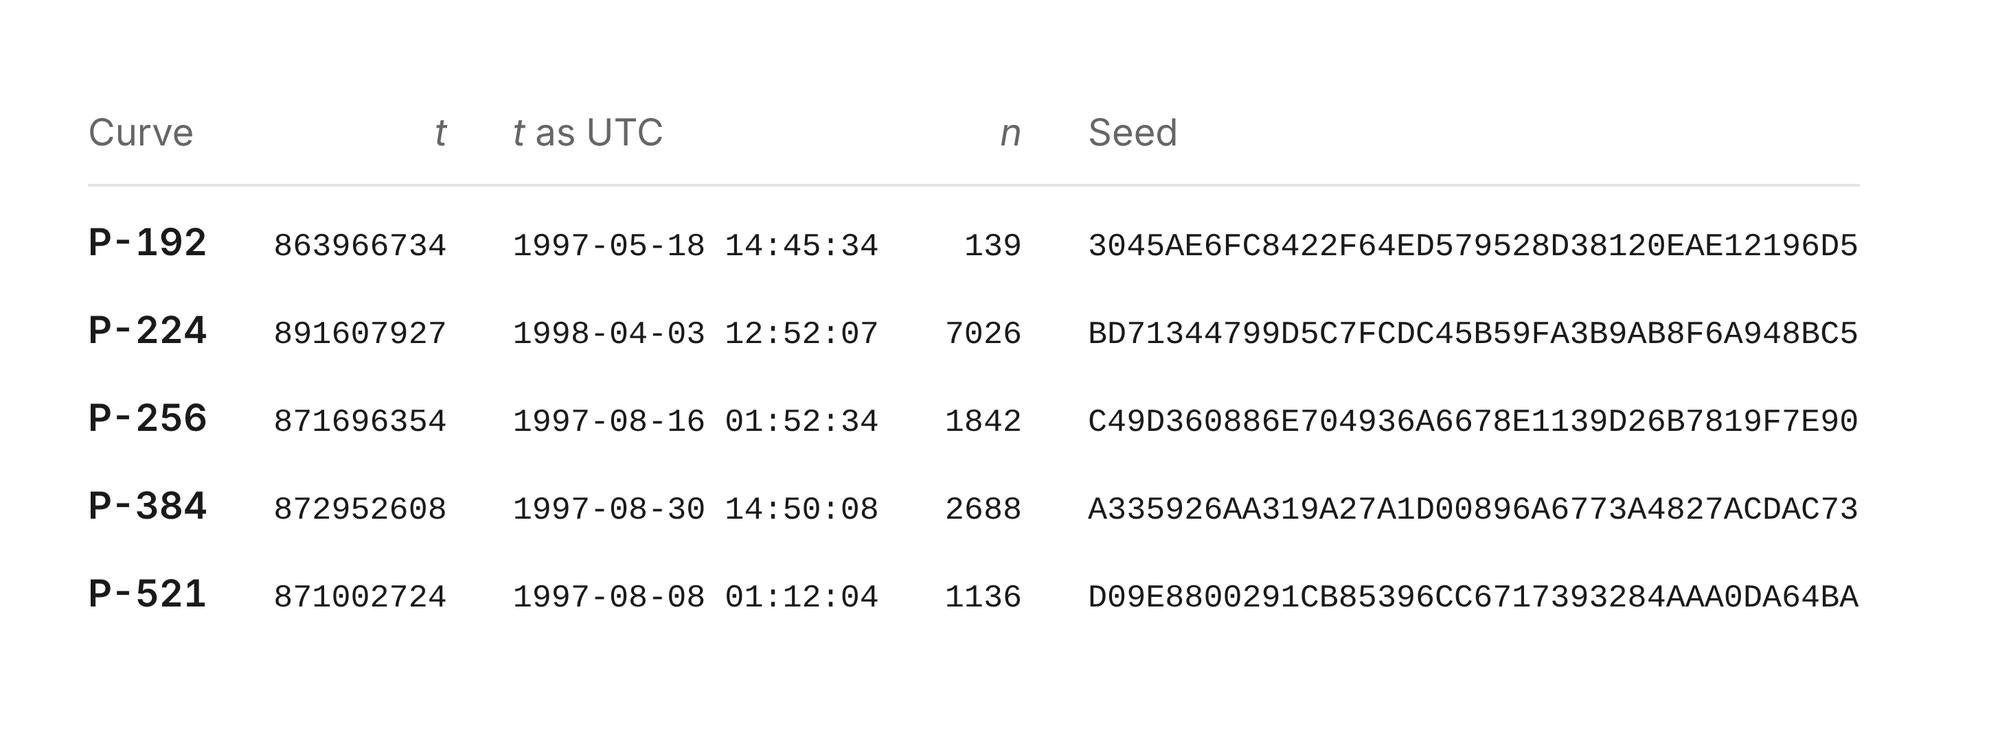 Bild: Schema des Generierungsmechanismus: Pro Iteration wurden 20 Bytes aus dem PRNG als Kandidat entnommen; P-256 erfüllte erst beim 1.842. Kandidaten die Kriterien. Quelle: Anthropic
Basispunkte teilweise entschlüsselt, Kandidaten-Sprünge bleiben offen
Neben der Entschlüsselung der Seeds erzielte die Analyse auch bei den Basispunkten der Kurven Teilerfolge. Die Untersuchung ergab, dass die Basispunkte von sechs im Mai 1997 erzeugten Kurven aus FreeLIP stammten, einem von Arjen Lenstra entwickelten Softwarepaket für Langzahlarithmetik, das damals in frühe Versionen der NTL-Bibliothek integriert war. Kurve P-192 nutzte den Basispunkt-Seed 20000, während für ANSI-Standardkurven diskrete Werte wie 20420 und 20507 verwendet wurden.
Einige historische Ingenieursdetails bleiben dennoch ungeklärt. Der Seed für die Kurve B-163 konnte bislang nicht reproduziert werden, und auch die exakten Ableitungsregeln für Basispunkte von Kernkurven wie P-224 und P-256 sind noch offen. Zudem übersprang das damalige Generierungsskript nachweislich geeignete Kurven: Bei P-256 erfüllte bereits Kandidat 876 alle geforderten Kriterien, wurde jedoch ignoriert, bis das Skript bei Kandidat 1842 anhielt.
Für dieses Überspringen gibt es in der Kryptographie zwei Lesarten. Befürworter der Backdoor-These argumentieren, das Verwerfen gültiger Kandidaten habe dazu gedient, bestimmte Parameter zu vermeiden und verdeckt schwache Kurven auszuwählen. Die pragmatische Ingenieursperspektive vermutet dagegen undokumentierte Leistungsfilter, etwa um rechenintensive Parameterstrukturen auszuschließen. In der hemdsärmeligen Softwarepraxis der späten 1990er Jahre wurden ad-hoc eingefügte Filter selten dokumentiert.
Diese verbleibenden Leerstellen ändern jedoch nichts am Kernbefund: Auch wenn die Motivation hinter der Basispunktwahl historisch interessant bleibt, schrumpft die lückenlose Übereinstimmung von 1.600 Zufallsbits mit Unix-Zeitstempeln den Raum für gezielte Hintertüren auf ein Minimum.
Das Sprachmodell als Hypothesengenerator
Rückblickend betrachtet waren die benötigten mathematischen Werkzeuge keineswegs neuartig. Gitterbasenreduktion und LCG-Zustandsinversion sind seit Jahrzehnten etablierte Lehrbuchmethoden. Dass menschliche Forscher 25 Jahre lang nicht weiterkamen, lag an einer falschen Grundannahme: Die Fachwelt hatte sich auf kryptographisch sichere Hashes versteift, sodass klassische algebraische Methoden gar nicht erst in Betracht gezogen wurden.
Die entscheidende Stärke von Large Language Models in der wissenschaftlichen Forschung liegt in ihrer Fähigkeit, den Hypothesenraum unvoreingenommen zu erweitern. Ohne menschliche emotionale Bindung an Anekdoten rund um Jerry Solinas konnte das Modell systematisch eine breite Testmatrix entwerfen. Indem es unvollkommene Systemimplementierungen der 1990er Jahre als ernsthafte Möglichkeit einstufte, verwandelte es vage Spekulationen mithilfe schneller Validierungsskripte in gesicherte Fakten.
Dies verdeutlicht die reale Rolle von Sprachmodellen in der Forschung: Sie müssen keine neuen mathematischen Sätze erfinden. Ihr Nutzen besteht darin, als Hypothesengeneratoren und automatisierte Scanner vernachlässigte Lösungspfade in kürzester Zeit zu explorieren.
Das 25 Jahre alte Geheimnis um die NIST-Ellipsenkurven ist damit gelöst. Was die Fachwelt über zwei Jahrzehnte blockierte, war eine festgefahrene Prämisse. Da die Maschine keine Scheu hatte, einfache Unix-Bibliotheken der 90er Jahre als Ursache in Betracht zu ziehen, gelang der Durchbruch – ein Gedankensprung, der wertvoller war als jeder mathematische Kunstgriff.
Weiterführende Links:
- Anthropic: Finding the origin of the NIST elliptic curves
- Filippo Valsorda: The 36 Ki$ ECDSA seed bounty (Mitteilung zur Zuerkennung und technische Details)