C49D3608 86E70493 6A6678E1 139D26B7 819F7E90
上記の160ビットの文字列は、世界中のインターネットセキュリティを支える楕円曲線「P-256」の中核となるシードパラメータである。2026年10月15日、Filippo Valsordaが提示していた36,864ドルの報奨金が、Anthropicの研究チームによって獲得された。25年間にわたり暗号学界を悩ませてきたシードの謎が、彼らの内部研究モデルClaudeによってわずか30分で解明されたのだ。賞金は全額、非営利組織ISRG(Internet Security Research Group)へ寄付された。
このブレイクスルーの本質は、前提となる「仮説空間」の転換にあった。暗号学界は長年、このシードが何らかの極秘パスフレーズのハッシュ値であると信じ込み、20年以上にわたって見当違いの探索を続けてきた。研究モデルは生成アルゴリズム特有の振る舞いとバイアスに着目し、10組のシード・計1,600ビットの完全再現によって数学的な決着をもたらした。
25年間見当違いの方向を探し続けていた
2000年、NISTはFIPS 186-2規格においてECDSA曲線を正式採用した。この規格にはP-192からP-521までの5本の素数体曲線が含まれており、それぞれの曲線に16進数のシード値が割り当てられていた。アルゴリズムはシード値をハッシュ化して曲線のパラメータを導出する。しかし、NSAから提出されたこれら中核シードの導出根拠や生成記録は公開されなかった。この完全なブラックボックス状態が、暗号研究者の間に根強い不信感を生むことになる。
その後、最も広く信じられていた噂は、NSAの研究者Jerry Solinasにまつわるものだった。Solinasが英語のジョークや格言を選び、そのSHA-1ハッシュをシードにしたという説である。しかし2023年にSolinasが他界したことで、この口伝の真偽を確かめる術は失われた。研究者コミュニティは大量の計算資源を費やして英単語の組み合わせを総当たりし、ハッシュプレフィックスの一致を試み続けた。根拠のない暗中模索に膨大な時間が費やされたのである。
生成プロセスの不透明さが生んだバックドア疑惑は、年を追うごとに深刻さを増していった。2015年にはNeal KoblitzとAlfred Menezesがシードをめぐる疑念の歴史を体系的に整理し、2017年には暗号学者Daniel J. BernsteinとTanja Langeが、シード選択プロセスに約70ビットの自由度が存在することを指摘した。理論上、これは特定の脆弱な曲線を意図的に選び出すのに十分な自由度だった。バックドア疑惑は10年以上にわたって燻り続け、標準暗号プリミティブに対する産業界の信頼を損ねていた。
この歴史的な疑念に決着をつけるため、独立系セキュリティ研究者のFilippo Valsordaが36,864ドルのコミュニティ懸賞金を立ち上げた。彼は台湾のファミリーマートでサイコロを20個買い集め、「Geomys FIPS 140-3 エントロピー源」と銘打ったグッズを制作。一度に振る6^20(約51.7ビット)の物理エントロピーを引き合いに出し、標準シードの神秘性を風刺した。生成コードが完全に再現されない限り、標準規格に対する不信感が払拭されることはなかった。
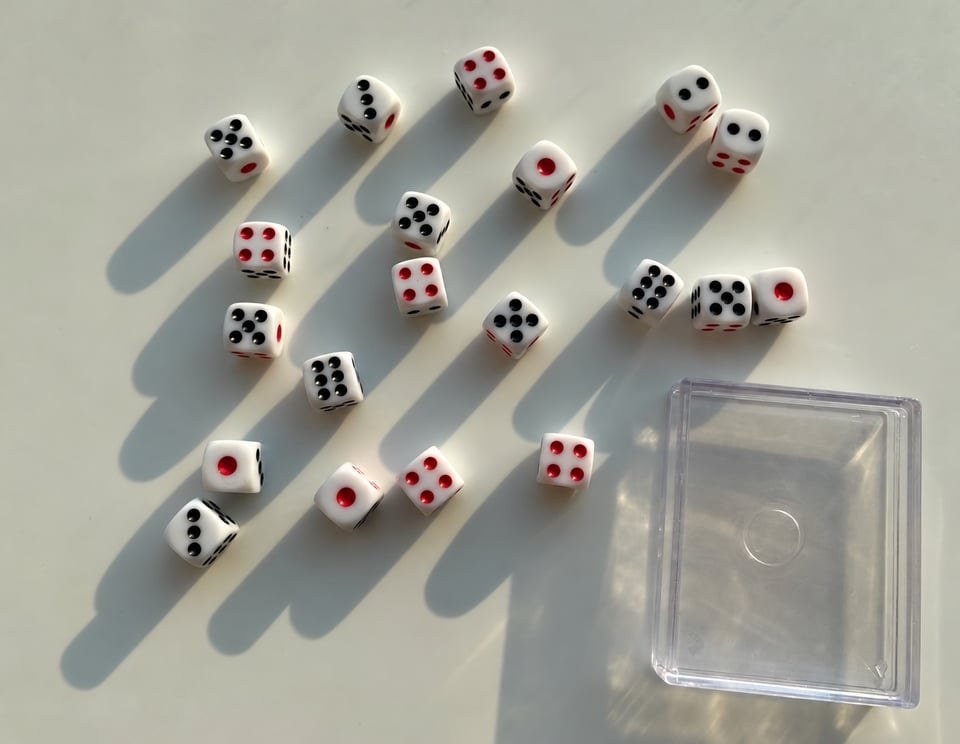 写真:台湾のファミリーマートで購入された20個のサイコロ。1回の投擲で6^20(約51.7ビット)のエントロピーを生む。提供:Filippo Valsorda
30分での逆算:シードは1997年のシステムクロックから生成されていた
2026年10月、Anthropicのエンジニアがこの未解決問題を研究モデルClaudeに提示した。プロンプトには一切のヒントを与えず、ゼロからのシード起源推論のみを求めた。驚くべきことに、モデルは30分も経たないうちに答えを導き出した。探索速度が劇的に向上した理由は、生成アルゴリズムの統計的振る舞いに着眼した点にある。
Claudeは自動スキャナを自作し、34種類の疑似乱数生成器(PRNG)と出力スライス形式の組み合わせをテストした。バイト構造を精査する過程で、モデルは異常な統計指紋を捉えた。公開されている10個のシードをそれぞれ5つの32ビット整数に分割したところ、特定の4つのシードに含まれる計20個の整数の最上位ビット(MSB)がすべて0だったのだ。一様ランダムなバイト列でこのような事象が起きる確率はわずか1/5810に過ぎない。この偏りは偶然ではなく、生成アルゴリズム固有の構造に起因する必然だった。
この統計的特徴は、1990年代のUnix C標準ライブラリに広く組み込まれていた関数 lrand48() を指し示していた。この関数は48ビットの内部状態を保持するが、1回の呼び出しでは上位31ビットのみを返す。戻り値の最上位ビットが常に0で埋められるため、出力シーケンスに明確な痕跡が残る。1ステップの内部状態を復元するには、非公開となっている下位17ビットを総当たりするだけでよく、探索空間はわずか131,072通りに絞り込まれた。
より複雑なビット切り出しが行われていた素数体曲線シードに対し、モデルはその場で格子基底簡約(Lattice Basis Reduction)ソルバーを構築した。切り捨て線形合同法(Truncated LCG)の状態復元は、古典的な格子の問題として定式化できる。異なるスライスウィンドウに対して基底簡約を実行した結果、10個すべてのシードが lrand48() >> 23 という切り捨てパターンに従っていることが判明した。復元された48ビットの各内部状態から、対応するシードの完全な160ビットが完全に再現された。
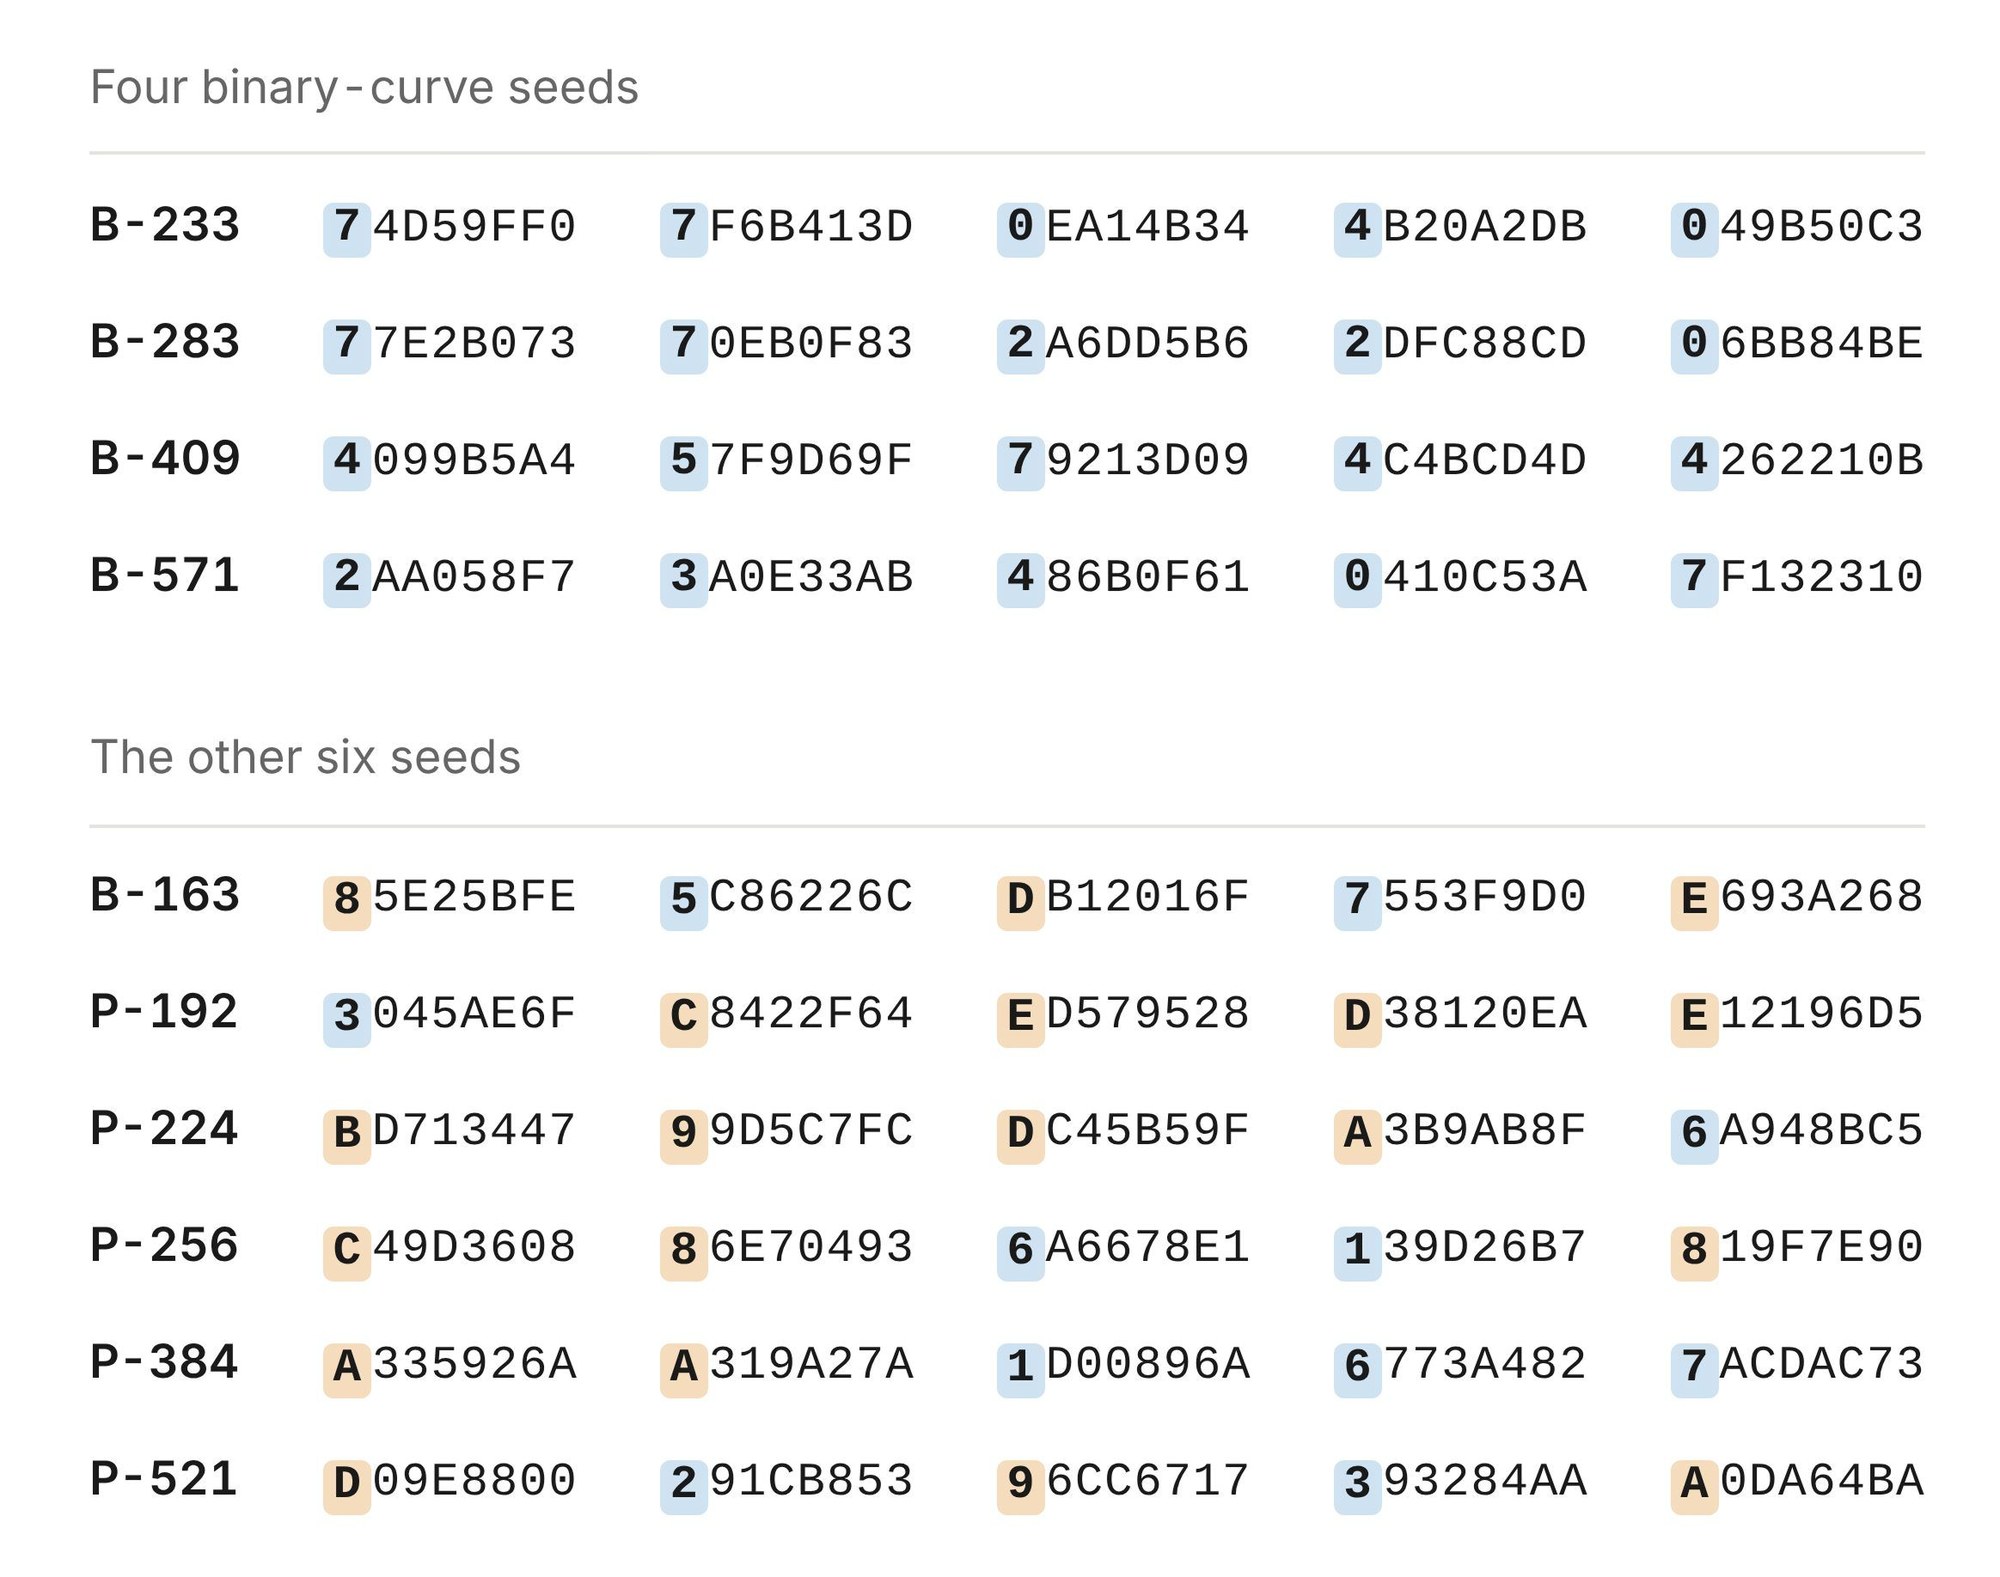 図:一部シードの最上位ビットがすべて0。これは48ビット状態の上位31ビットのみを返すlrand48特有のシグネチャであり、ランダム発生確率は1/5810。提供:Anthropic
1,600ビットの状態を完全に再現
線形合同生成器の状態遷移は双方向の対称性を持つ。内部状態が確定すれば、漸化式を逆に辿ることで過去の計算ステップを復元できる。逆算の過程において、アルゴリズムは srand48(t) による標準的な初期化条件を満たす状態点を探索した。この状態では下位16ビットが16進数で 0x330E に固定されていなければならない。この逆追跡によって、無秩序に見えたバイト列が物理世界のタイムラインへと再結合された。
逆算結果は、歴史的に極めて正確なクロック値を吐き出した。素数体曲線のシード10個の初期化タイムスタンプは、すべて1997年5月から1998年4月の間に集中していた。なかでも中核となるP-256のシードは、1997年8月16日 01:52:34 UTC に初期化されていた。生成スクリプトは初期化後、20バイトずつ候補シードを取り出しており、P-256はちょうど1,842番目の候補に合致した。1,842回に及ぶ反復を決定論的に完全再現できたことで、偶然の一致という可能性は完全に排除された。
一方、4つのバイナリ曲線シードを解析する際、モデルはタイムスタンプの年代のずれに遭遇した。逆算された初期タイムスタンプが1984年2月を示していたのだ。モデルがさらに分析を進めたところ、この数値を単純に2倍すると1998年4月17日となり、P-224シードの生成日とわずか2週間しか離れていないことが判明した。当時のエンジニアが生成スクリプトを書く際、システム時刻を誤って2で除算した可能性が極めて高い。
再現検証は完璧な一致を示した。10組のシードに対応する計1,600ビットのテストデータは、当時の標準出力と1ビットの狂いもなく合致した。推論ログの中で、Claudeは「あらかじめ仕組まれたサンドボックスのパズルを解かされているのではないか」と自問自答する場面すら記録していた。最終的に10組の状態の大域的な一致確率から結論が下された。シードはシステム時刻で初期化された脆弱な乱数生成器から作られており、意図的なバックドアを仕込む余地は実質的に存在しなかった。
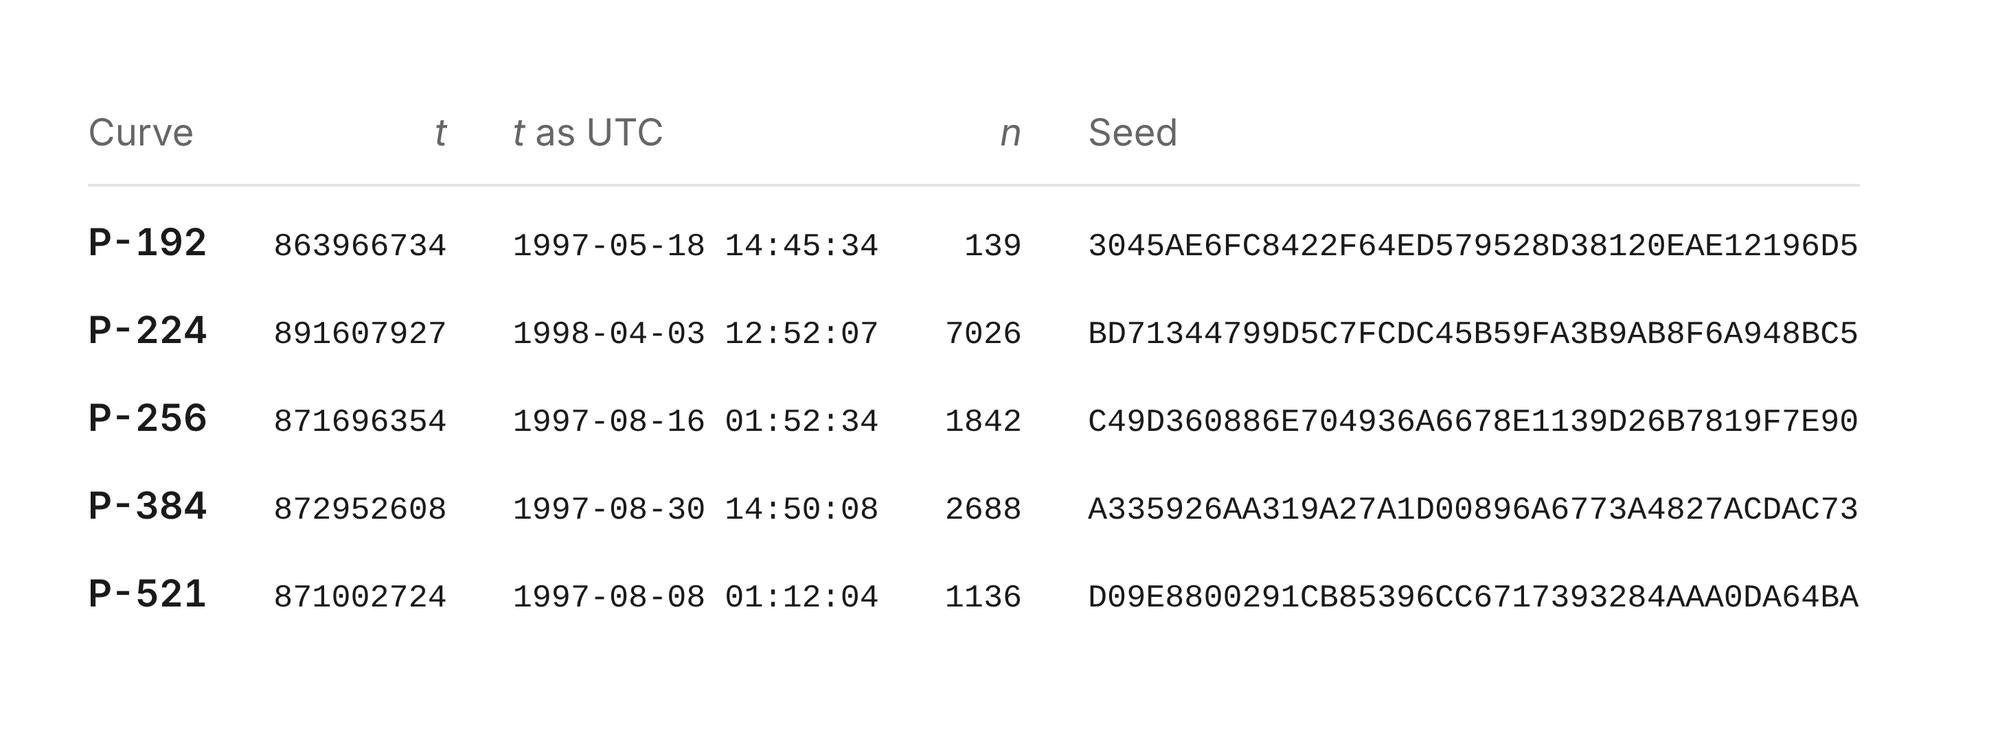 図:シード生成メカニズムの概要:反復ごとに乱数生成器から20バイトを取り出してシード候補とし、P-256は1,842番目の候補で条件を満たした。提供:Anthropic
ベースポイントの起源も一部判明、候補スキップの基準は依然未解明
シードの解明と並行して、曲線のベースポイント(基点)の導出メカニズムも部分的に明らかになった。分析によれば、1997年5月に生成された6本の楕円曲線の基点は、暗号学者Arjen Lenstraが開発した多倍長整数演算ライブラリ「FreeLIP」から取得されていた。FreeLIPは当時、初期のNTLライブラリなどに広く組み込まれていた。P-192曲線で使用された基点生成シードは「20000」であり、ANSI規格の各曲線でも「20420」や「20507」といった固定値が使われていた。
当時のエンジニアリングの細部には、今なお解明されていない断絶が残されている。曲線B-163のシード生成手順は依然として再現できておらず、P-224やP-256など中核曲線の基点生成ルールも未解明のままだ。さらに、生成スクリプトが適格な曲線をスキップしていた痕跡も見つかっている。P-256では876番目の候補がすでに要件を満たしていたにもかかわらず、スクリプトはそれを通過させ、1,842番目の候補まで探索を続けていた。
この候補スキップの挙動をめぐっては、暗号学界で解釈が分かれている。バックドア支持派は、候補を意図的に破棄することで特定のパラメータを回避し、弱点を埋め込んだ曲線を裏で選別していたのではないかと疑う。一方、エンジニアリング側の見解では、計算負荷が高いパラメータを排除するなど、ドキュメント化されていない初期の性能最適化フィルタによるスキップである可能性が高いとみられている。当時の開発環境では、臨時のスクリーニング条件が仕様書に残されないことは珍しくなかった。
しかし、これらの未解明部分が本質的な結論を揺るがすことはない。基点選定の動機に歴史的検証の余地があるとしても、1,600ビットの乱数列が当時のUnixタイムスタンプと完全に一致したという事実は、人為的なバックドアの介在余地を極限まで狭めている。
「仮説生成器」としてのAIモデル
この解明プロセスを振り返ると、必要とされた数学的手法そのものは決して目新しいものではなかった。格子の基底簡約やLCGの状態逆算は、すでに教科書に載っている確立された技法である。人間の研究者が25年間突破できなかった最大のボトルネックは、初期の仮説が事実から乖離していたことにあった。学界全体が「秘密のパスフレーズの強力なハッシュ」という前提に囚われていたため、既存の数学ツールを適用する糸口を見失っていたのである。
大規模言語モデルの真価は、未知の難問に挑む際に「仮説空間を大胆に広げられる能力」にある。人間のようにJerry Solinasの逸話に感情的な執着を持たないAIは、自由な発想でテストマトリクスを設計できた。1990年代の粗削りなシステム実装という地味な可能性を対等な候補として扱い、スクリプトによる高速な自動検証を重ねることで、漠然とした推測を高精度の結論へと収束させた。
この成果は、科学研究におけるLLMの現実的な役割を示している。モデルはまったく新しい数学定理をゼロから創り出す必要はない。仮説の生成器、そして自動化された探索器としての役割を担い、見落とされてきた枝葉を短時間で網羅することに最大の価値がある。
NIST楕円曲線のシードをめぐる四半世紀の謎は、ここに幕を閉じた。暗号の専門家たちを20年以上足止めしていたのは、最初に固定されてしまった固定観念だった。古びたC言語ライブラリの実装を正当な仮説として検討し直す——その柔軟な一歩こそが、いかなる高度な数学的テクニックよりも価値あるブレイクスルーを生み出したのである。
参考リンク:
- Anthropic: Finding the origin of the NIST elliptic curves
- Filippo Valsorda: The 36 Ki$ ECDSA seed bounty(懸賞金の受領報告と技術詳細)