C49D3608 86E70493 6A6678E1 139D26B7 819F7E90
Cette séquence hexadécimale de 160 bits constitue le paramètre graine (seed) fondamental de la courbe P-256, une courbe elliptique qui sécurise des milliards d’échanges à travers Internet. Le 15 octobre 2026, la prime de 36 864 dollars proposée par Filippo Valsorda a été remportée par une équipe de chercheurs d’Anthropic. L’énigme qui laissait les cryptographes perplexes depuis un quart de siècle a été résolue en une demi-heure par leur modèle de recherche interne, Claude. L’intégralité de la récompense a été reversée à l’organisation à but non lucratif ISRG (Internet Security Research Group).
La portée de cette percée réside avant tout dans un changement d’espace d’hypothèses. Pendant des décennies, la communauté académique est restée persuadée que les graines découlaient du hachage SHA-1 d’une phrase secrète en anglais, une fausse piste explorée en vain durant plus de vingt ans. En observant les signatures comportementales de générateurs de nombres pseudo-aléatoires historiques, le modèle a reconstitué de manière déterministe 10 séquences de graines sur 1 600 bits, apportant une conclusion mathématique indiscutable.
Vingt-cinq ans de recherches dans la mauvaise direction
En 2000, le NIST a intégré les courbes ECDSA dans la norme FIPS 186-2, comprenant cinq courbes sur corps premiers allant de P-192 à P-521. Chaque courbe était associée à une valeur de graine hexadécimale, à partir de laquelle l’algorithme calculait une empreinte pour dériver les paramètres. Toutefois, ces graines essentielles soumises par la NSA furent publiées sans aucune documentation expliquant leur construction. Ce statut de boîte noire opaque engendra immédiatement une crise de confiance durable au sein de la communauté scientifique.
La rumeur la plus persistante désignait Jerry Solinas, chercheur à la NSA, supposant qu’il avait haché avec SHA-1 des phrases humoristiques en anglais pour produire les graines. Avec la disparition de Solinas en 2023, la possibilité de vérifier cette tradition orale s’est évanouie. Les chercheurs ont alors consacré d’immenses ressources de calcul à essayer des combinaisons de mots par force brute pour faire correspondre des préfixes de hachage, gaspillant un temps précieux sur des conjectures sans fondement.
Le manque de transparence a progressivement alimenté les soupçons quant à l’existence d’une porte dérobée (backdoor). En 2015, Neal Koblitz et Alfred Menezes ont dressé un historique détaillé des doutes entourant ces graines. En 2017, les cryptographes Daniel J. Bernstein et Tanja Lange ont souligné que le processus de sélection des graines laissait environ 70 bits de degrés de liberté, une marge théoriquement suffisante pour sélectionner des courbes délibérément affaiblies. Ces théories ont entamé la confiance de l’industrie dans ces briques cryptographiques fondamentales pendant plus d’une décennie.
Afin de clore définitivement ce débat historique, le chercheur indépendant Filippo Valsorda a lancé une prime communautaire de 36 864 dollars. Lors d’un passage à Taïwan, il a acheté 20 dés dans une supérette FamilyMart pour créer un objet promotionnel baptisé « Source d’entropie Geomys FIPS 140-3 », tournant en dérision le mysticisme des graines officielles grâce à un simple lancer délivrant 6^20 (~51,7 bits) d’entropie physique. Tant que le code de génération ne pouvait être reproduit, la méfiance de la communauté ne pouvait s’éteindre.
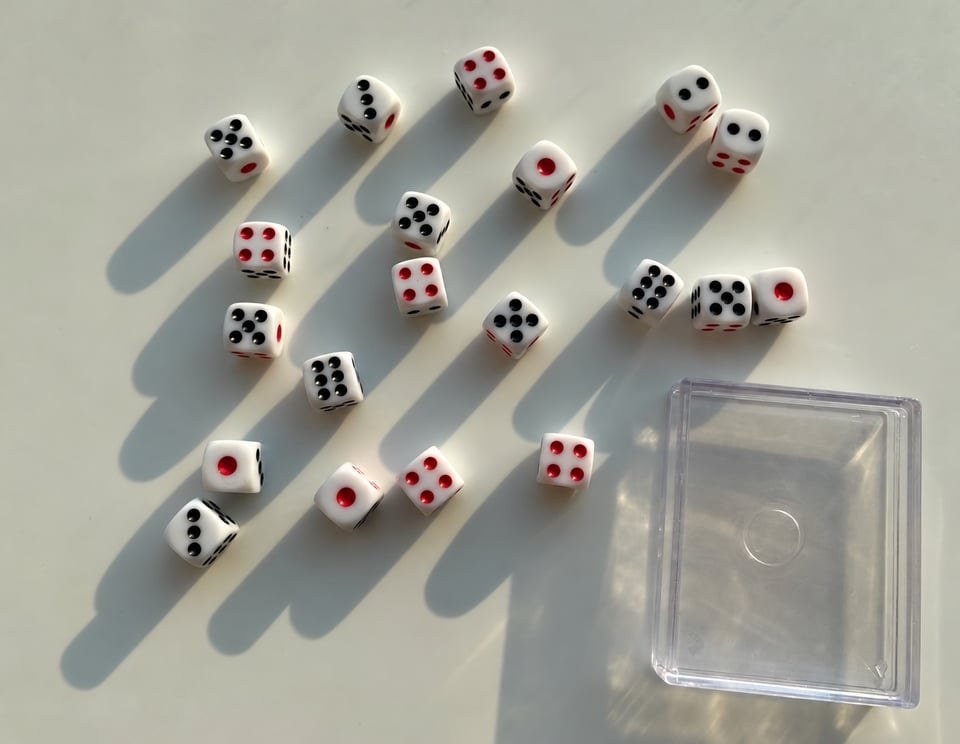 Figure : Vingt dés achetés dans un FamilyMart à Taïwan, produisant 6^20 (~51,7 bits) d’entropie physique en un seul lancer. Source : Filippo Valsorda
Rétro-ingénierie en 30 minutes : des graines issues d’une horloge système de 1997
En octobre 2026, des ingénieurs d’Anthropic ont soumis ce problème non résolu au modèle de recherche Claude. La consigne ne comportait aucun indice et demandait simplement de retrouver l’origine des graines en partant de zéro. De manière inattendue, le modèle a trouvé la solution en moins de trente minutes. L’efficacité du modèle tient au fait qu’il a orienté son analyse sur les caractéristiques comportementales et statistiques des algorithmes générateurs.
Claude a développé un programme d’analyse automatisé testant 34 combinaisons de générateurs pseudo-aléatoires (PRNG) et de découpages d’octets. En examinant la structure binaire, le modèle a identifié une anomalie statistique flagrante : en découpant les 10 graines publiques en entiers de 32 bits, les 20 entiers de quatre d’entre elles présentaient tous un bit de poids fort (MSB) égal à zéro. Dans une suite d’octets uniformément distribuée, la probabilité d’observer un tel schéma n’est que de 1 sur 5 810. Ce biais ne pouvait pas être une coïncidence ; il découlait nécessairement de la structure interne du générateur.
Cette empreinte statistique désignait directement la fonction lrand48(), un standard très répandu dans les bibliothèques C sous Unix au cours des années 1990. Cette fonction gère un état interne de 48 bits, mais ne renvoie que les 31 bits supérieurs à chaque appel. Le bit de poids fort étant systématiquement complété par un zéro, la fonction laisse une signature évidente dans les séquences produites. Reconstituer l’état interne d’une étape n’exigeait que d’énumérer les 17 bits inférieurs non divulgués, réduisant l’espace de recherche à seulement 131 072 combinaisons.
Face aux graines des courbes sur corps premiers, dont le schéma de troncature était plus complexe, le modèle a conçu un solveur basé sur la réduction de réseau (Lattice Basis Reduction). Retrouver l’état de générateurs congruentiels linéaires (LCG) tronqués est un problème classique de réseaux euclidiens. En appliquant la réduction de base à différentes fenêtres de troncature, les calculs ont établi que l’ensemble des 10 graines obéissait au motif lrand48() >> 23. Chaque état de 48 bits restauré permettait de rejouer fidèlement les 160 bits complets de la graine correspondante.
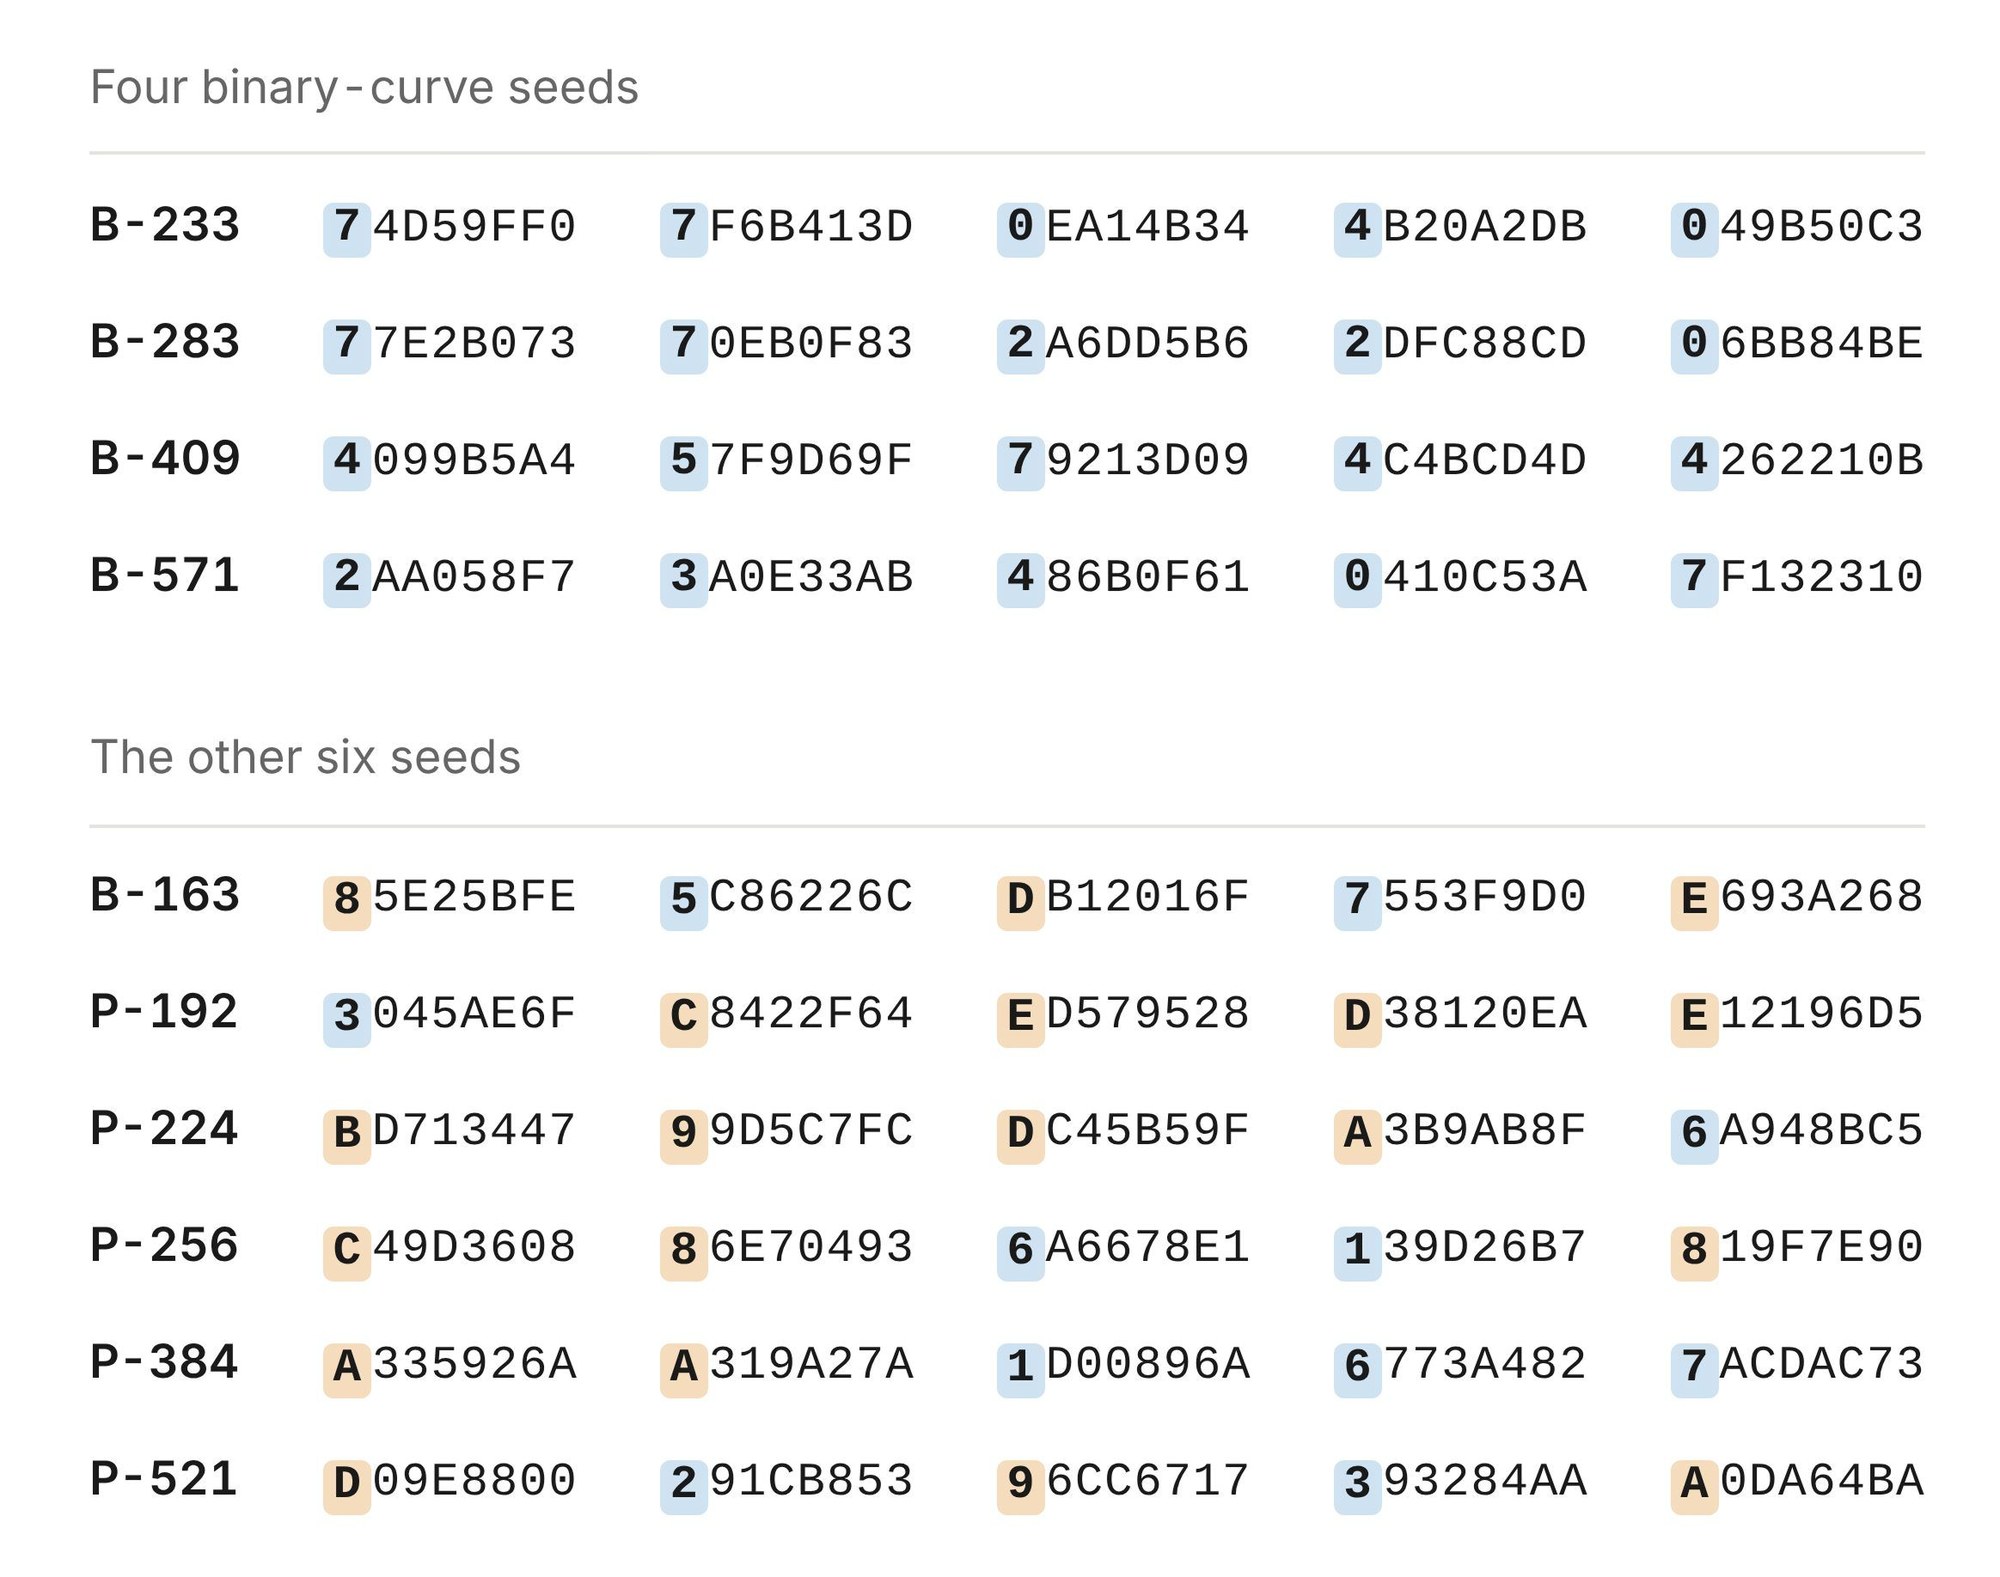 Figure : Les bits les plus significatifs de certaines graines sont tous à 0, signature caractéristique de lrand48 qui ne renvoie que les 31 bits supérieurs d’un état de 48 bits (probabilité aléatoire : 1/5810). Source : Anthropic
Reconstitution intégrale de 1 600 bits d’état
Les transitions d’état d’un générateur congruentiel linéaire bénéficient d’une symétrie bidirectionnelle. Une fois l’état interne déterminé, le modèle a pu remonter la formule de récurrence dans le temps. Dans cette marche arrière, l’algorithme a recherché les points d’état conformes à l’initialisation standard srand48(t), où les 16 bits inférieurs sont obligatoirement fixés à la valeur hexadécimale 0x330E. Cette rétro-ingénierie a permis d’ancrer une suite d’octets a priori aléatoire sur la ligne temporelle du monde physique.
Le calcul a restitué des lectures d’horloge historiques extrêmement nettes. Les horodatages d’initialisation des 10 graines des courbes sur corps premiers se concentraient tous entre mai 1997 et avril 1998. La graine essentielle de P-256 correspondait avec précision au 16 août 1997 à 01:52:34 UTC. Le programme d’époque tirait les graines candidates par blocs de 20 octets après initialisation ; la courbe P-256 a été sélectionnée au 1 842e candidat. La reproduction déterministe sur 1 842 itérations successives exclut formellement toute hypothèse de coïncidence fortuite.
En s’attaquant aux graines des quatre courbes binaires, le modèle a d’abord constaté un décalage temporel : l’horodatage initial calculé renvoyait à février 1984. En multipliant cette valeur par deux, la date correspondait soudainement au 17 avril 1998, soit deux semaines à peine avant la création de la graine P-224. L’ingénieur ayant écrit le script avait très probablement divisé par erreur l’horloge système par deux.
L’expérience a fourni une preuve indiscutable : les 1 600 bits des 10 jeux de graines correspondaient point par point aux données historiques. Dans son journal de raisonnement, Claude s’est même interrogé sur l’éventualité d’être confronté à un casse-tête conçu sur mesure dans un bac à sable. La vérification probabiliste globale a dissipé tout doute : les graines étaient issues d’un générateur de nombres aléatoires faible initialisé par l’horloge système, ne laissant pratiquement aucune place à une manipulation intentionnelle.
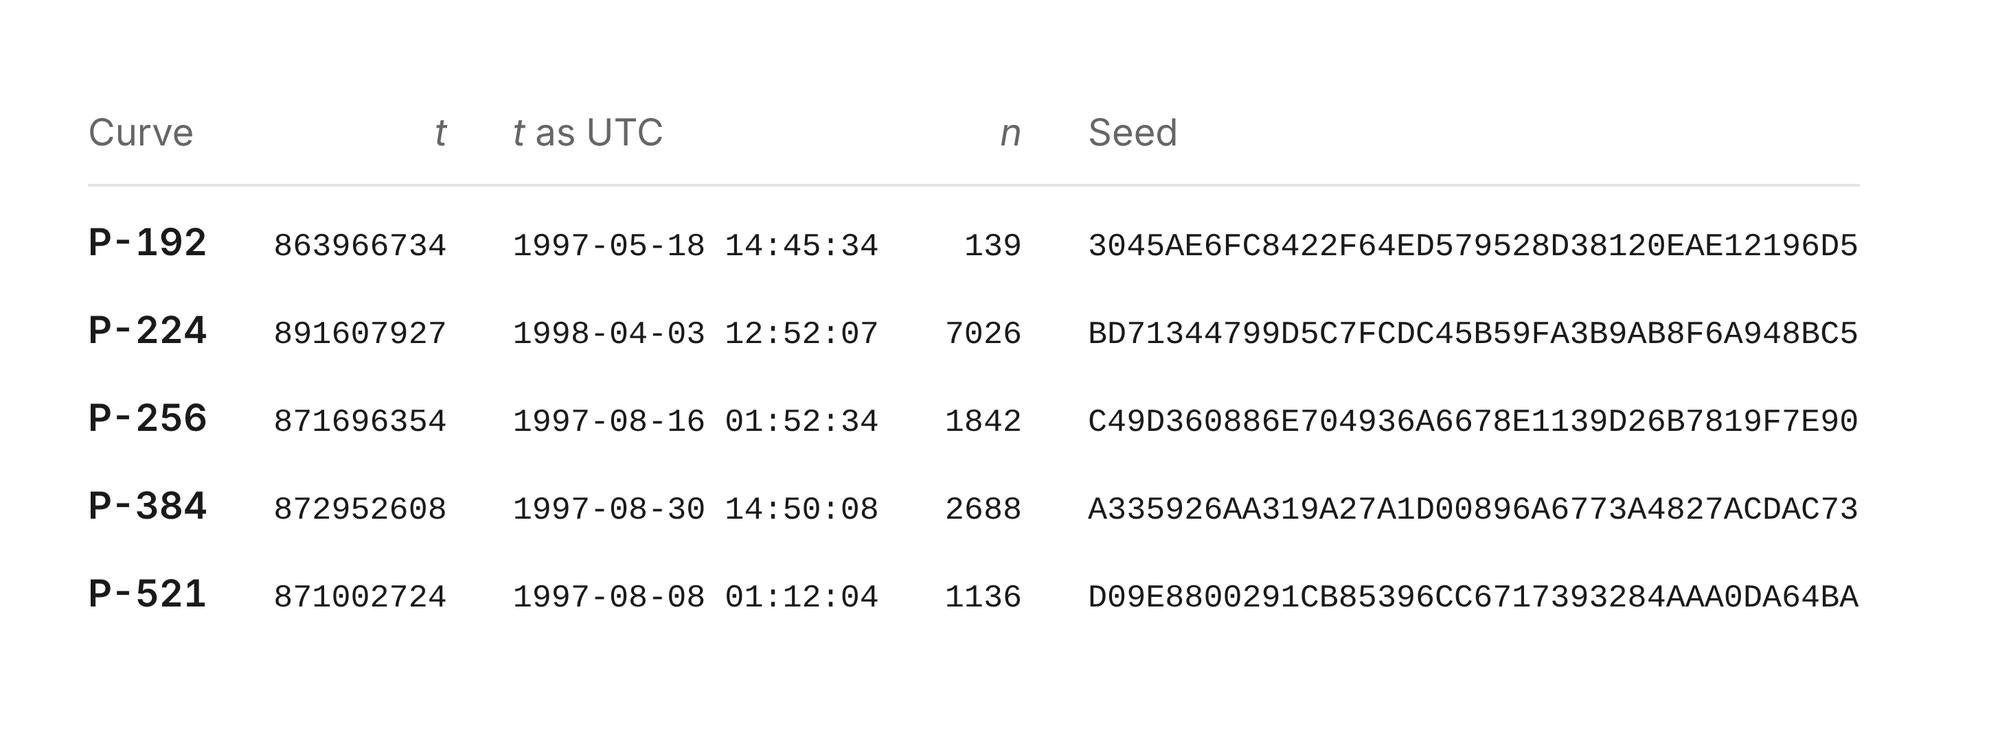 Figure : Schéma du mécanisme de génération : à chaque itération, 20 octets étaient tirés du PRNG comme graine candidate ; la courbe P-256 a été retenue à la 1 842e tentative. Source : Anthropic
Origine partielle des points de base, les candidats ignorés restent inexpliqués
Parallèlement à la découverte sur les graines, la dérivation des points de base a également connu une avancée partielle. L’analyse révèle que les points de base de six courbes elliptiques générées en mai 1997 provenaient de FreeLIP, une bibliothèque de calcul arithmétique sur grands entiers développée par Arjen Lenstra et intégrée à l’époque dans les premières versions de NTL. La courbe P-192 utilisait une graine de point de base fixée à 20000, tandis que d’autres courbes de la norme ANSI utilisaient des valeurs discrètes comme 20420 et 20507.
Certains détails techniques de l’époque restent toutefois inexpliqués. L’origine de la graine de la courbe B-163 n’a toujours pas pu être reproduite, et les règles régissant les points de base de courbes majeures telles que P-224 et P-256 demeurent inconnues. De plus, le script d’origine a ignoré des courbes parfaitement valides : pour P-256, le 876e candidat satisfaisait déjà aux critères requis, mais le script a poursuivi son exécution jusqu’au 1 842e candidat.
Cette omission de candidats valides fait l’objet de deux interprétations au sein de la communauté. Les tenants de la thèse de la porte dérobée affirment qu’abandonner des candidats permettait d’éviter certains paramètres pour dissimuler des courbes faibles. À l’inverse, l’approche pragmatique des ingénieurs privilégie l’hypothèse de filtres d’optimisation non documentés, destinés à écarter des configurations trop lourdes en calcul. Dans le cadre informel des développements de la fin des années 1990, les critères de tri temporaires n’étaient que rarement consignés par écrit.
Ces zones d’ombre n’altèrent en rien la conclusion principale : même si le choix des points de base mérite d’autres recherches historiques, la coïncidence absolue de 1 600 bits pseudo-aléatoires avec des horodatages Unix réduit à néant l’hypothèse d’une porte dérobée délibérée.
L’IA comme générateur d’hypothèses
Avec le recul, les outils mathématiques nécessaires n’avaient rien d’ésotérique : la réduction de base de réseaux et l’inversion d’état de générateurs congruentiels sont des méthodes classiques documentées dans les manuels. Si les chercheurs humains ont piétiné pendant un quart de siècle, c’est parce que leur hypothèse de départ était erronée : persuadés que ces graines résultaient d’un hachage cryptographique robuste, ils ne pouvaient pas mobiliser les outils algébriques appropriés.
La force majeure des grands modèles de langage dans la recherche scientifique réside dans leur capacité à élargir l’espace des hypothèses. Dépourvu d’attachement affectif aux anecdotes sur Jerry Solinas, le modèle a pu concevoir une matrice de tests sans a priori. En intégrant les implémentations rudimentaires du C des années 1990 au rang de candidates légitimes, le modèle a rapidement testé ses intuitions par le code, transformant des suppositions vagues en certitudes vérifiées.
Ce résultat illustre le rôle pragmatique que peuvent jouer les modèles de langage dans la science : ils n’ont pas besoin d’inventer de nouveaux théorèmes mathématiques. Leur apport fondamental réside dans leur fonction de générateurs d’hypothèses et d’explorateurs automatisés capables d’investiguer des voies négligées en quelques instants.
Le mystère des courbes elliptiques du NIST est désormais refermé. Ce qui a immobilisé la recherche pendant plus de vingt ans était un postulat initial érigé en certitude. En osant considérer le code Unix élémentaire des années 1990 comme une piste sérieuse, la machine a réalisé un changement de perspective bien plus décisif que n’importe quelle prouesse mathématique.
Liens de référence :
- Anthropic: Finding the origin of the NIST elliptic curves
- Filippo Valsorda: The 36 Ki$ ECDSA seed bounty (annonce de validation et détails techniques)