Une recette algorithmique intacte, le benchmark terminal bondit de 11,1 points
Le 17 octobre 2026, DeepSeek a mis à disposition les poids du snapshot V4.1-Flash-1017. Dans son rapport technique, l’équipe précise formellement qu’aucun nouvel algorithme n’a été introduit et que la recette d’optimisation est restée rigoureusement inchangée. Pourtant, sur le banc d’essai Terminal-Bench 4.0 — qui évalue les opérations concrètes en ligne de commande et terminal — le score de cette version mineure est passé de 31,2 à 42,3 points.
Un écart de 11,1 points redéfinit les positions comparatives. Au sein de la même suite d’évaluation, Claude Opus 5 conserve l’avantage sur Terminal-Bench 4.0, ProgramBench, NL2Repo et HLE ; en revanche, le snapshot 1017 prend les devants sur DeepSWE v1.1, Automation-Bench, Agents’ Last Exam et Apex Bench. Cette progression de plus de 11 points a été obtenue sans modifier la moindre ligne d’algorithme d’entraînement.
DeepSeek qualifie cette version de « Wish-Driven Coding » (programmation guidée par les intentions), tournée vers l’ingénierie logicielle de bout en bout. Les démonstrations publiées vont de la modélisation 3D de la Cité interdite à des jeux de course sur le Web, en passant par la recréation de jeux vidéo classiques sous Godot. Comparé à la mouture précédente, le modèle accomplit ses tâches plus rapidement et génère des sorties bien plus concises. L’élimination du verbiage inutile réduit de manière notable la latence cumulée au fil des interactions multi-tours.
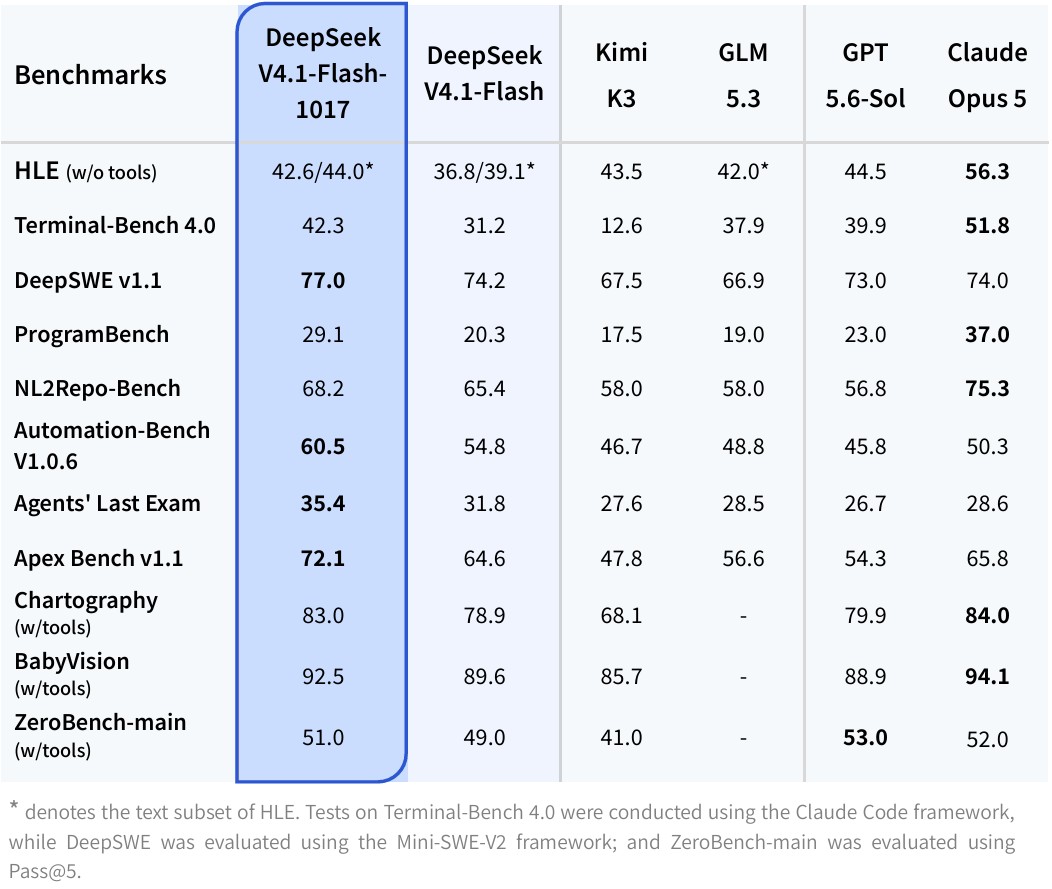 Figure : Tableau comparatif officiel des benchmarks présentant les deltas de progression du snapshot 1017 par rapport à l’itération précédente. Source : Annonce officielle de DeepSeek
D’autres indicateurs d’évaluation agentique affichent une dynamique ascendante similaire. Sous l’environnement d’évaluation Claude Code, le taux de résolution sur DeepSWE v1.1 progresse de 74,2 % à 77,0 %. ProgramBench passe de 20,3 à 29,1 points, tandis qu’Apex Bench v1.1 grimpe de 64,6 à 72,1 points. Le plafond des benchmarks de codage automatisé continue d’être repoussé.
Le rendement marginal bascule vers les environnements : des tâches synthétiques au service du raisonnement long
La section 5.1 du rapport technique détaille les priorités d’ingénierie à l’origine de cette envolée des résultats. Le post-entraînement a suivi fidèlement la séquence standard combinant réglage fin supervisé (SFT), apprentissage par renforcement (RL) et distillation sur politique (on-policy). Au lieu de retoucher les algorithmes, l’équipe a réorienté ses budgets de calcul vers la conception de tâches synthétiques et d’environnements interactifs.
Le rapport formule un constat clair : au stade actuel, le rendement marginal des pipelines de données et d’environnements surpasse nettement celui des innovations algorithmiques pures. Les jeux de données statiques étiquetés manuellement atteignent très vite un plafond lors d’interactions complexes et prolongées. Les manipulations de terminal exigent des retours en arrière d’état et une interception rigoureuse des erreurs, autant d’aptitudes qui ne peuvent être consolidées que par la synthèse programmatique.
L’équipe a conçu des pipelines automatisés capables d’engendrer de multiples espaces d’interaction rigoureusement vérifiables. Chaque tâche synthétique fait l’objet d’un dédoublonnage strict et d’un étalonnage précis de sa difficulté. La vérifiabilité déterministe des objectifs fournit au RL des signaux de récompense denses et stables, empêchant tout détournement de récompense (reward hacking) lors de l’exploration des politiques.
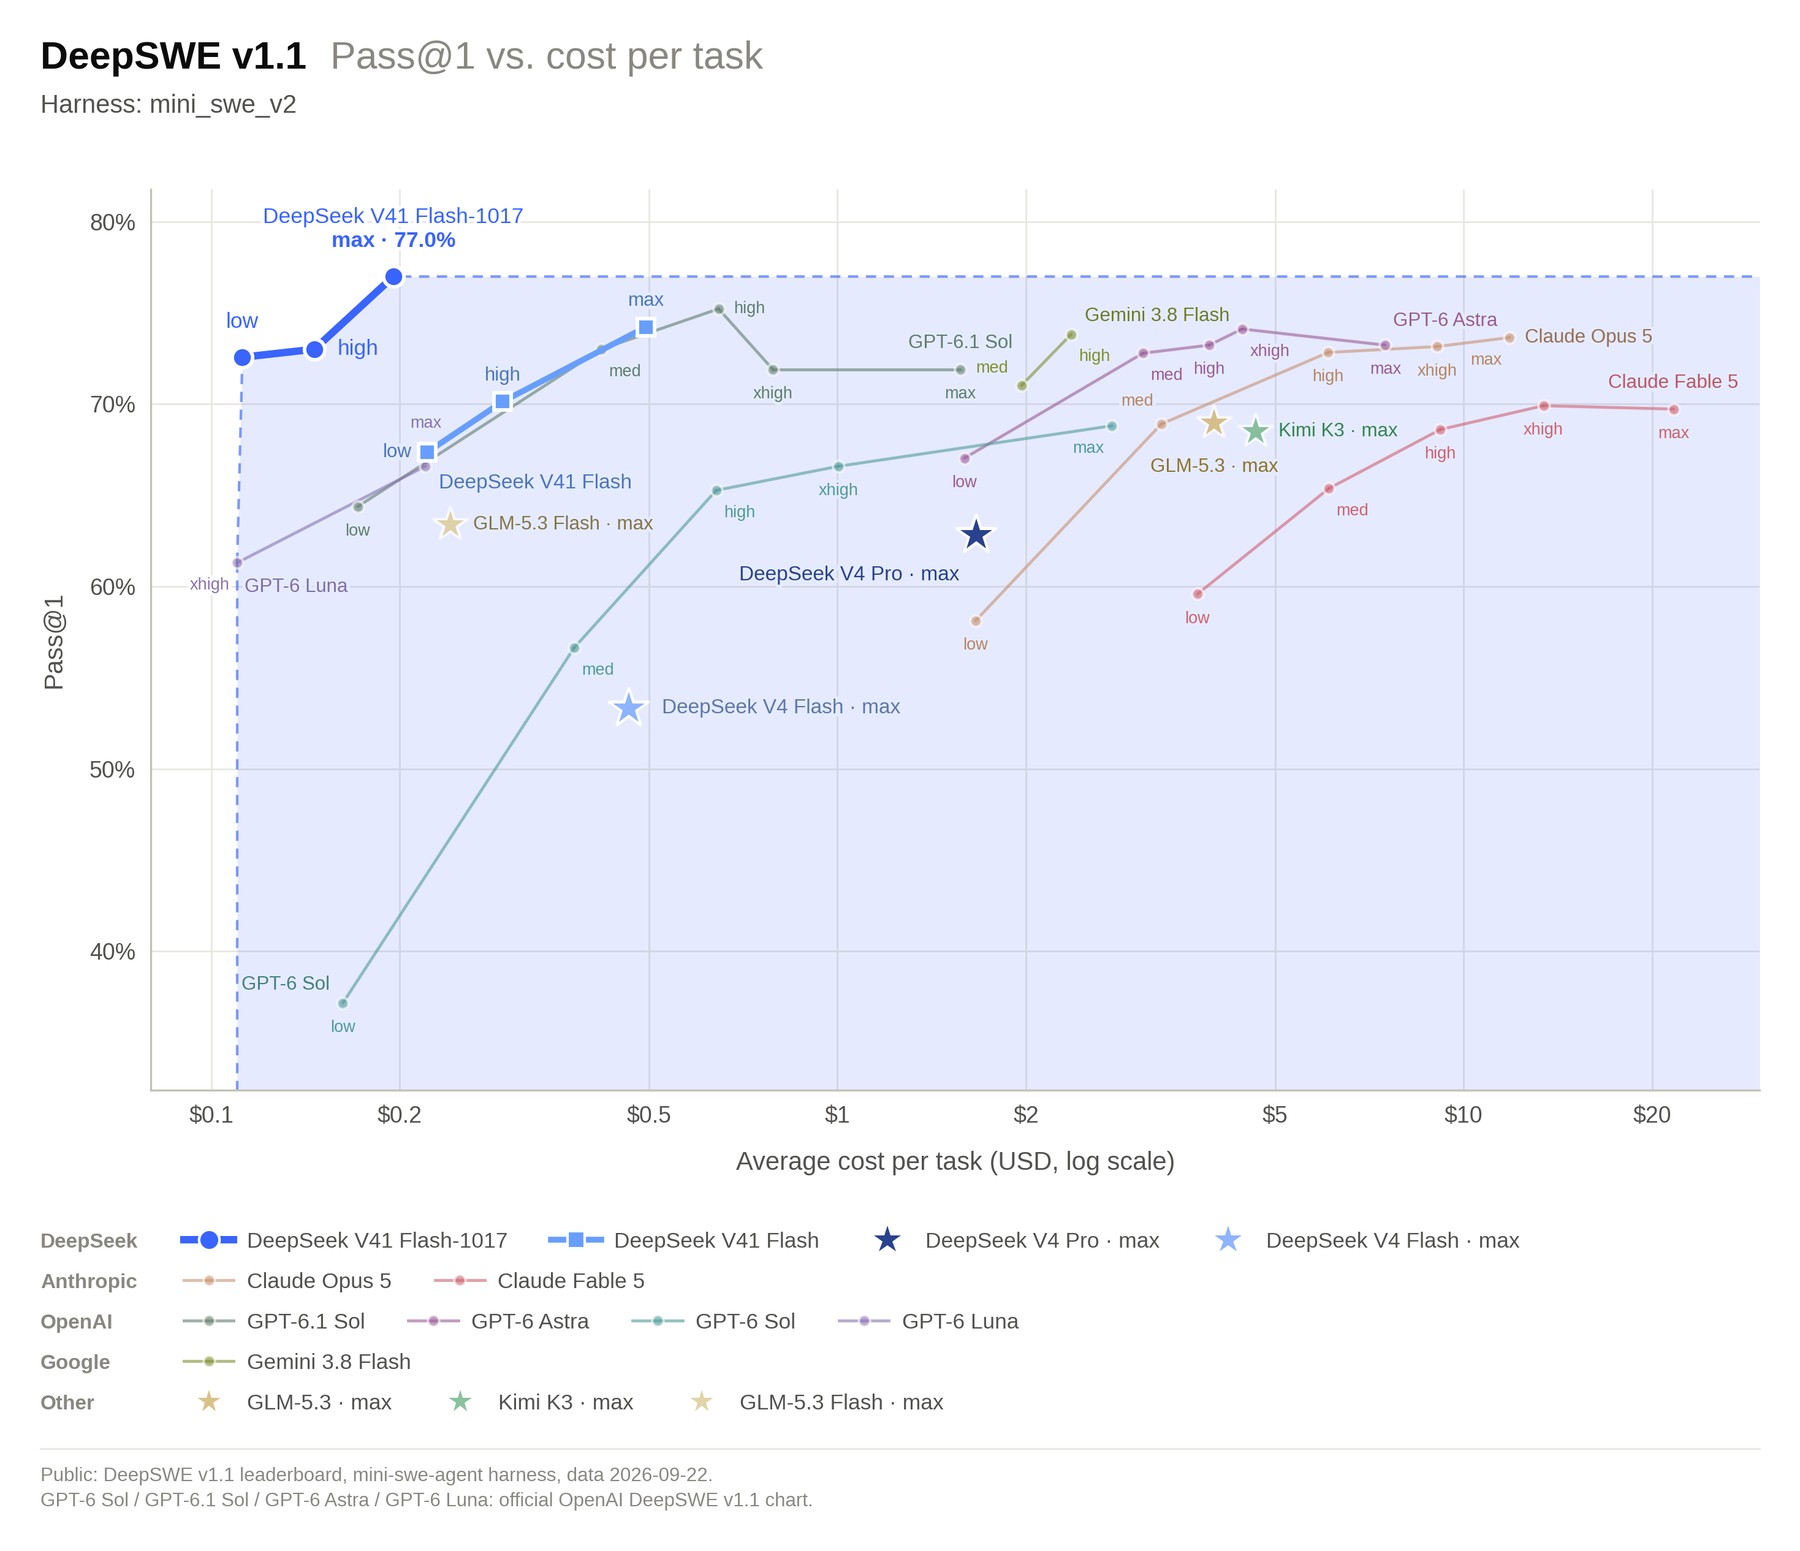 Figure : Courbe officielle de performance et de coût illustrant la dépense par tâche en regard du Pass@1 sur DeepSWE v1.1. Source : Annonce officielle de DeepSeek
Les mesures multimodales corroborent la pertinence de cette approche par l’environnement. Sur l’évaluation Chartography incluant des appels d’outils, le score s’élève de 78,9 à 83,0 points. BabyVision gagne du terrain de 89,6 à 92,5, tandis que ZeroBench-main progresse de 49,0 à 51,0 points. Les gains d’aptitude forgés au contact d’environnements interactifs concrets rejaillissent directement sur les capacités perceptives transmodales.
Compressé à 890 octets par token : le cache KV pose un plancher sur les coûts d’inférence
L’inférence pour les agents requiert l’absorption d’un contexte démesuré. Les appels d’outils répétés étirent en continu l’historique de conversation, saturant en tout premier lieu la bande passante de la mémoire vidéo (VRAM). Pour que le contexte ultra-long s’impose comme une modalité par défaut, le coût unitaire du cache doit être ramené au plancher.
L’architecture de V4.1-Flash apporte la réponse matérielle adaptée. Doté d’une structure encodeur-décodeur causale totalisant 552 milliards de paramètres, le modèle a ingéré 45 000 milliards de tokens multimodaux durant son pré-entraînement. Lors du décodage, 16 milliards de paramètres sont activés, contre seulement 8 milliards lors de la phase de pré-remplissage (prefill). Cette légèreté du prefill comprime drastiquement le délai avant l’émission du premier token (TTFT).
La rupture physique découle de la combinaison de la compression d’attention CSA2 et de la mise en cache en format FP4. Grâce à la réutilisation entre couches, l’empreinte globale du cache KV est réduite à seulement 890 octets par token. Cette consommation correspond au quart de celle de V4-Flash et à un dérisoire 1/437e de l’architecture de première génération.
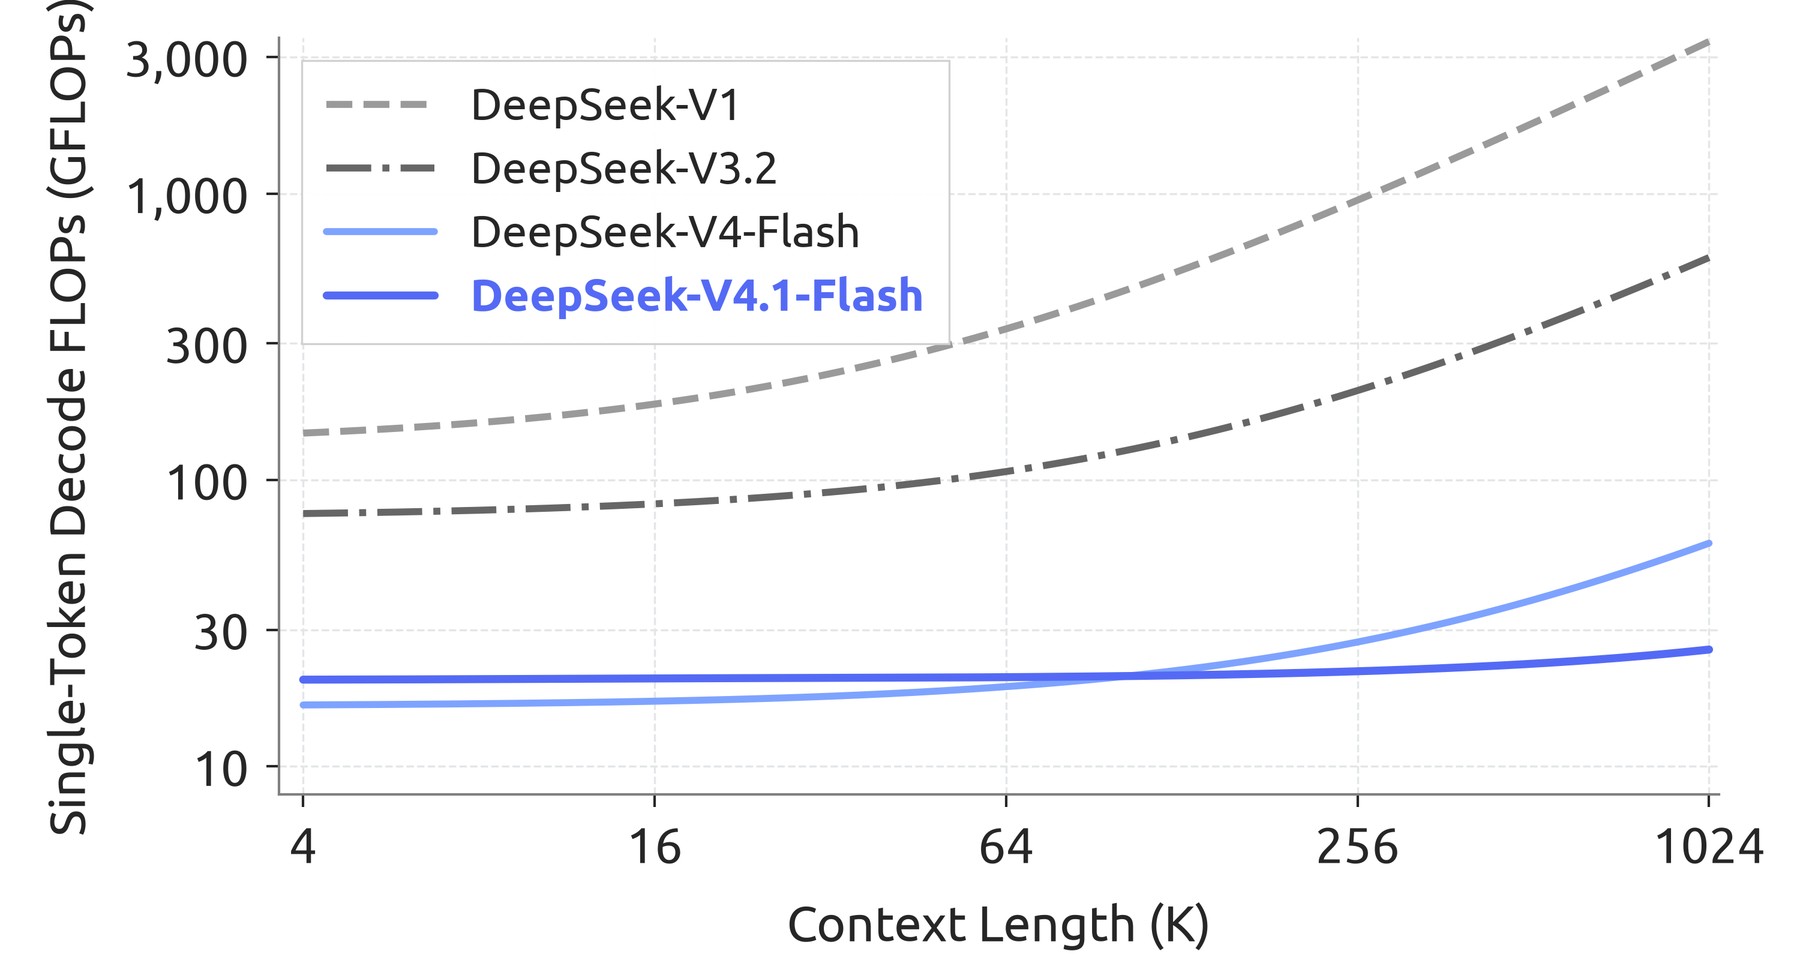 Figure : Puissance de calcul requise pour décoder un token unique à mesure que le contexte s’étend jusqu’à 1M de tokens. Source : Rapport technique DeepSeek-V4.1-Flash
Couplé à un mécanisme de rejeu des limites d’attention à fenêtre glissante, le volume de cache persistant est réduit à un huitième de la génération précédente. La courbe de calcul reste remarquablement plate : multiplier la longueur de contexte par 256 pour passer de 4K à 1M de tokens n’augmente les opérations en virgule flottante de décodage par token que de 25 %. Le contexte d’un million de tokens passe ainsi du statut de démonstrateur onéreux à celui de standard opérationnel.
Abandon des templates Jinja : l’ingénierie cède le pas aux protocoles d’exécution automatisés
La chute des coûts d’inférence entraîne une mutation rapide de la chaîne d’outils applicative. Sur la plateforme d’hébergement OpenRouter, le tarif d’entrée est fixé à 0,10 dollar par million de tokens. Le coût de sortie reste à 0,50 dollar, tandis que la lecture du cache s’effondre à un plancher de 0,002 dollar.
Dans le même temps, DeepSeek a ouvert l’accès à ses interfaces propriétaires Search et Fetch. Ce système d’interrogation en ligne, qui traite des centaines de millions de requêtes externes chaque jour, est facturé 0,75 dollar pour mille appels d’API. L’accès reste gratuit dans les outils officiels et les principaux assistants de code jusqu’au 31 octobre 2026. Cette recherche économique affranchit les agents des limites temporelles de leurs données d’entraînement.
Cette itération abandonne définitivement les fichiers traditionnels de templates Jinja. L’équipe fournit en remplacement une implémentation de référence autonome en Python, assortie d’une bibliothèque native en Rust avec liaisons Python. Cet interpréteur prend en charge nativement les dialogues multi-tours, les cheminements de pensée (CoT), l’injection de messages système à mi-parcours et le balisage mixte texte-image. La prise en charge par une bibliothèque bas niveau supprime tout risque de désalignement de format.
Les hyperparamètres d’échantillonnage recommandés traduisent une philosophie affirmée : la température et le Top-P sont tous deux fixés à 1,0, avec une longueur maximale de séquence imposée à au moins 256K tokens. Sur une fenêtre d’un million de tokens, le modèle doit maintenir un respect absolu des contraintes de longue portée. L’introduction de bibliothèques de communication structurées élimine les fragilités d’analyse syntaxique qui pénalisaient autrefois les appels d’outils gérés par templates.
Les environnements interactifs comme ligne de partage : la compétition revient au débit d’ingénierie
Le message véhiculé par le snapshot 1017 est limpide : les gains tirés de la seule optimisation algorithmique s’essoufflent, tandis que le déploiement d’environnements vérifiables à grande échelle et de pipelines de calibration robustes suffit à faire grimper les scores de deux chiffres.
Parallèlement, une empreinte de cache de 890 octets pose les fondations concrètes d’une mise en production viable. Ce n’est que lorsque les coûts de lecture et d’écriture deviennent négligeables que les agents procédant par essais et erreurs intensifs trouvent une viabilité économique. Dans l’écosystème open source, la confrontation s’est déplacée du simple réglage des poids vers les pipelines d’environnements et la cohésion système : celui qui saura fournir en continu des mondes interactifs vérifiables au coût le plus bas définira la prochaine frontière des capacités des modèles.
Liens de référence :
- Annonce officielle de DeepSeek-V4.1-Flash-1017 et poids open source du modèle
- Rapport technique DeepSeek-V4.1-Flash : Pushing the Limits of KV Cache Compression
- Spécifications techniques des benchmarks Terminal-Bench 4.0 et DeepSWE v1.1
- Enregistrement des discussions techniques sur la communauté Hacker News