La receta algorítmica intacta y Terminal-Bench sube 11,1 puntos de golpe
El 17 de octubre de 2026, DeepSeek liberó la instantánea de pesos V4.1-Flash-1017. En su informe técnico, el equipo aclaró de forma taxativa que esta versión no introduce nuevos algoritmos y que la fórmula de optimización se mantuvo exactamente igual. Sin embargo, en la evaluación Terminal-Bench 4.0 —que mide la interacción práctica con terminales y líneas de comandos— la puntuación de esta versión menor saltó de 31,2 a 42,3 puntos.
Un margen de 11,1 puntos redefine las distancias en la tabla clasificatoria. En esa misma serie de pruebas, Claude Opus 5 aún conserva el liderazgo en Terminal-Bench 4.0, ProgramBench, NL2Repo y HLE; no obstante, la versión 1017 logró superarlo en cuatro pruebas críticas: DeepSWE v1.1, Automation-Bench, Agents’ Last Exam y Apex Bench. Este incremento neto de más de 11 puntos no responde a una sola modificación en el código algorítmico.
DeepSeek denominó a esta versión “Wish-Driven Coding” (programación guiada por deseos), orientada por completo a la construcción de ingeniería de software de extremo a extremo. Los casos de demostración abarcaron desde el modelado 3D de la Ciudad Prohibida y juegos de carreras web hasta la recreación de videojuegos clásicos en Godot. En comparación con las versiones previas, el nuevo modelo completa las tareas más rápido y reduce drásticamente los tokens generados. Podar las salidas redundantes disminuye sustancialmente la latencia acumulada en diálogos de múltiples turnos.
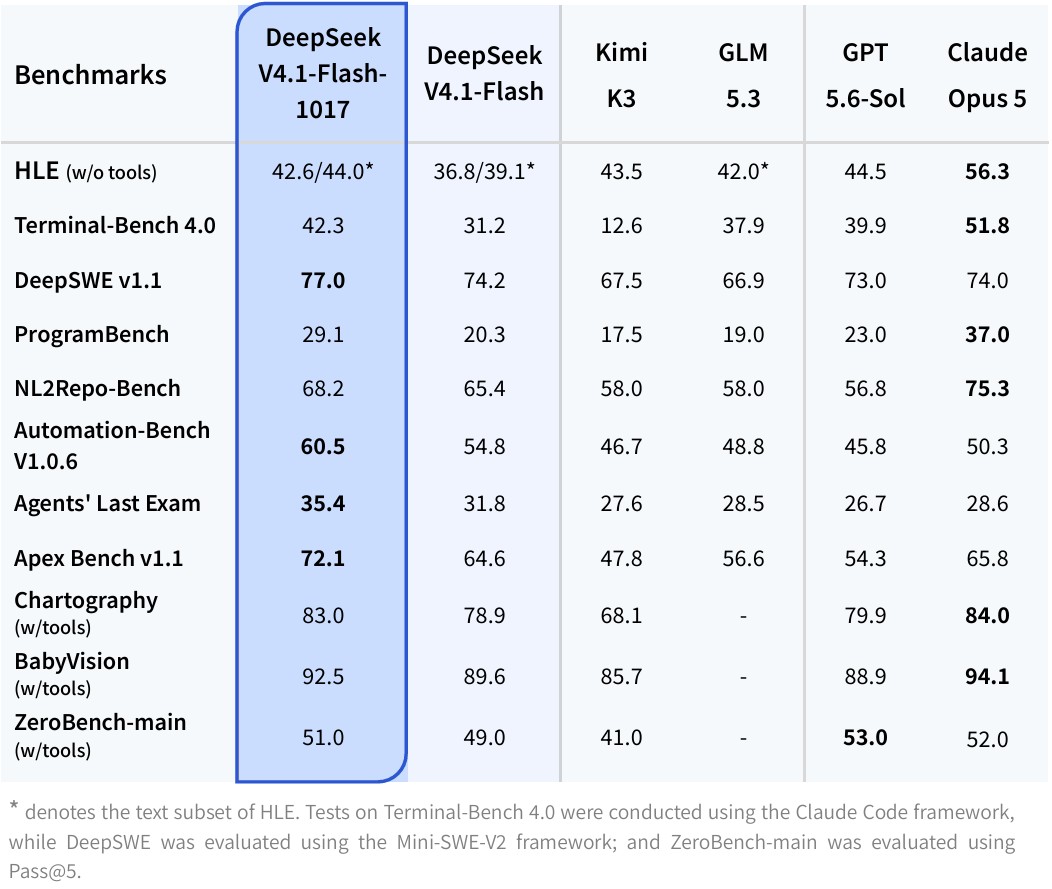 Figura: Tabla comparativa oficial de benchmarks que detalla el incremento de la versión 1017 respecto a la entrega anterior. Fuente: Anuncio oficial de lanzamiento de DeepSeek
Otras métricas orientadas a agentes reflejan una tendencia ascendente idéntica. Evaluado bajo el entorno de Claude Code, la tasa de resolución de DeepSWE v1.1 pasó del 74,2 % al 77,0 %. ProgramBench escaló de 20,3 a 29,1 puntos, y Apex Bench v1.1 avanzó de 64,6 a 72,1 puntos. El techo operativo de los benchmarks de programación automatizada continúa expandiéndose de manera sostenida.
Los retornos marginales miran al entorno: tareas sintéticas que sostienen el razonamiento prolongado
La sección 5.1 del informe técnico desvela el foco de ingeniería tras este ascenso de rendimiento. El post-entrenamiento continuó apoyándose en la ruta estándar de ajuste fino supervisado (SFT), aprendizaje por refuerzo (RL) y destilación sobre la misma política (on-policy). En lugar de alterar la formulación, el equipo destinó los recursos computacionales al diseño de tareas sintéticas y al despliegue de entornos de interacción.
El informe plantea una deducción clara: en la fase actual, el retorno marginal obtenido de las canalizaciones de datos y entornos interactivos supera con creces el de la innovación algorítmica pura. Los conjuntos de datos estáticos anotados manualmente tocan techo rápidamente frente a interacciones complejas de horizonte prolongado. Las operaciones de terminal exigen deshacer estados y capturar errores en tiempo real, dinámicas que solo pueden entrenarse a escala mediante síntesis programática.
El equipo diseñó pipelines automatizados para estructurar espacios de interacción diversos y formalmente verificables. El sistema somete las tareas sintéticas a filtros rigurosos de deduplicación y calibración de dificultad. Al contar con condiciones de finalización objetivamente comprobables, los agentes de aprendizaje por refuerzo reciben señales de recompensa consistentes, lo que previene el hackeo de recompensas (reward hacking) durante la exploración de políticas.
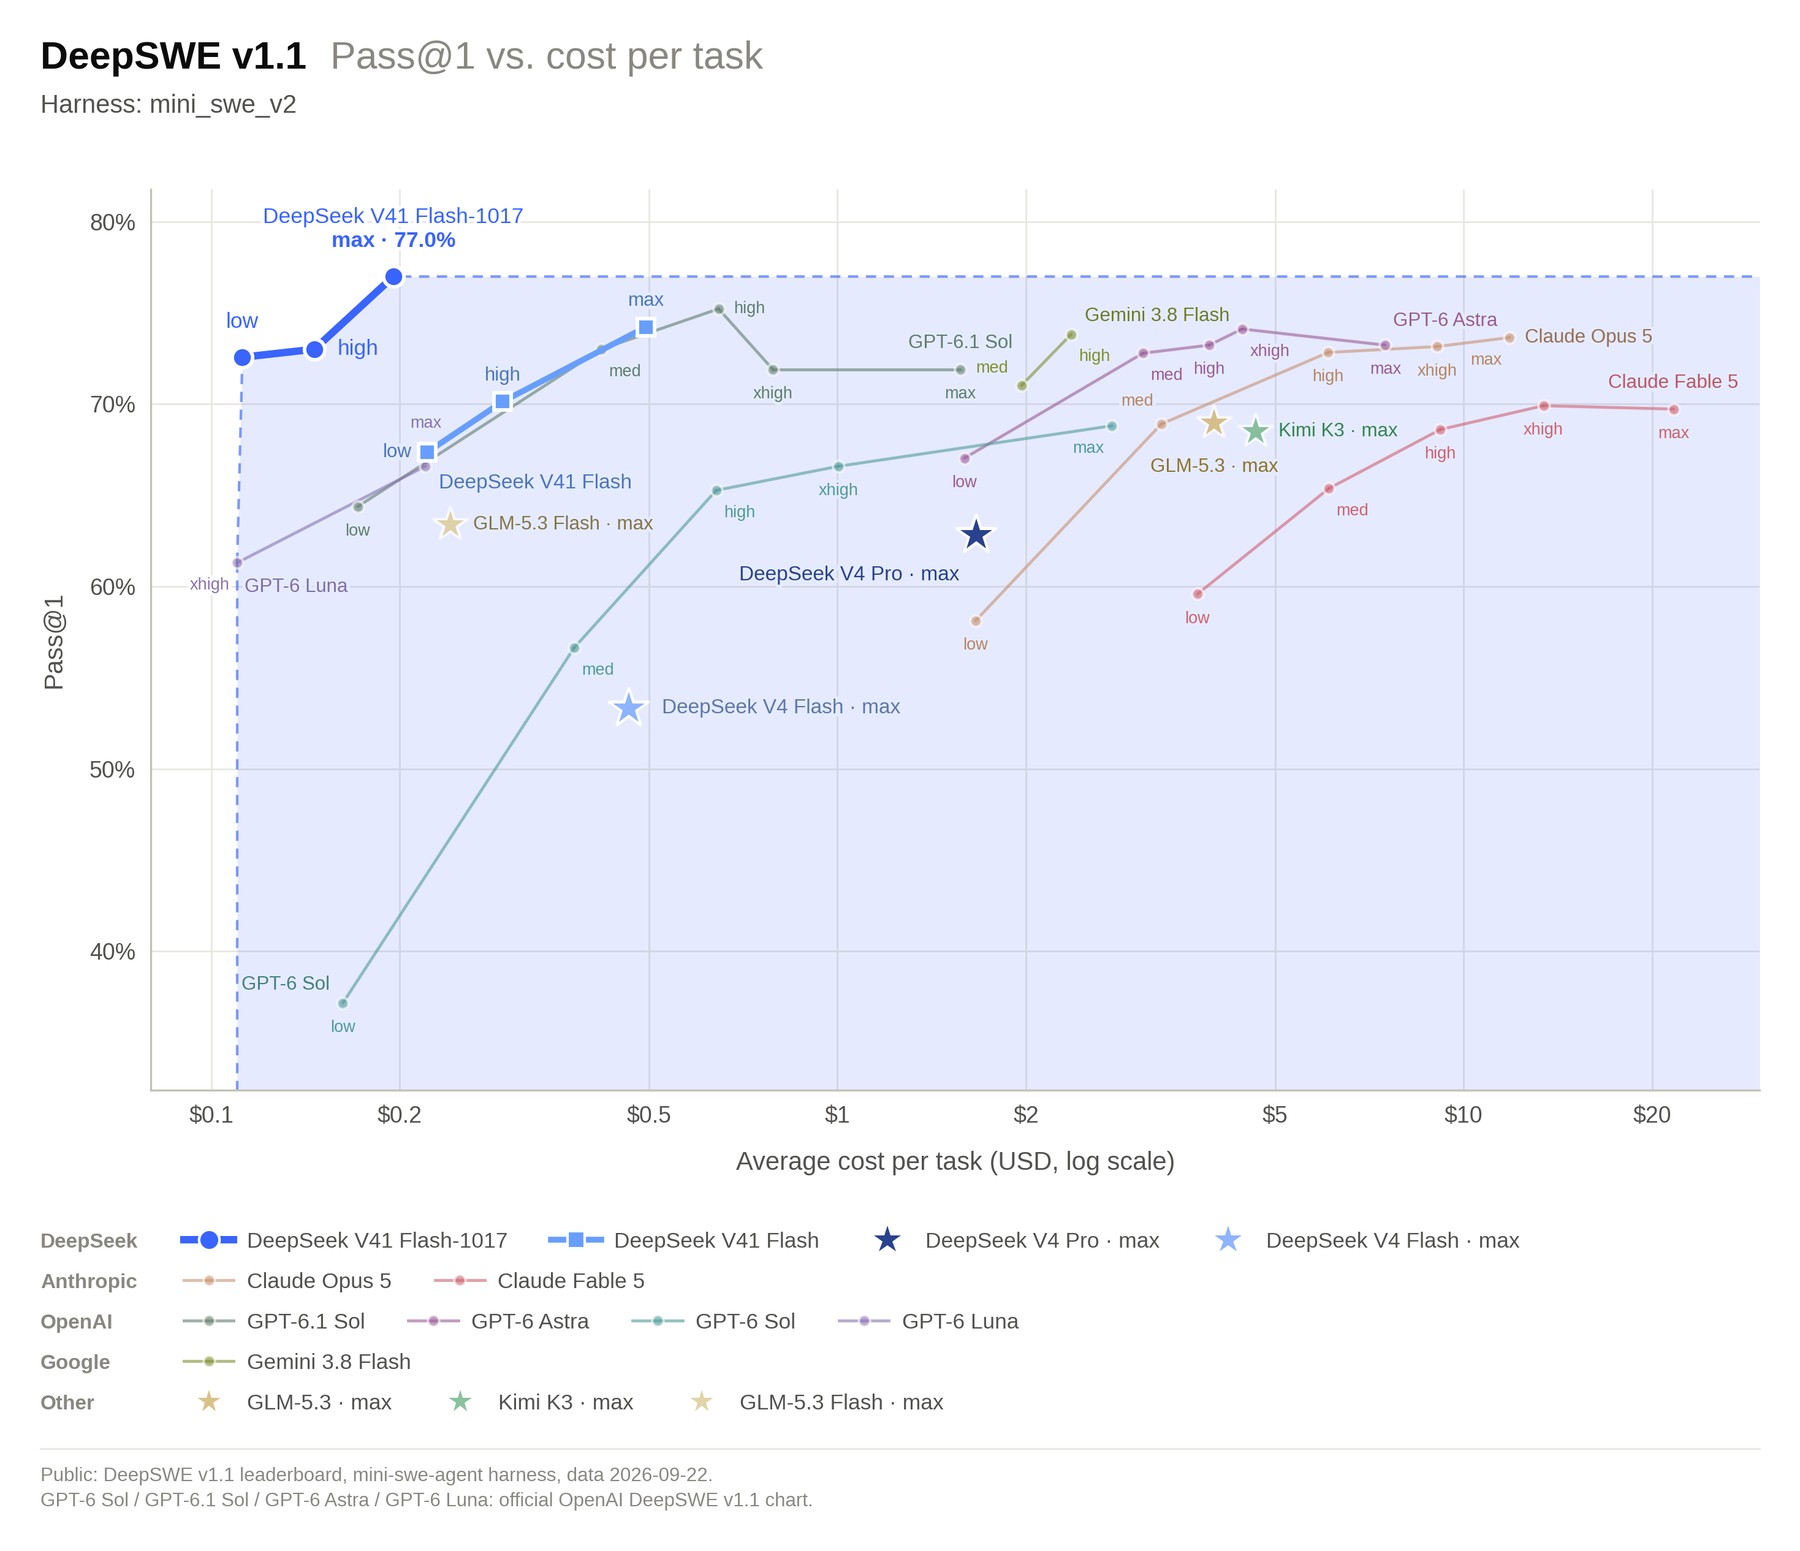 Figura: Curva oficial de rendimiento y coste, que muestra el gasto por tarea asociado al Pass@1 de DeepSWE v1.1. Fuente: Anuncio oficial de lanzamiento de DeepSeek
Los indicadores multimodales ratifican la eficacia de estas canalizaciones de entorno. En la prueba Chartography con llamadas a herramientas, la puntuación creció de 78,9 a 83,0 puntos. BabyVision avanzó de 89,6 a 92,5, y ZeroBench-main progresó de 49,0 a 51,0 puntos. La solidez ganada mediante la interacción en entornos reales se transfirió directamente a las tareas de percepción multimodal.
Reducción a 890 bytes por token: la caché KV establece un nuevo suelo de costes
La inferencia de agentes autónomos devora un volumen masivo de contexto. La ejecución recurrente de herramientas dilata el historial conversacional y satura en primer término el ancho de banda de memoria en las GPU. Para que los contextos ultraextensos pasen a ser una opción cotidiana por defecto, el coste por unidad de memoria intermedia debe desplomarse.
El diseño arquitectónico de V4.1-Flash proporciona el soporte de hardware necesario. Con una estructura codificador-decodificador causal de 552B parámetros en total, el modelo consumió 45 billones (45T) de tokens multimodales durante el preentrenamiento. En la etapa de decodificación activa únicamente 16B parámetros, y en la etapa de prellenado (prefill) tan solo 8B parámetros. Un prefill ultraligero reduce radicalmente la latencia hasta el primer token (TTFT).
El hito físico proviene de combinar la técnica de compresión de atención CSA2 con el almacenamiento en caché en formato FP4. La reutilización entre capas permite condensar la caché global de claves y valores (KV cache) a apenas 890 bytes por token. Este consumo equivale a una cuarta parte del requerido por V4-Flash y a una fracción de apenas 1/437 respecto a la arquitectura de primera generación.
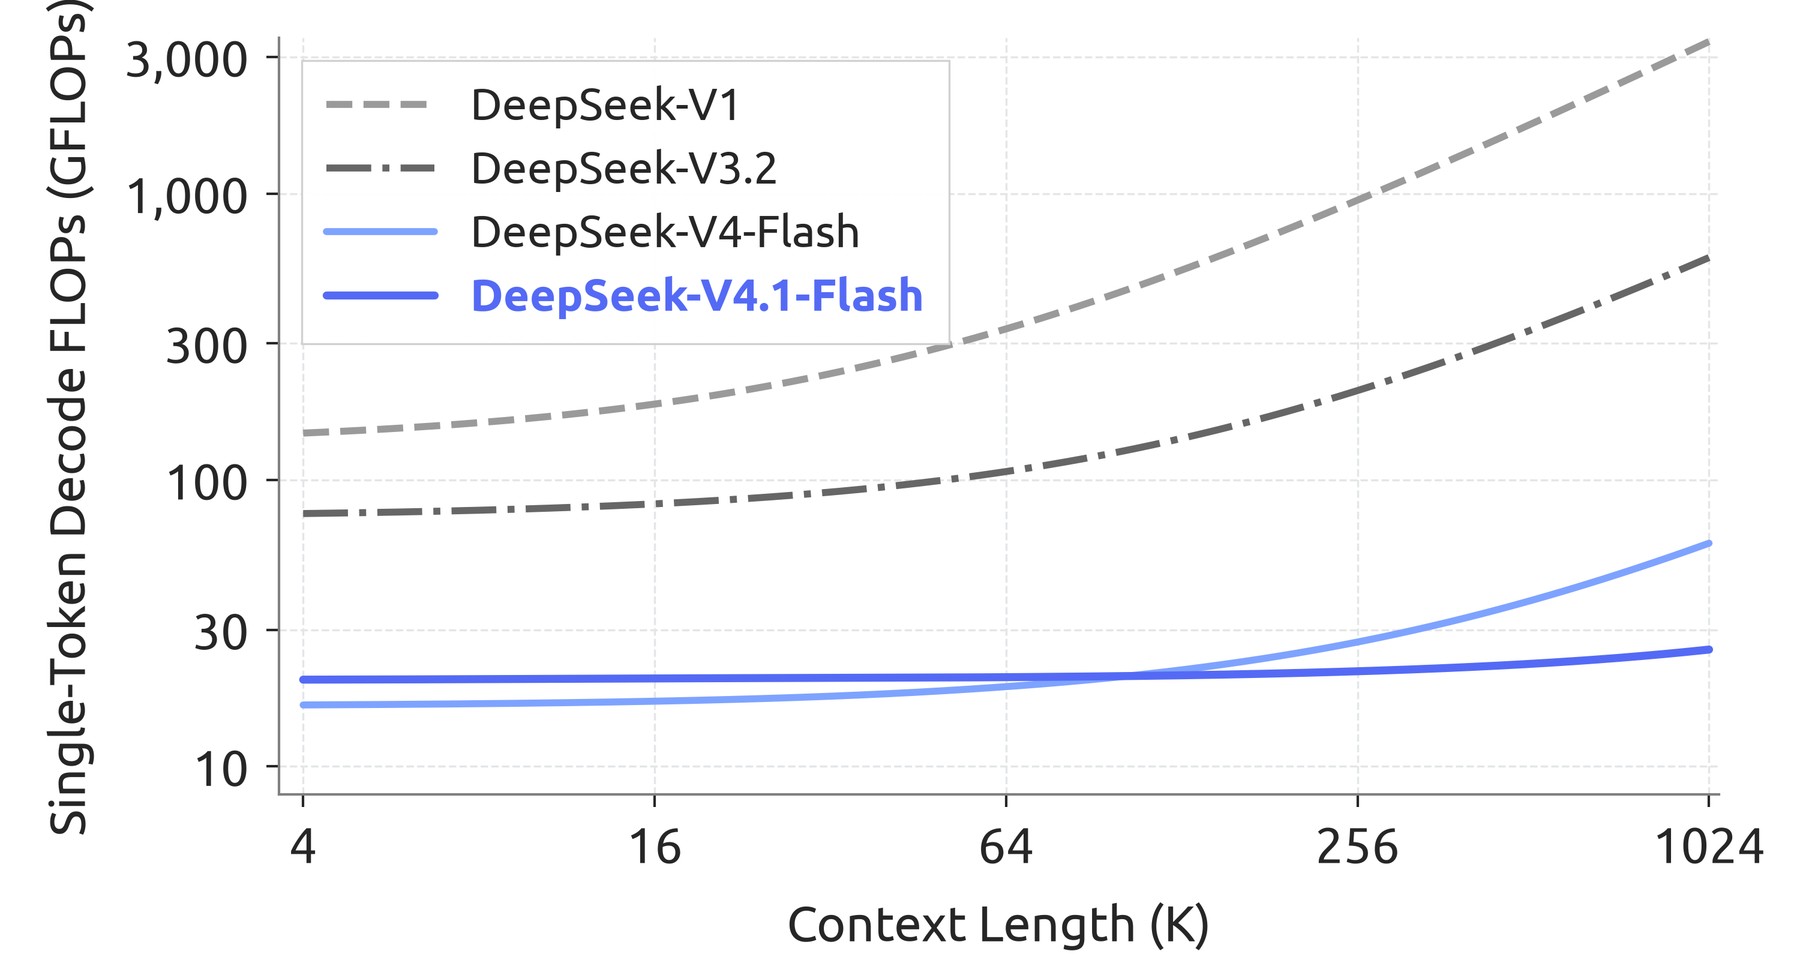 Figura: Cómputo requerido para decodificar un token individual a medida que el contexto se extiende hasta 1M de tokens. Fuente: Informe técnico de DeepSeek-V4.1-Flash
Al integrarse con un mecanismo de reproducción de límites en atención por ventana deslizante, el requisito de caché persistente se contrajo a una octava parte del modelo previo. La curva de cómputo muestra una estabilidad equiparable: expandir el contexto 256 veces, de 4K a 1M de tokens, solo eleva las operaciones de punto flotante por token decodificado en un 25 %. Trabajar con un millón de tokens deja de ser una extravagancia prohibitiva y se convierte en el estándar de fábrica.
Abandono de plantillas Jinja: la ingeniería de prompts cede el testigo a protocolos nativos
El abaratamiento de los costes de inferencia está forzando una rápida modernización de la cadena de herramientas superior. En la plataforma de alojamiento OpenRouter, la tarifa de entrada se situó en 0,10 dólares por millón de tokens. La tarifa de salida se mantiene en 0,50 dólares, y la lectura de caché se ha recortado a unos mínimos 0,002 dólares.
A la par, DeepSeek abrió el acceso a sus API propietarias de Search y Fetch. Este motor de búsqueda, que atiende cientos de millones de peticiones externas al día, tiene una tarificación de 0,75 dólares por cada mil invocaciones. Tanto en las aplicaciones oficiales como en los asistentes de código más populares, el servicio se ofrece de forma gratuita hasta el 31 de octubre de 2026. Disponer de búsquedas económicas rescata a los agentes de las limitaciones cronológicas del preentrenamiento estático.
Esta versión prescinde por completo de los archivos de plantillas Jinja convencionales. DeepSeek distribuye en su lugar una implementación de referencia autónoma en Python y una biblioteca nativa en Rust con enlaces para Python. El analizador gestiona de forma nativa conversaciones multiturno, cadenas de pensamiento (Chain-of-Thought), inyección intermedia de mensajes de sistema y marcado mixto de texto e imagen. Trasladar el procesamiento a la biblioteca base elimina de raíz los fallos de desalineación sintáctica.
Los hiperparámetros recomendados de muestreo revelan un criterio nítido: la temperatura y el valor Top-P se fijan en 1,0, exigiendo una longitud máxima de secuencia de salida no menor a 256K tokens. A lo largo de la ventana de un millón de tokens, el modelo debe mantener una adherencia estricta a instrucciones de largo plazo. El empleo de bibliotecas de comunicación estructurada disipa las vulnerabilidades de análisis que históricamente afectaban a las llamadas a herramientas basadas en plantillas.
Los entornos interactivos marcan el punto de inflexión: la pugna de benchmarks regresa al rendimiento de ingeniería
La conclusión que arroja la instantánea 1017 es rotunda: los beneficios directos de optimizar algoritmos sufren rendimientos decrecientes; en cambio, escalar entornos interactivos verificables y perfeccionar las fases de calibración puede impulsar subidas de dos dígitos en los marcadores de referencia.
Por su parte, una huella de memoria de 890 bytes apuntala la viabilidad operativa a gran escala. Solo cuando los costes de lectura y escritura son insignificantes resulta viable implementar bucles continuos de ensayo y error. El pulso del ecosistema de código abierto ya no se libra en el ajuste fino de parámetros, sino en la capacidad de orquestar entornos y sistemas acoplados: quien consiga proveer mundos interactivos comprobables al menor coste marcará la próxima frontera del rendimiento.
Enlaces de referencia:
- Anuncio oficial de DeepSeek-V4.1-Flash-1017 y pesos abiertos del modelo
- Informe técnico de DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression
- Especificaciones técnicas de los benchmarks Terminal-Bench 4.0 y DeepSWE v1.1
- Debate técnico en la comunidad de Hacker News