算法配方原封不动,终端基准直接跳涨11点
2026 年 10 月 17 日,DeepSeek 放出了 V4.1-Flash-1017 权重快照。官方在技术报告中明确说明,新版本没有引入新算法,优化配方原封不动。但在考察终端操作的 Terminal-Bench 4.0 评测中,这个小版本的分数从 31.2 跳到了 42.3。
11.1 点的跨度拉开了身位。同一批评测里,Claude Opus 5 在 Terminal-Bench 4.0、ProgramBench、NL2Repo 和 HLE 上仍然领先,1017 则在 DeepSWE v1.1、Automation-Bench、Agents’ Last Exam 和 Apex Bench 四项上反超。这 11 点的增量没有对应任何算法改动。
官方称该版本为「愿望驱动编程」,主打端到端工程构建。演示案例涵盖故宫 3D 建模、网页赛车游戏,以及用 Godot 复刻经典游戏。与前代相比,新模型任务完成更快,输出 token 也更短。压缩无用输出降低了多轮对话的累积延迟。
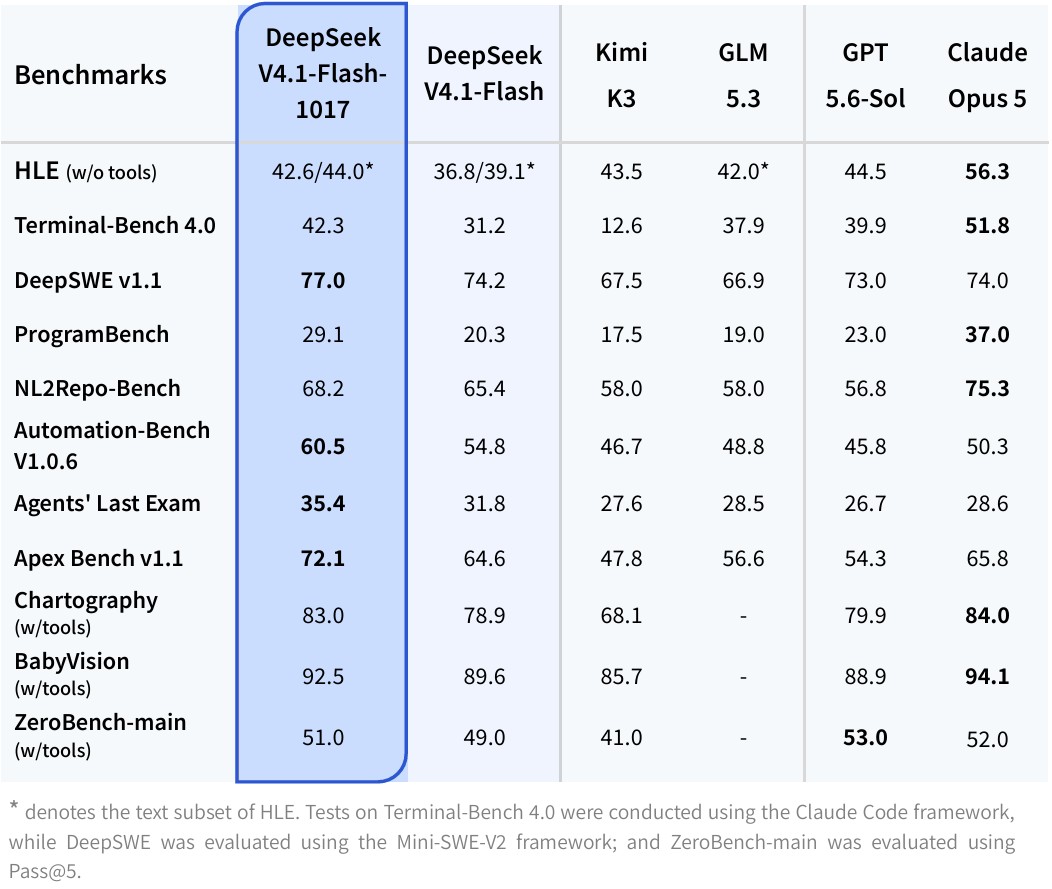 图:官方基准对比表,1017 快照与上一版的逐项差值。来源:DeepSeek 官方发布公告
其他智能体评测同样维持着上升走势。在 Claude Code 评测环境下,DeepSWE v1.1 的解决率从 74.2% 上扬至 77.0%。ProgramBench 从 20.3 提高到 29.1,Apex Bench v1.1 从 64.6 推进到了 72.1。自动化编码基准的上限正在被持续推高。
边际收益转向环境管线,合成任务撑起长程推理
技术报告 5.1 节揭示了跑分跃升背后的工程重心。后训练依然沿用监督微调、强化学习与同策略蒸馏的标准流程。团队把预算投向了合成任务与交互环境的构建。
报告给出了一个推断:当前阶段数据与环境管线的边际回报,显著超过算法创新。传统静态标注数据在复杂长程交互中很快见顶。终端调用需要状态回溯与错误捕获,必须依靠程序化合成提供支撑。
团队搭建起自动化管线,程序化构造出多样且可验证的交互空间。系统对合成任务执行严苛的去重过滤与难度标定。可验证的任务设定让强化学习获得稳定奖励,避免了策略探索中的奖励黑客行为。
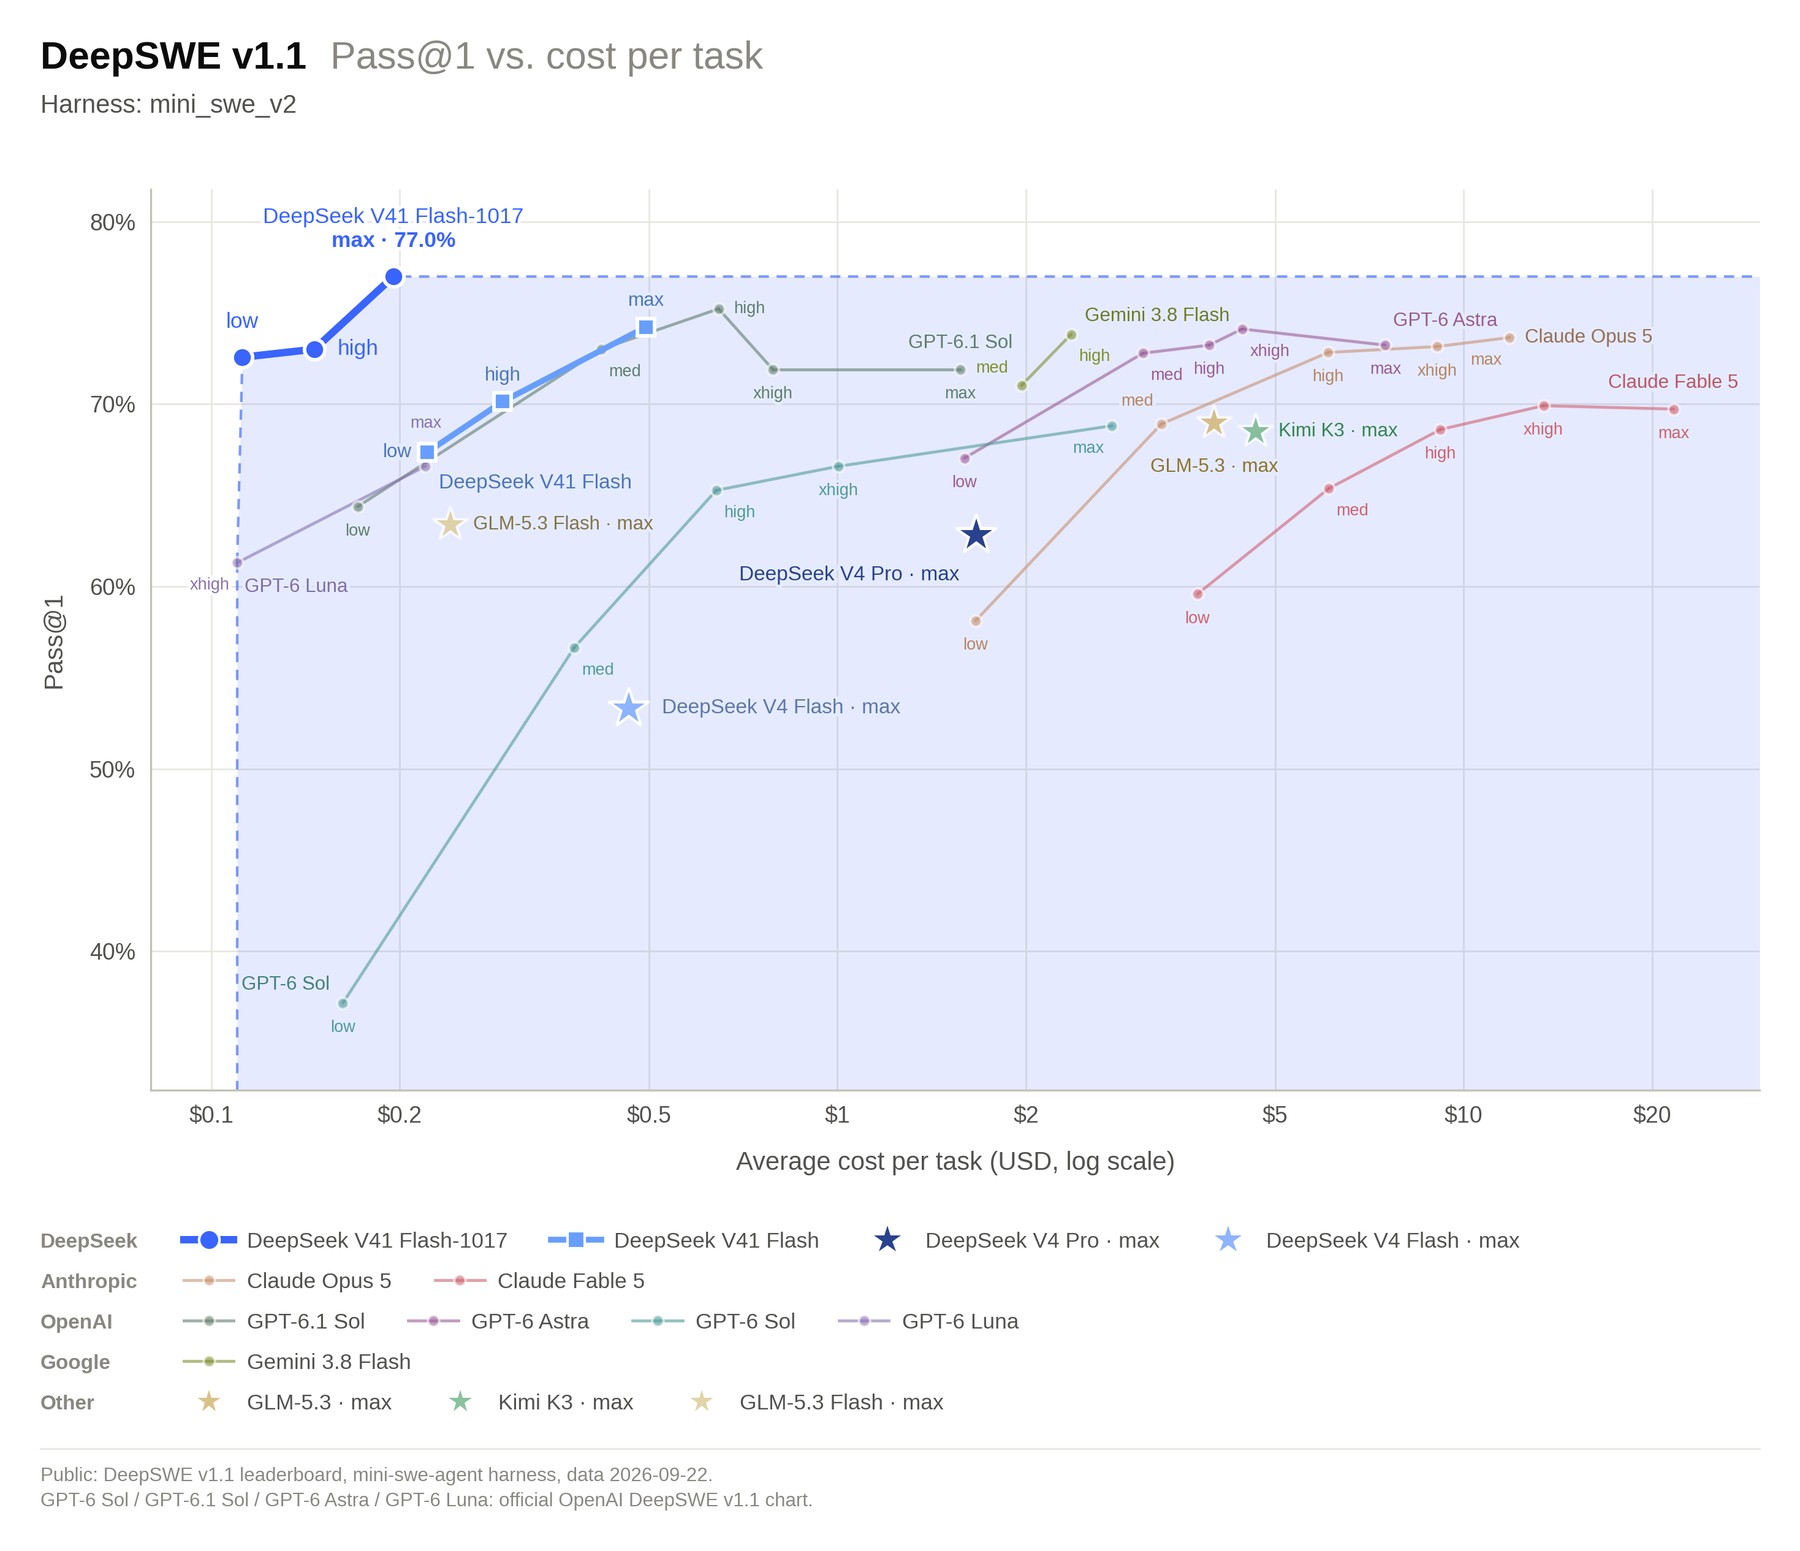 图:官方性能与成本曲线,展示 DeepSWE v1.1 Pass@1 对应的单任务开销。来源:DeepSeek 官方发布公告
多模态指标证实了环境管线的效果。在带工具调用的 Chartography 测试中,模型跑分从 78.9 升至 83.0。BabyVision 从 89.6 提高到 92.5,ZeroBench-main 也从 49.0 步入 51.0。真实环境交互带来的能力增益,直接外溢到了跨模态感知任务中。
每 token 压到 890 字节,KV 缓存筑起成本地板
智能体推理需要吃掉海量上下文。多轮工具调用不断拉长会话历史,显存带宽是第一个被吃紧的地方。长上下文要成为默认配置,单位缓存成本必须砸穿地板。
V4.1-Flash 的架构设计为此提供了硬件支撑。模型采用 552B 总参数的因果编解码器架构,预训练吸收了 45T 多模态数据。解码阶段激活 16B 参数,预填充阶段仅激活 8B 参数。轻量化的预填充大幅减少了首字延迟。
物理突破来自注意力压缩技术 CSA2 与 FP4 缓存的结合。跨层复用让全局 KV 缓存被压缩到每 token 仅 890 字节。这个开销相当于上一代 V4-Flash 的四分之一,只有第一代架构的四百三十七分之一。
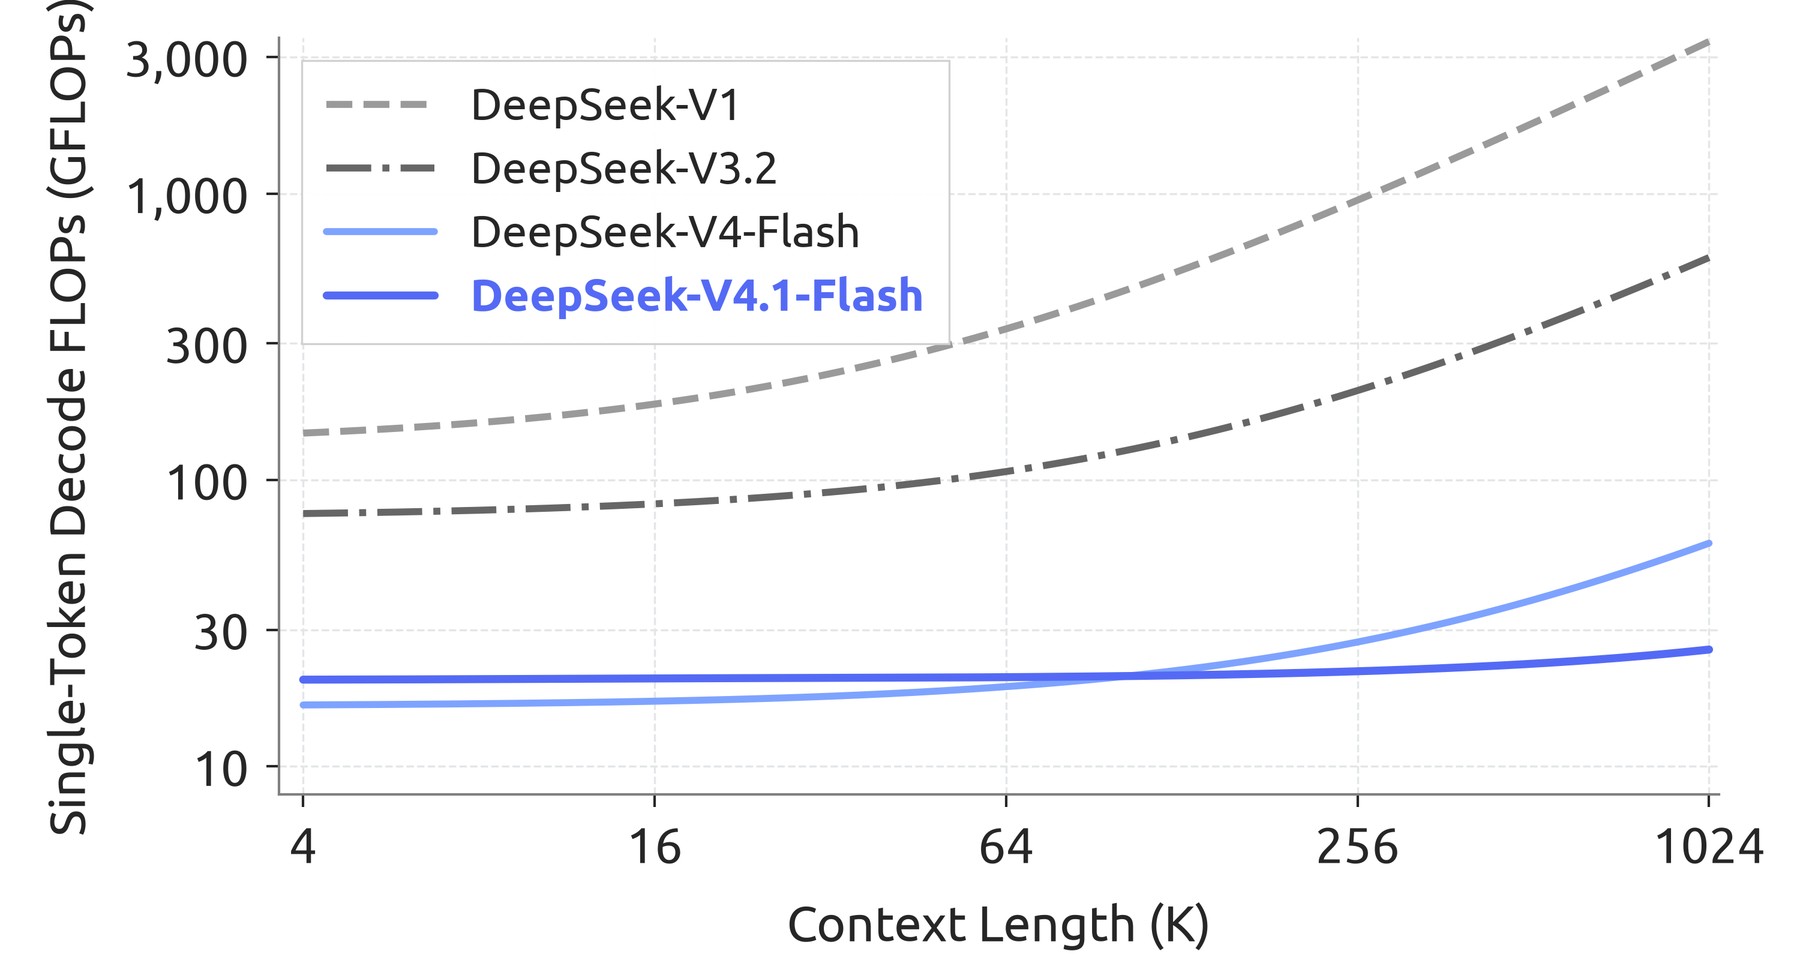 图:单 token 解码算力开销随上下文长度的变化,横轴延伸至 1M。来源:DeepSeek-V4.1-Flash 技术报告
配合滑动窗口注意力边界重放机制,持久化缓存进一步降至上一代的八分之一。算力曲线同样平缓。上下文从 4K 扩展至 1M 跨越了 256 倍,单 token 解码浮点运算量仅微增四分之一。长上下文至此从奢侈品变成默认配置。
废弃 Jinja 模板,工程细节全面让位自动化协议
推理成本的下降直接倒逼应用侧工具链演进。在托管平台 OpenRouter 上,该模型的输入定价为每百万 token 0.10 美元。输出定价维持在 0.50 美元,缓存读取费用更是压低至 0.002 美元。
官方同步开放了自研的 Search 与 Fetch 接口。该检索系统每日支撑数亿次外部请求,每千次端点调用收费 0.75 美元。在官方与主流编码辅助工具中,这项功能保持免费至 2026 年 10 月 31 日。廉价检索让智能体摆脱了离线知识的局限。
这一代发布不再提供传统的 Jinja 模板文件。官方转而提供自包含的 Python 参考实现,并配套了带有 Python 绑定的 Rust 库。解析器覆盖了多轮交互、思维链模式、中途注入系统消息与图文混排标记。底层库接管解析消除了格式错位的风险。
推荐的采样超参数展示了明确的导向。采样温度与核采样概率均设定在 1.0,最大输出序列长度要求不小于 256K。在百万 token 窗口中,模型需要保持对长程约束的严格执行。结构化通信库的引入,消除了模板层在多工具调用下的解析隐患。
交互环境成为分水岭,基准竞争回归工程吞吐
1017 快照给出的信号很直接。优化算法的收益在递减,把可验证环境做大、校准管线做扎实,基准同样能跳涨两位数。
890 字节的缓存则构筑了部署底座。读写成本降到可以忽略,高频试错才谈得上落地。开源生态的胜负手已经从权重参数挪到了环境管线与系统协同上:谁能以更低的成本持续供给可验证的交互世界,谁就摸到了下一段性能边界。
参考链接:
- DeepSeek-V4.1-Flash-1017 官方发布公告与开源模型权重
- DeepSeek-V4.1-Flash 技术报告:Pushing the Limits of KV Cache Compression
- Terminal-Bench 4.0 与 DeepSWE v1.1 基准测试技术规程
- Hacker News 社区技术讨论记录