单日吞吐 155 万亿 tokens 揭开工业级底牌
2026 年 10 月 20 日,DeepSeek 正式开源推理框架 DeepInfer。配套放出的还有协议解析库 deepseek-recipe 与一组运营数据。单集群日均处理 155 万亿 tokens,平均每卡每小时产生 38 美元账面流水。这套框架直接展示了超大规模生产环境的真实吞吐水位。
38 美元的卡时收益按闲时挂牌价折算,反映的是全集群流水,并非净利润。在两阶段机器比例 1:1 的配置下,单卡每小时理论流水约 36.7 美元,与公布值仅差 3%。超大规模集群能够保持低偏离度运转,表明线上流量调度已经具备成熟的工业级平准能力。
硬件支持列表界定了框架的技术边界。首发版本仅支持英伟达 SM100 与华为昇腾 950 两款高端算力卡,消费级显卡被排除在外。编译环境要求 Linux、GCC 13.0 与 Python 3.12,底层分别接入 CUDA 13 与 CANN 9.2。架构设计紧密围绕超大规模数据中心的高密并发展开,放弃了轻量化兼容。
96% 缓存命中率撑起 25 倍性能鸿沟
前缀缓存命中率是拉开性能代差的核心支点。官方报告显示,在无缓存命中的冷启动状态下,单张 SM100 的 Prefill 吞吐为每秒 6 万 tokens。一旦命中前缀缓存,单卡吞吐瞬间跃升至每秒 150 万 tokens。25 倍的性能鸿沟清楚表明,重复计算前缀正在严重损耗有效算力。
线上环境的平均输入长度达到 7.7 万 tokens。全局首字延迟平均为 400 毫秒,P99 控制在 1000 毫秒以内。为了支撑长会话复用,系统搭建了保留 72 小时的独立分布式 KVCache 存储集群。没有独立外部存储集群的生命周期管理,96% 的前缀缓存命中率根本无法在线上转化为持续的吞吐收益。
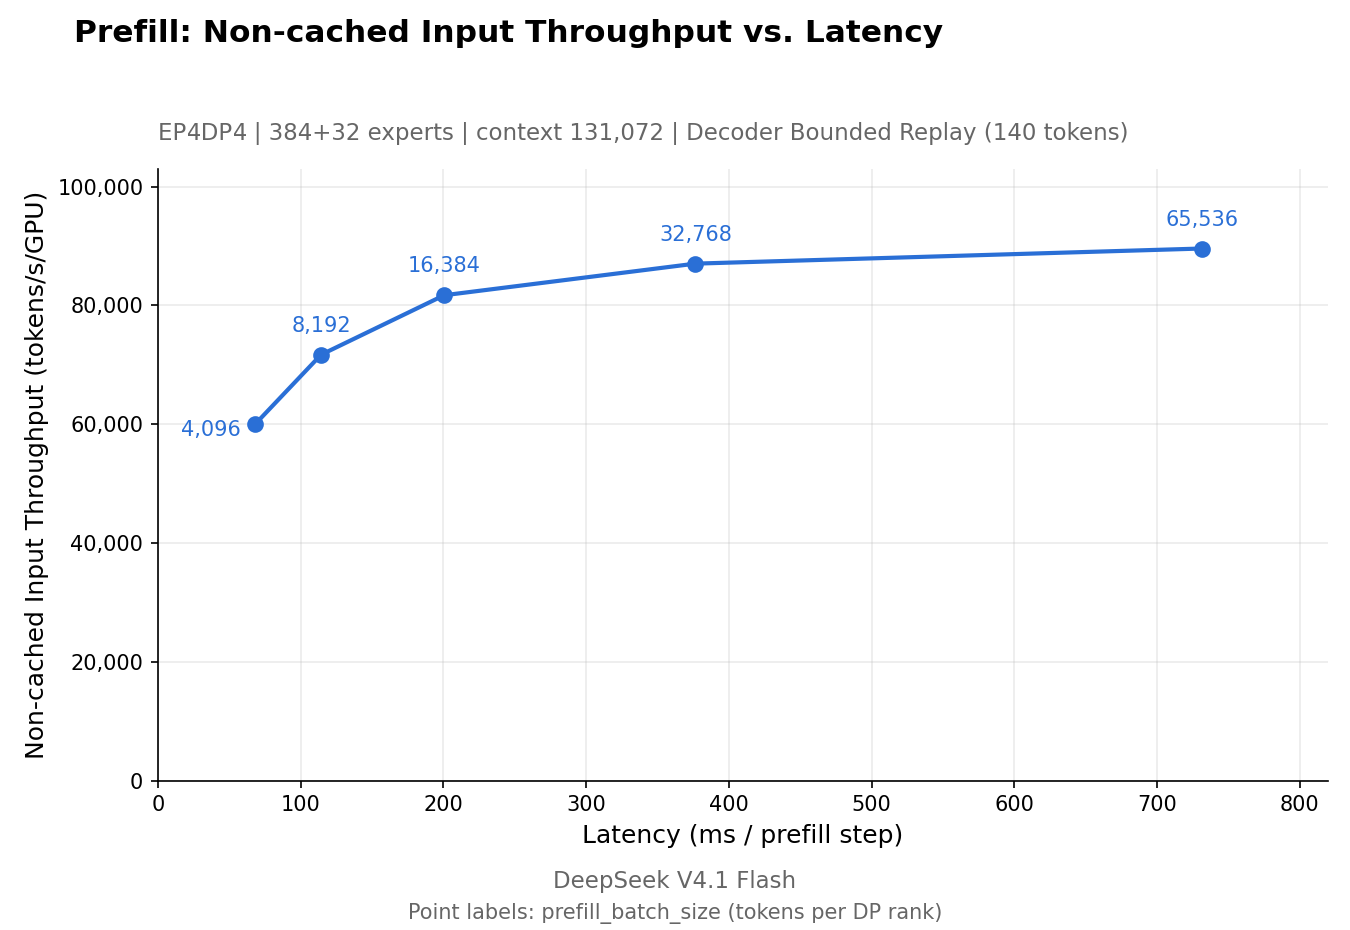 图:DeepInfer 官方 Prefill Pareto 曲线(吞吐 vs 延迟),基于 4 张 SM100 节点测试。注意图中缓存命中状态下吞吐量随并发增加而急剧爬升,且首字延迟始终保持平缓。来源:deepseek-ai/DeepInfer
缓存命中率直接重塑了推理成本曲线。官方定价中,输入缓存命中的单价为 0.02 元每百万 tokens,未命中则升至 1 元。当命中率从 96% 下滑至 80% 时,折算后的有效输入单价会从 0.06 元跃升至 0.22 元。缓存复用率是控制实际支出的关键旋钮,账面算力峰值反而是次要指标。
昇腾 950 与 SM100 并列进入首发支持列表
华为昇腾 950 在框架源码中获得了一等公民地位。开发者声明 export DEEPINFER_ACCELERATOR=ascend 即可完成编译,底层直连 CANN 9.2。国产计算芯片由此告别了社区外挂移植的从属角色,正式进入官方原生支持阵营。
这一突破依托于长期的全栈底层攻坚。官方此前已开源注意力算子 FlashMLA、通信库 DeepEP 以及矩阵运算库 DeepGEMM。昇腾版 DeepGEMM 在昇腾 950DT 上实现了密集矩阵乘法 99.8% 的硬件极限利用率。配合开源的模型权重,底层算子、通信编排与顶层框架完成了全链条贯通。
统一框架拉平了异构硬件平台的工程调度体验。面对相同的模型负载,昇腾 950 与 SM100 运行在同一套流水线逻辑之下。国产算力能够在万亿级日吞吐的生产框架中承担主力角色,标明国产软硬件生态跨过了从功能可用到工业落地的关键门槛。
四项工程重构消除长序列与批调度损耗
生成阶段对吞吐与单请求吐字速率提出了双重要求。在 64 张 SM100 组成的单域内,Decode 吞吐达每卡每秒 1.4 万 tokens,单用户输出速率维持在 230 tps。Prefill 节点与 Decode 节点的物理机数量维持在 1:1 配比。这打破了传统架构中生成节点规模数倍于预填充节点的行业惯例。
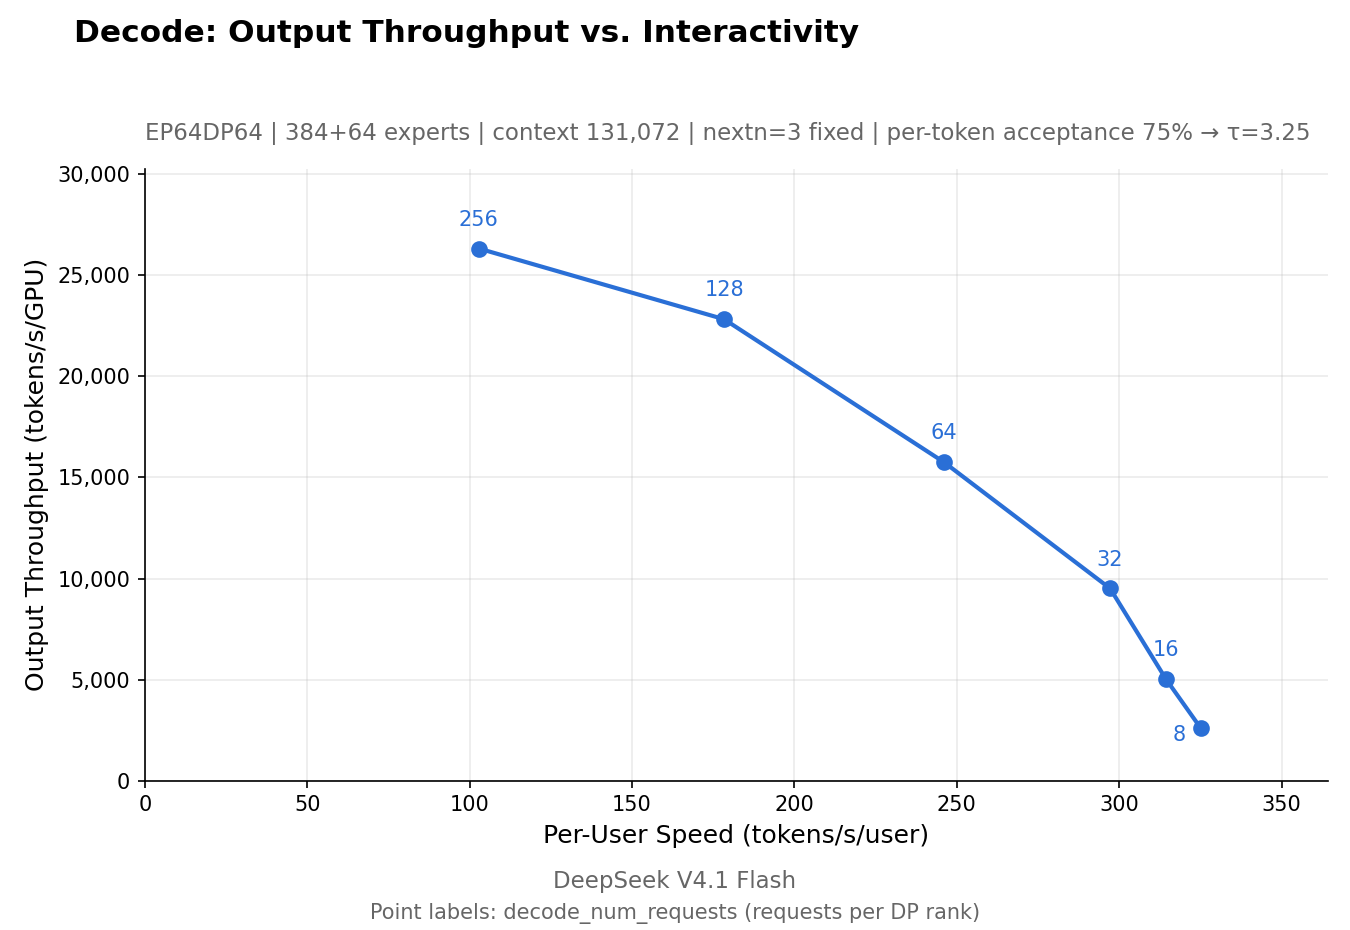 图:DeepInfer 官方 Decode Pareto 曲线,基于 64 张 SM100 节点测试。注意曲线在高并发批处理状态下仍保持平稳吐字速度,兼顾了集群总吞吐与单用户响应延迟。来源:deepseek-ai/DeepInfer
长序列重算损耗被滑动窗口有界重放机制化解。传统滑动窗口在超出边界时往往需要全量重算历史上下文。DeepInfer 强制重放过程锁定在 140 个 tokens 的有界后缀内。无论序列长度如何增长,历史重算代价始终收敛为固定的常数开销。
投机解码机制依托 DSpark 并行草稿模块与动态置信度调度实现提速。算法根据引擎当前负载动态决定验证长度。这一设计在同等吞吐下较 MTP-1 基准带来 60% 至 85% 的单用户生成加速,为集群贡献了 6% 的吞吐增量。
异步调度器实现了 CPU 编排与 GPU 执行重叠,抹平了批处理空泡。英伟达平台上开启批不变性参数后,即可获得确定性输出。辅助库 deepseek-recipe 则统一了多类 API 请求格式,负责提示词组装与结构化校验。
核心引擎开源划定生产集群运维边界
框架开源的范围带有清晰的工程分水岭。本次发布集中在离线推理与单机规模化核心,超大规模线上服务组件仍保留在内部。独立的分布式 KVCache 系统与跨副本负载均衡器均未进入开源代码。
这种取舍清晰界定了企业自建与官方服务的差距。开发者可以吸收算子调优与批处理调度的完整经验,在本地复现高效的性能曲线。但要支撑起高可用公有云服务,超大规模集群的运维底座依然必不可少。
大模型价格战的战线已经转移到底层推理工程。模型权重只展示了能力上限,调度栈才决定了每一批 token 的真实交付成本。当昇腾 950 与 SM100 共同承载起单日 155 万亿 tokens 的严苛负载,单卡峰值算力已退居次席。系统级的全栈调度与工程打磨,才是支撑产业规模化落地的终极基石。
参考链接:
- DeepInfer 官方代码仓库与架构说明
- deepseek-recipe 协议解析与格式化库
- DSpark 投机采样算法技术论文(arXiv:2607.05147)
- Hacker News 社区技术讨论