일일 155조 토큰 처리량이 드러낸 산업 수준의 인프라
2026년 10월 20일, DeepSeek이 프로덕션 추론 프레임워크인 DeepInfer를 공식 오픈소스로 공개했습니다. 함께 공개된 프로토콜 파싱 라이브러리 deepseek-recipe와 실제 운영 지표에 따르면, 단일 클러스터에서 일일 평균 155조 개의 토큰을 처리하며 가속기 카드당 시간당 38달러의 장부상 매출을 기록했습니다. 이 프레임워크는 초대규모 프로덕션 환경의 실질적인 처리량 기준을 명확히 보여줍니다.
카드당 시간당 38달러의 수익은 비혼잡 시간대 표시 가격을 기준으로 클러스터 전체 매출을 환산한 수치이며 순이익은 아닙니다. 프리필(Prefill)과 디코드(Decode) 장비 비율을 1:1로 구성했을 때 이론상 카드당 시간당 매출은 약 36.7달러로, 공식 발표치와의 차이는 3%에 불과합니다. 초대규모 클러스터가 이처럼 낮은 편차로 안정적으로 작동한다는 점은 온라인 트래픽 조율 능력이 이미 성숙한 산업 수준에 도달했음을 입증합니다.
지원 하드웨어 목록은 프레임워크의 기술적 지향점을 명확히 보여줍니다. 첫 릴리스에서는 엔비디아 SM100과 화웨이 어센드 950 두 종류의 고성능 가속기만 지원하며, 소비자용 그래픽카드는 지원 대상에서 완전히 배제되었습니다. 빌드 환경은 리눅스, GCC 13.0, 파이썬 3.12를 요구하며 하위 레이어에서 각각 CUDA 13과 CANN 9.2에 직접 연동됩니다. 대규모 데이터센터의 고밀도 병렬 처리에 최적화된 아키텍처 설계로, 경량화 호환성을 과감히 배제했습니다.
96% 캐시 적중률이 만들어낸 25배의 성능 격차
접두사(Prefix) 캐시 적중률은 세대 간 성능 격차를 가르는 핵심 지표입니다. 공식 벤치마크에 따르면 캐시가 없는 콜드 스타트 상태에서 SM100 단일 카드의 프리필 처리량은 초당 6만 토큰에 불과합니다. 그러나 접두사 캐시가 적중하는 순간 단일 카드 처리량은 초당 150만 토큰으로 급증합니다. 25배에 달하는 성능 차이는 접두사 반복 계산이 유효 연산 자원을 얼마나 심각하게 낭비하고 있었는지를 명백히 보여줍니다.
실제 서비스 환경에서 평균 입력 길이는 7만 7천 토큰에 이릅니다. 첫 토큰 생성 지연 시간(TTFT)은 평균 400밀리초, 상위 99%(P99)는 1,000밀리초 이내로 유지됩니다. 긴 세션의 재사용을 지원하기 위해 시스템은 데이터를 72시간 동안 보관할 수 있는 독립적인 분산 KVCache 스토리지 클러스터를 구축했습니다. 외부 독립 스토리지 클러스터의 수명 주기 관리가 없다면 96%의 캐시 적중률은 프로덕션 환경에서 지속적인 처리량 증가로 이어질 수 없습니다.
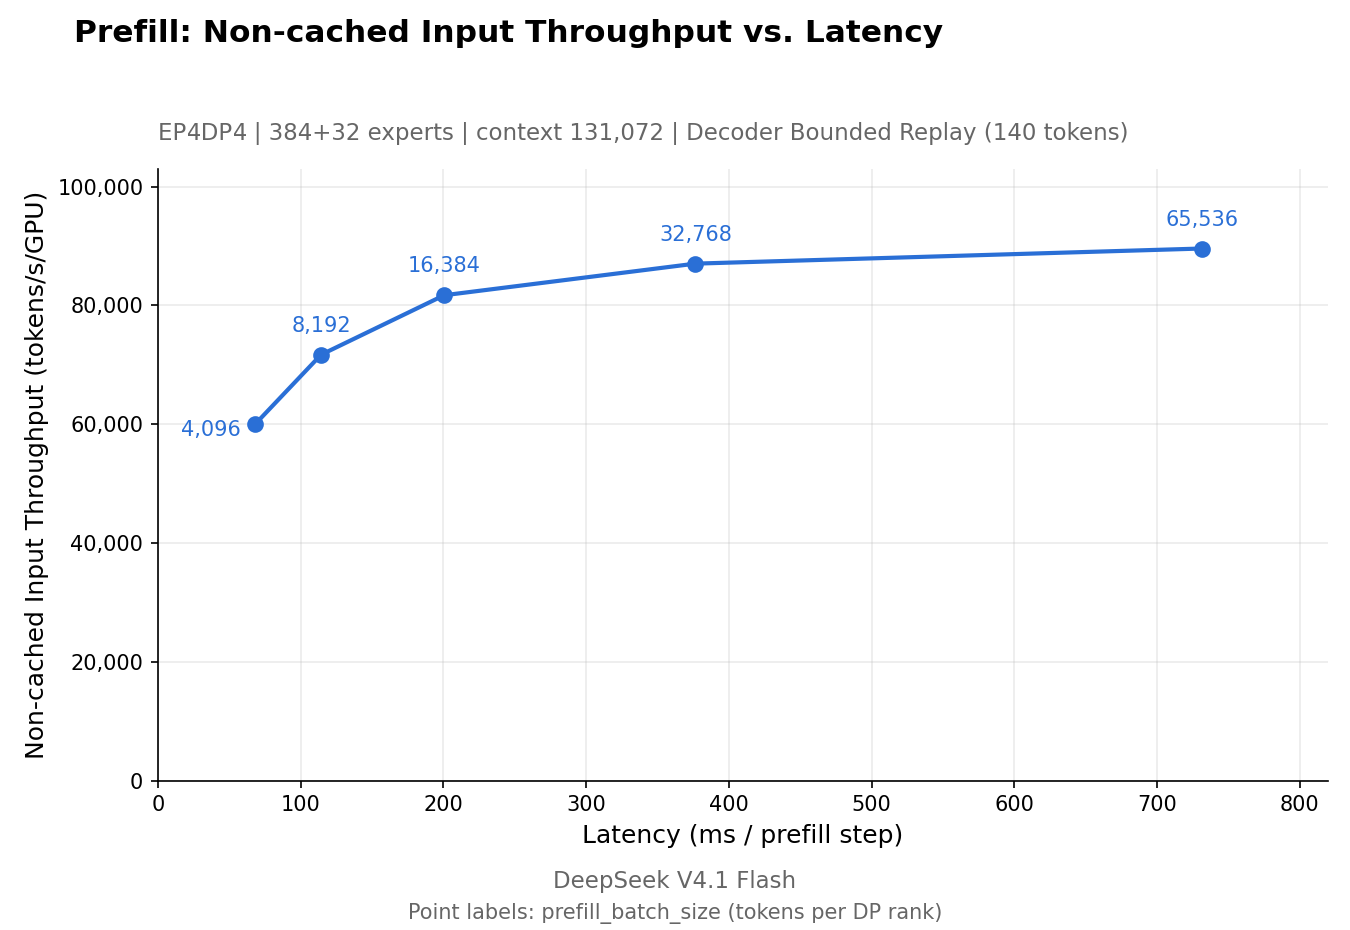 그림: DeepInfer 공식 Prefill 파레토 곡선(처리량 대 지연 시간), SM100 4장 노드 기반 테스트 결과. 캐시 적중 상태에서는 동시 요청이 증가해도 처리량이 급격히 상승하며 첫 토큰 생성 지연 시간이 안정적으로 유지되는 점을 확인할 수 있습니다. 출처: deepseek-ai/DeepInfer
캐시 적중률은 추론 비용 구조를 근본적으로 바꿉니다. 공식 요금 체계에서 입력 캐시가 적중했을 때의 가격은 백만 토큰당 0.02위안이지만, 적중하지 않으면 1위안으로 50배 치솟습니다. 캐시 적중률이 96%에서 80%로 떨어지면 실제 유효 입력 단가는 0.06위안에서 0.22위안으로 세 배 이상 폭등합니다. 캐시 재사용률이야말로 실제 지출을 제어하는 핵심 요소이며, 장부상의 최고 연산 수치는 부차적인 지표에 불과합니다.
어센드 950과 SM100, 1급 플랫폼으로 나란히 지원
화웨이 어센드 950은 프레임워크 소스코드 수준에서 동등한 1급 플랫폼으로 대우받습니다. 개발자는 export DEEPINFER_ACCELERATOR=ascend 설정만으로 컴파일을 완료할 수 있으며 하위 레이어에서 CANN 9.2와 직접 연동됩니다. 이로써 중국산 AI 연산 칩은 커뮤니티의 외부 이식 수준을 벗어나 공식 네이티브 지원 진영에 진입했습니다.
이러한 성과는 장기적인 풀스택 로우레벨 연구개발에 기반합니다. DeepSeek은 이전에 어텐션 연산자 FlashMLA, 통신 라이브러리 DeepEP, 행렬 연산 라이브러리 DeepGEMM을 잇따라 오픈소스로 공개했습니다. 어센드 950DT 전용 DeepGEMM은 밀집 행렬 곱셈에서 하드웨어 한계의 99.8%에 달하는 이용률을 기록했습니다. 오픈된 모델 가중치와 함께 로우레벨 연산자, 통신 조율, 최상위 프레임워크까지 전체 체인이 완성되었습니다.
통합 프레임워크는 서로 다른 하드웨어 플랫폼 간의 엔지니어링 운영 경험을 표준화했습니다. 동일한 모델 워크로드에서 어센드 950과 SM100은 동일한 파이프라인 로직으로 구동됩니다. 중국산 하드웨어가 일일 150조 토큰을 처리하는 프로덕션 프레임워크에서 주력 역할을 담당하게 된 것은, 자체 소프트웨어와 하드웨어 생태계가 단순한 기능 검증을 넘어 산업 현장 적용이라는 결정적 고비를 넘었음을 의미합니다.
긴 시퀀스와 배치 처리 오버헤드를 줄인 4가지 엔지니어링 혁신
생성 단계에서는 전체 클러스터 처리량과 단일 요청 출력 속도를 동시에 만족시켜야 합니다. SM100 64장으로 구성된 단일 도메인에서 디코드 처리량은 카드당 초당 1만 4천 토큰에 달하며, 단일 사용자 출력 속도는 초당 230토큰을 유지합니다. 프리필 노드와 디코드 노드의 물리 장비 비율은 1:1로 유지되어, 디코드 노드를 프리필 노드의 수배로 배치하던 기존 업계 관행을 완전히 바꿨습니다.
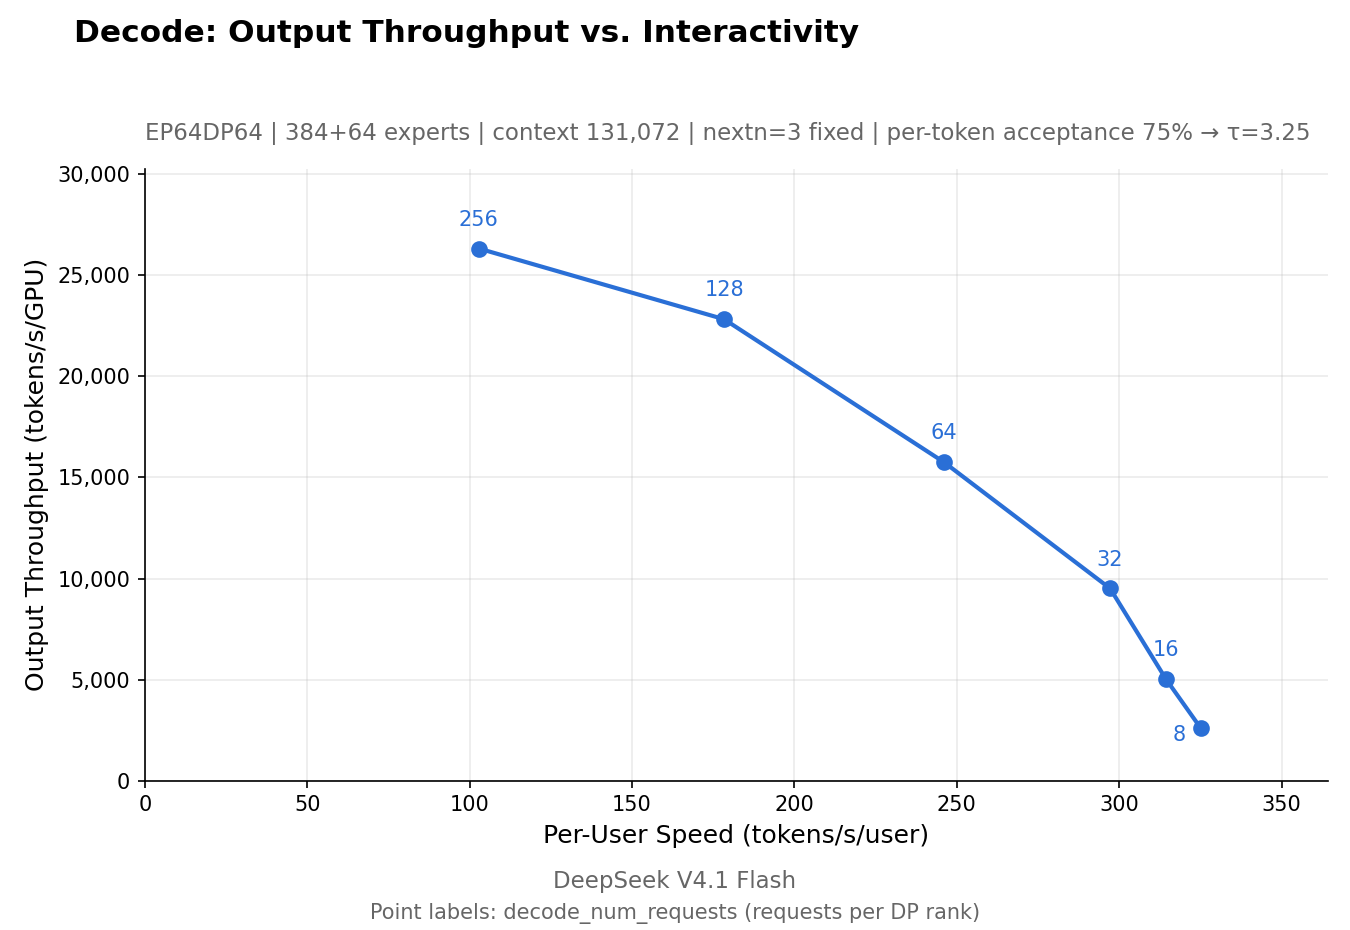 그림: DeepInfer 공식 Decode 파레토 곡선, SM100 64장 노드 기반 테스트 결과. 높은 동시 배치 처리 상태에서도 토큰 출력 속도가 안정적으로 유지되어 클러스터 총 처리량과 단일 사용자 응답 지연 시간의 균형을 이룹니다. 출처: deepseek-ai/DeepInfer
긴 시퀀스의 재계산 오버헤드는 슬라이딩 윈도우 유계 리플레이 메커니즘을 통해 해결되었습니다. 기존의 슬라이딩 윈도우는 경계를 벗어날 때 과거 컨텍스트 전체를 재계산해야 하는 경우가 많았습니다. DeepInfer는 리플레이 범위를 140개 토큰의 고정된 접미사 영역으로 제한합니다. 시퀀스 길이가 아무리 길어져도 과거 컨텍스트 재계산 비용은 항상 일정한 상수로 수렴합니다.
추측 디코딩은 DSpark 병렬 초안 모듈과 동적 신뢰도 스케줄링을 통해 속도를 끌어올립니다. 엔진의 실시간 부하에 따라 검증 길이를 동적으로 조절하는 이 방식은, 동일한 처리량 기준 기존 MTP-1 대비 60%에서 85%의 단일 사용자 생성 가속을 달성하며 클러스터 전체 처리량을 6% 향상시켰습니다.
비동기 스케줄러는 CPU의 작업 분배와 GPU의 연산 실행을 겹치게 하여 배치 처리 간극을 없앴습니다. 엔비디아 플랫폼에서 배치 불변성 매개변수를 활성화하면 확정적인 출력을 얻을 수 있습니다. 보조 라이브러리인 deepseek-recipe는 다양한 API 요청 형식을 표준화하여 프롬프트 구성과 구조화 검증을 담당합니다.
핵심 엔진 오픈소스 공개가 드러낸 프로덕션 운영의 경계
프레임워크의 공개 범위에는 명확한 엔지니어링 기준이 적용되었습니다. 이번 공개는 오프라인 추론과 단일 노드 확장 코어에 집중되었으며, 대규모 온라인 서비스 인프라는 비공개로 유지되었습니다. 72시간 동안 유지되는 분산 KVCache 스토리지 시스템과 복제본 간 글로벌 로드 밸런서는 오픈소스 코드에 포함되지 않았습니다.
이러한 구분은 기업의 자체 구축 환경과 공식 클라우드 서비스 간의 차이를 명확히 보여줍니다. 개발자는 연산자 최적화와 배치 스케줄링 기술을 활용해 로컬 환경에서도 뛰어난 성능 곡선을 재현할 수 있습니다. 그러나 고가용성 퍼블릭 클라우드 서비스를 안정적으로 제공하려면 대규모 클러스터 운영 인프라가 여전히 필수적입니다.
인공지능 모델의 가격 경쟁은 이제 하위 추론 엔지니어링 영역으로 전환되었습니다. 모델 가중치가 기술적 잠재력을 보여준다면, 실제 토큰 전달 비용을 결정하는 것은 추론 스케줄링 인프라입니다. 어센드 950과 SM100이 매일 155조 개의 토큰을 함께 처리하는 오늘날, 단일 카드의 최고 성능 경쟁은 더 이상 유일한 기준이 아닙니다. 시스템 차원의 풀스택 조율과 철저한 엔지니어링 완성도야말로 대규모 인공지능 산업화를 떠받치는 진정한 토대입니다.
참고 링크:
- DeepInfer 공식 코드 저장소 및 아키텍처 문서
- deepseek-recipe 프로토콜 파싱 및 포맷팅 라이브러리
- DSpark 추측 디코딩 논문 (arXiv:2607.05147)
- 해커 뉴스(Hacker News) 커뮤니티 기술 토론