155 billones de tokens diarios muestran la realidad a escala industrial
El 20 de octubre de 2026, DeepSeek publicó oficialmente bajo código abierto su framework de inferencia para producción, DeepInfer, junto con la librería de análisis de protocolos deepseek-recipe y una reveladora serie de métricas operativas. Con un procesamiento medio de 155 billones de tokens diarios por clúster y una facturación contable bruta de 38 dólares por hora de GPU, esta entrega expone el rendimiento real exigido en infraestructuras de hiperescala.
La cifra de 38 dólares por hora y acelerador refleja la facturación bruta total del clúster a precios de catálogo fuera de horas punta, no el beneficio neto. En una configuración con proporción 1:1 entre nodos de prefill y decode, el ingreso teórico por tarjeta se sitúa en torno a los 36,7 dólares por hora, desviándose apenas un 3 % respecto a los datos publicados. Mantener una desviación tan reducida en clústeres masivos demuestra que la orquestación del tráfico online ha alcanzado una madurez industrial solvente.
La lista de hardware compatible delimita las fronteras del proyecto. La versión inicial admite exclusivamente dos aceleradores de gama alta: NVIDIA SM100 y Huawei Ascend 950, dejando fuera las GPU de consumo. El entorno de compilación exige Linux, GCC 13.0 y Python 3.12, interactuando directamente a bajo nivel con CUDA 13 y CANN 9.2. Su arquitectura está orientada sin concesiones a la alta concurrencia en centros de datos masivos, prescindiendo de la portabilidad ligera.
Un 96 % de aciertos en caché impulsa una brecha de rendimiento de 25x
La tasa de aciertos en la caché de prefijos (prefix cache) es la palanca tecnológica que marca distancias generacionales en el rendimiento. Los datos técnicos oficiales reflejan que, en un arranque en frío sin caché, el rendimiento de prefill de una SM100 aislada es de 60.000 tokens por segundo. Sin embargo, cuando se produce un acierto en caché, el rendimiento por tarjeta escala instantáneamente a 1,5 millones de tokens por segundo. Esta diferencia de 25 veces evidencia cómo el recalcular prefijos redundantes mermaba gravemente la capacidad de cómputo efectiva.
En el entorno de producción, la longitud media de entrada alcanza los 77.000 tokens. La latencia global hasta el primer token (TTFT) promedia 400 milisegundos, con un percentil 99 (P99) contenido por debajo de los 1.000 ms. Para permitir la reutilización en sesiones largas, el sistema despliega un clúster de almacenamiento distribuido e independiente para KVCache con una retención de 72 horas. Sin la gestión del ciclo de vida que proporciona este almacenamiento externo, una tasa de aciertos del 96 % jamás se traduciría en una ventaja de rendimiento sostenida en producción.
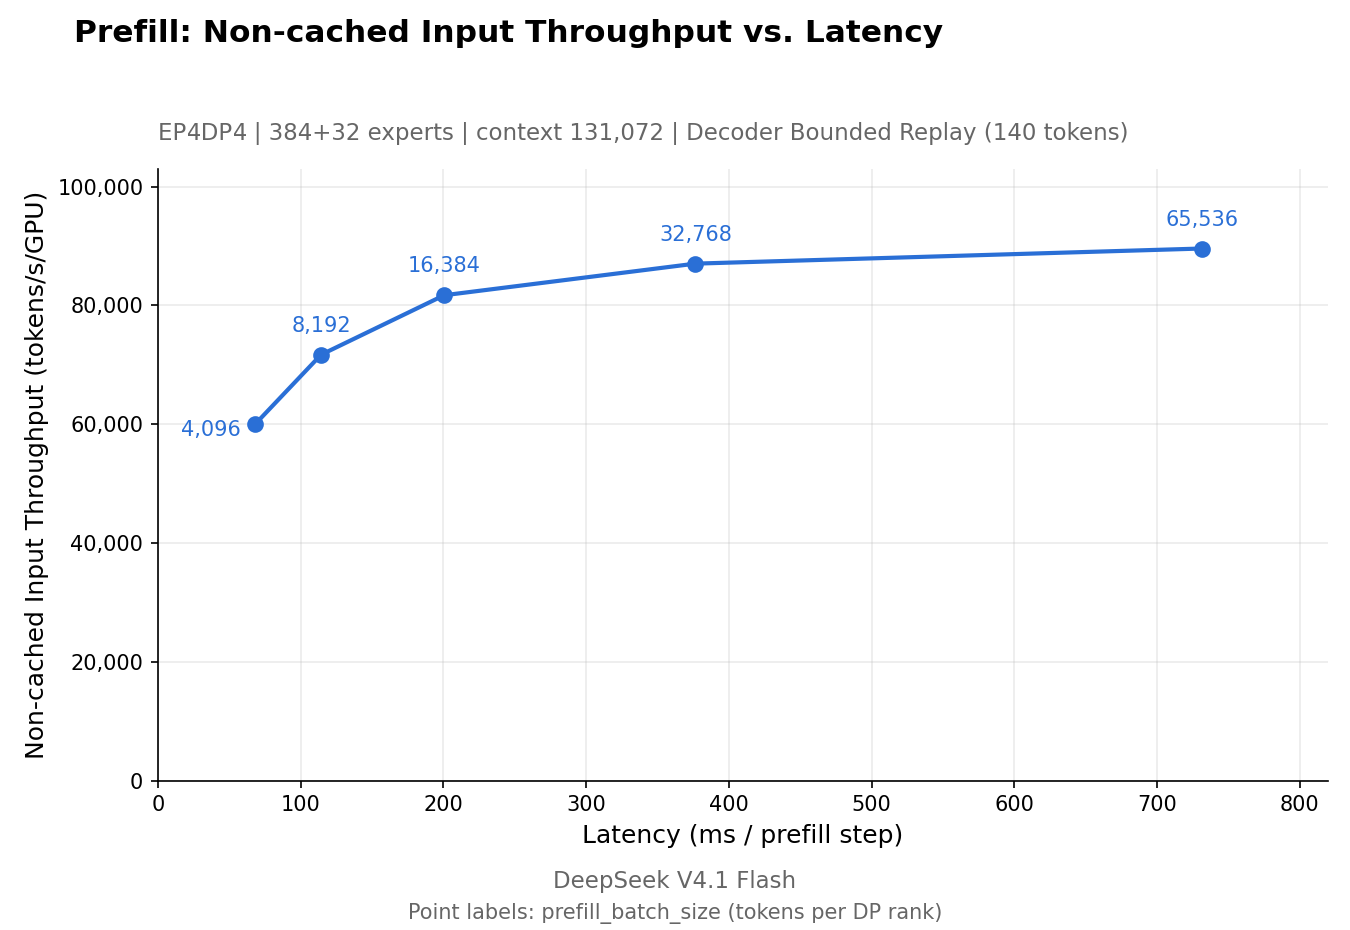 Figura: Curva oficial de Pareto para Prefill en DeepInfer (rendimiento frente a latencia), evaluada en un nodo de 4x SM100. Obsérvese el fuerte aumento del rendimiento en aciertos de caché a medida que sube la concurrencia, mientras la latencia inicial se mantiene notablemente plana. Fuente: deepseek-ai/DeepInfer
La tasa de aciertos en caché reconfigura la curva de costes de inferencia. En las tarifas oficiales de DeepSeek, la entrada con acierto en caché cuesta 0,02 yuanes por millón de tokens, frente a 1,00 yuan cuando no hay coincidencia. Si la tasa de acierto cae del 96 % al 80 %, el coste medio efectivo de entrada salta de 0,06 a 0,22 yuanes por millón. La reutilización de caché es el control primordial para moderar los gastos reales, dejando la potencia teórica en un plano secundario.
Ascend 950 y SM100 entran como plataformas de primer nivel
El chip Ascend 950 de Huawei goza de soporte nativo de primer orden en el código fuente de DeepInfer. A los desarrolladores les basta con definir export DEEPINFER_ACCELERATOR=ascend para compilar contra CANN 9.2. Con ello, los procesadores de diseño chino abandonan las adaptaciones comunitarias externas y se integran formalmente en el árbol principal del proyecto.
Este hito es el resultado de un prolongado trabajo a bajo nivel en toda la pila tecnológica. Con anterioridad, DeepSeek había liberado el operador de atención FlashMLA, la librería de comunicación DeepEP y la librería matricial DeepGEMM. La variante de DeepGEMM para Ascend alcanza un 99,8 % de aprovechamiento del límite físico del hardware en multiplicaciones densas sobre el Ascend 950DT. Sumado a los pesos abiertos del modelo, los operadores base, la comunicación y el framework superior quedan totalmente alineados.
Un único framework unifica la gestión operativa entre hardware heterogéneo. Ante la misma carga de trabajo, Ascend 950 y SM100 operan bajo la misma lógica de flujo. Que procesadores chinos asuman tareas troncales en sistemas con una demanda superior a 150 billones de tokens diarios evidencia que este ecosistema técnico ha cruzado el umbral que separa la viabilidad teórica de la implantación industrial real.
Cuatro optimizaciones eliminan la sobrecarga en secuencias largas y lotes
La fase de decodificación autoregresiva debe equilibrar el rendimiento global del clúster con la velocidad de respuesta individual. En un dominio de 64 aceleradores SM100, DeepInfer mantiene un rendimiento de decodificación de 14.000 tokens por segundo y tarjeta, sosteniendo una tasa de 230 tps por usuario. La proporción física entre nodos de prefill y decode se conserva en 1:1, desafiando la costumbre en la industria de asignar varias máquinas de decodificación por cada máquina de prefill.
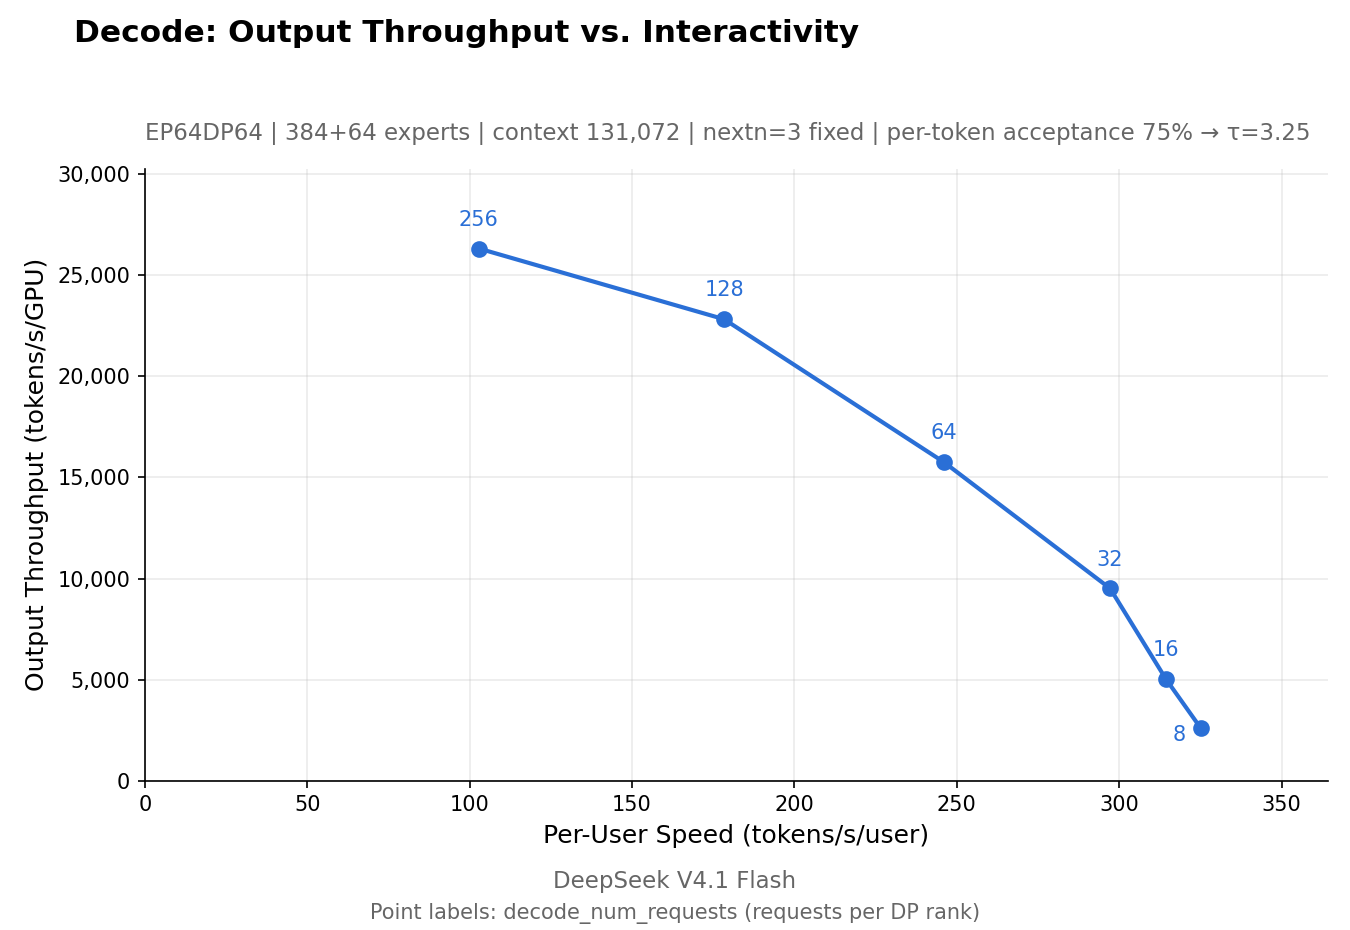 Figura: Curva oficial de Pareto para Decode en DeepInfer, probada en un dominio de 64x SM100. Destaca la estabilidad en la tasa de emisión de tokens bajo alta concurrencia por lotes, equilibrando el volumen total y la latencia individual. Fuente: deepseek-ai/DeepInfer
El coste de recomputación en secuencias extensas se solventa mediante una ventana deslizante con repetición acotada (bounded replay). Los esquemas habituales suelen exigir recalcular todo el historial cuando se superan los márgenes. DeepInfer restringe la repetición a un sufijo delimitado de 140 tokens. Sin importar cuánto crezca la longitud del contexto, el coste de reconstrucción temporal converge siempre en un valor constante predecible.
La decodificación especulativa aprovecha el módulo de borradores paralelos DSpark y una planificación dinámica basada en confianza. El algoritmo modula la longitud de verificación en función de la saturación del motor. Frente a la referencia MTP-1, esta arquitectura logra una aceleración de entre el 60 % y el 85 % por usuario a igualdad de rendimiento, sumando un incremento del 6 % al volumen total del clúster.
El planificador asíncrono solapa la orquestación en CPU con el cálculo en GPU, eliminando los periodos muertos entre lotes. En la plataforma NVIDIA, activar el parámetro de invarianza de lote asegura respuestas deterministas. Paralelamente, la librería complementaria deepseek-recipe unifica el tratamiento de peticiones API y se encarga del ensamblado y validación de prompts estructurados.
La apertura del motor delimita las fronteras del entorno productivo
El alcance de esta liberación bajo código abierto establece una clara demarcación técnica. El lanzamiento se concentra en el motor central para inferencia offline y la escalabilidad en nodo único, mientras que los componentes de servicio a gran escala permanecen en el ámbito interno de DeepSeek. Ni el almacenamiento distribuido KVCache para 72 horas ni los balanceadores globales entre réplicas forman parte del repositorio público.
Esta diferenciación marca la distancia real entre una infraestructura autogestionada y el servicio en la nube gestionado. Los equipos de ingeniería pueden aprovechar la optimización de kernels y la gestión de lotes para reproducir excelentes perfiles de rendimiento en entornos locales. Sin embargo, para operar un servicio en la nube con alta disponibilidad, el soporte de gestión de grandes clústeres continúa siendo un requisito indispensable.
La guerra de precios en los grandes modelos de lenguaje se libra hoy en la ingeniería de inferencia a bajo nivel. Los pesos del modelo definen el techo de capacidad teórica, pero la pila de orquestación determina el coste real de cada token emitido. Con Ascend 950 y SM100 soportando conjuntamente 155 billones de tokens diarios, la cifra bruta de FLOPS pasa a segundo plano. El diseño integral del sistema y la optimización de procesos en producción son los pilares fundamentales para el despliegue industrial de la IA.
Enlaces de referencia:
- Repositorio oficial y documentación de arquitectura de DeepInfer
- deepseek-recipe: librería de análisis de protocolos y formateo
- Artículo técnico del algoritmo de muestreo especulativo DSpark (arXiv:2607.05147)
- Debate técnico en la comunidad de Hacker News