日量 155 兆トークンの処理実績が示す産業規模の現実
2026 年 10 月 20 日、DeepSeek は本番推論フレームワーク「DeepInfer」を公式にオープンソース化しました。プロトコル解析ライブラリ deepseek-recipe と運用テレメトリデータも同時に公開されています。単一クラスタで日量平均 155 兆トークンを処理し、アクセラレータ 1 枚あたり 1 時間で 38 ドルの名目売上を記録。大規模本番環境における真のスループット水準を明示する発表となりました。
このカード時間あたり 38 ドルという数値は、閑散期定価に基づくクラスタ全体の売上換算であり、純利益ではありません。Prefill と Decode のマシン比率を 1:1 に設定した場合、1 カードあたりの理論売上は約 36.7 ドルとなり、公表値との誤差はわずか 3% です。超大規模クラスタにおいてこれほど低い乖離度で運用を維持できることは、オンラインのトラフィック平準化技術が産業レベルに成熟していることを実証しています。
対応ハードウェアの仕様は、フレームワークの技術的境界線を明確に物語っています。初期リリースでサポートされるのは NVIDIA SM100 と Huawei Ascend 950 の 2 種のハイエンドアクセラレータのみであり、コンシューマー向け GPU は対象外とされました。ビルド環境には Linux、GCC 13.0、Python 3.12 が求められ、バックエンドはそれぞれ CUDA 13 と CANN 9.2 に直結しています。データセンターの高密度並列処理に特化したアーキテクチャ設計であり、軽量な互換性は割り切られています。
96% のキャッシュヒット率が支える 25 倍の性能差
プレフィックスキャッシュのヒット率は、推論性能の世代差を分ける最重要要素です。公式リリースによると、キャッシュなしのコールドスタート時における SM100 単体の Prefill スループットは毎秒 6 万トークンにとどまります。しかし、プレフィックスキャッシュにヒットした瞬間、カード単体の処理能力は毎秒 150 万トークンへと跳ね上がります。この 25 倍に達する性能差は、プレフィックスの重複計算が実効計算リソースをいかに圧迫していたかを示しています。
本番環境の平均コンテキスト長は 7.7 万トークンに達します。初回トークン生成遅延(TTFT)は平均 400 ミリ秒、P99 でも 1,000 ミリ秒以下に抑えられています。長時間のセッション再利用を実現するため、システムは 72 時間保持可能な独立した分散 KVCache ストレージクラスタを構築しました。独立した外部ストレージクラスタによるライフサイクル管理がなければ、96% のキャッシュヒット率を本番環境の持続的なスループット向上に結びつけることは不可能です。
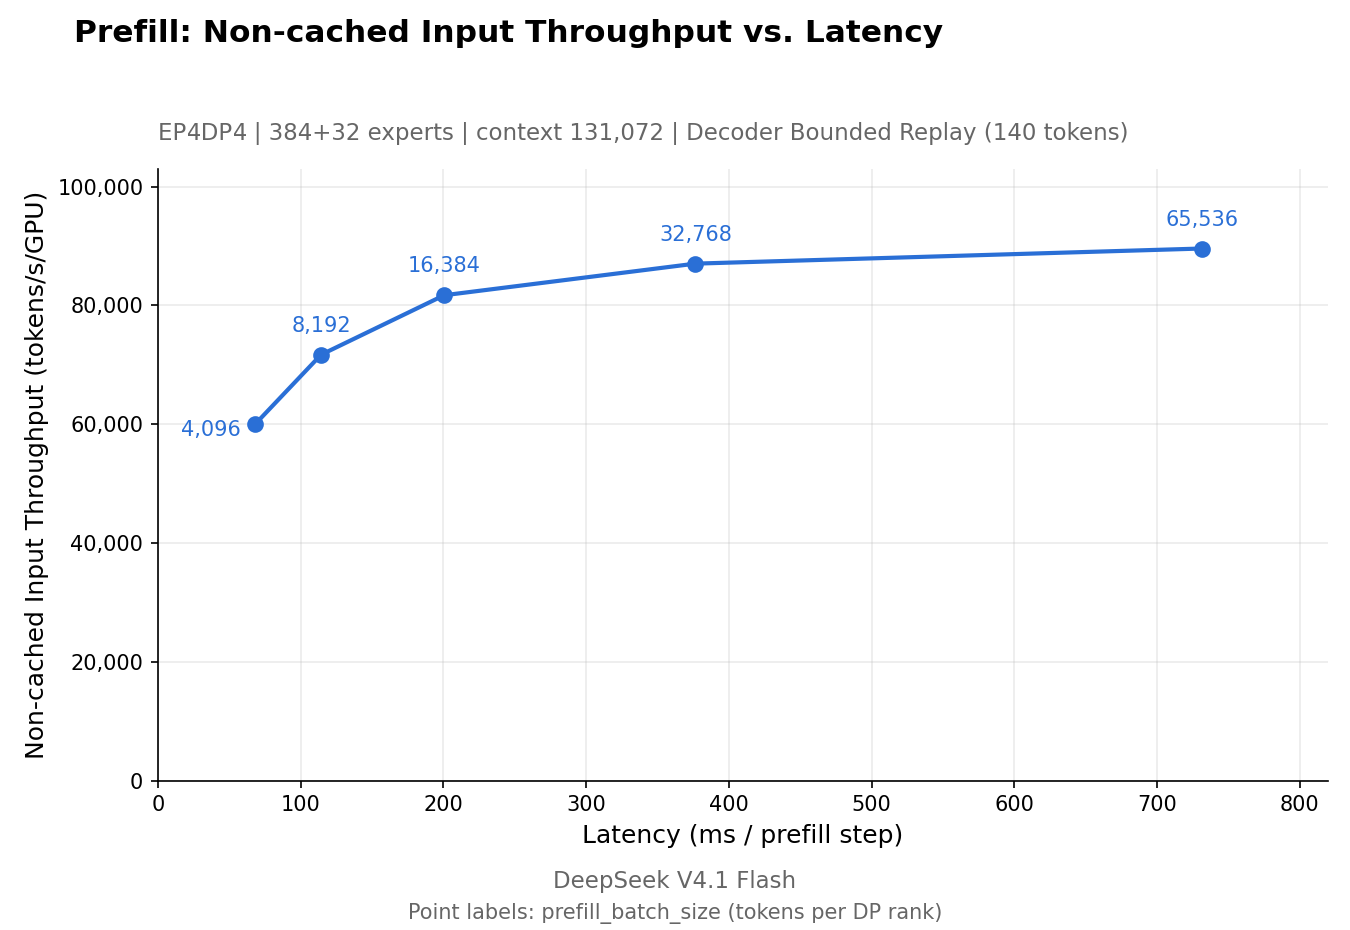 図:DeepInfer 公式 Prefill Pareto 曲線(スループット vs レイテンシ)、4 基の SM100 ノードで測定。キャッシュヒット状態において並列数の増加に伴いスループットが急激に上昇しつつ、TTFT が低位安定している点に注目。出典:deepseek-ai/DeepInfer
キャッシュヒット率は推論コストの構造を根本から変革します。公式価格体系では、入力キャッシュヒット時の単価は 100 万トークンあたり 0.02 元、未ヒット時は 1.00 元と設定されています。ヒット率が 96% から 80% に低下するだけで、実効入力単価は 0.06 元から 0.22 元へと 3 倍以上に跳ね上がります。キャッシュ再利用率こそが運用コストを制御する決定打であり、理論上のピーク演算性能は副次的な指標にすぎません。
昇騰 950 と SM100 が並列で一次サポートへ
Huawei Ascend 950 は、ソースコードレベルでファーストクラスのサポートを受けました。開発者は export DEEPINFER_ACCELERATOR=ascend を指定するだけでビルドを完結でき、CANN 9.2 に直接リンクされます。中国国産 AI チップは、コミュニティ主導の外付け移植という従属的立場を脱し、公式ネイティブサポートの段階へと進みました。
この成果は、長期間にわたるフルスタックの基盤開発に支えられています。DeepSeek はこれまでに、FlashMLA アテンションカーネル、DeepEP 通信ライブラリ、DeepGEMM 行列演算ライブラリを相次いでオープンソース化してきました。Ascend 950DT 上に最適化された DeepGEMM は、高密度行列乗算においてハードウェア限界の 99.8% という利用率を叩き出しています。公開モデルの重みと合わさり、低レベルカーネル、分散通信、最上位フレームワークに至る全レイヤーが一本に結実しました。
統一フレームワークの登場により、異種ハードウェア間における運用の差異は平準化されました。同一のモデル負荷に対して、Ascend 950 と SM100 は完全に同一のパイプラインロジックで動作します。中国国産チップが日量 150 兆トークンを超える本番フレームワークで主力を担える事実は、ハード・ソフト両面の開発環境が「機能検証」から「産業実装」への移行を果たしたことを証明しています。
4 つのエンジニアリング刷新が長文列とバッチ処理の損失を排除
デコードフェーズでは、システム全体のスループットと単一リクエストの出力速度の双立が求められます。64 基の SM100 で構成される単一ドメインにおいて、Decode スループットはカードあたり毎秒 1.4 万トークン、単一ユーザー向け出力速度は 230 tps を維持しています。Prefill ノードと Decode ノードの物理比率は 1:1 に保たれており、生成ノードを大量配置する従来の慣行を打ち破りました。
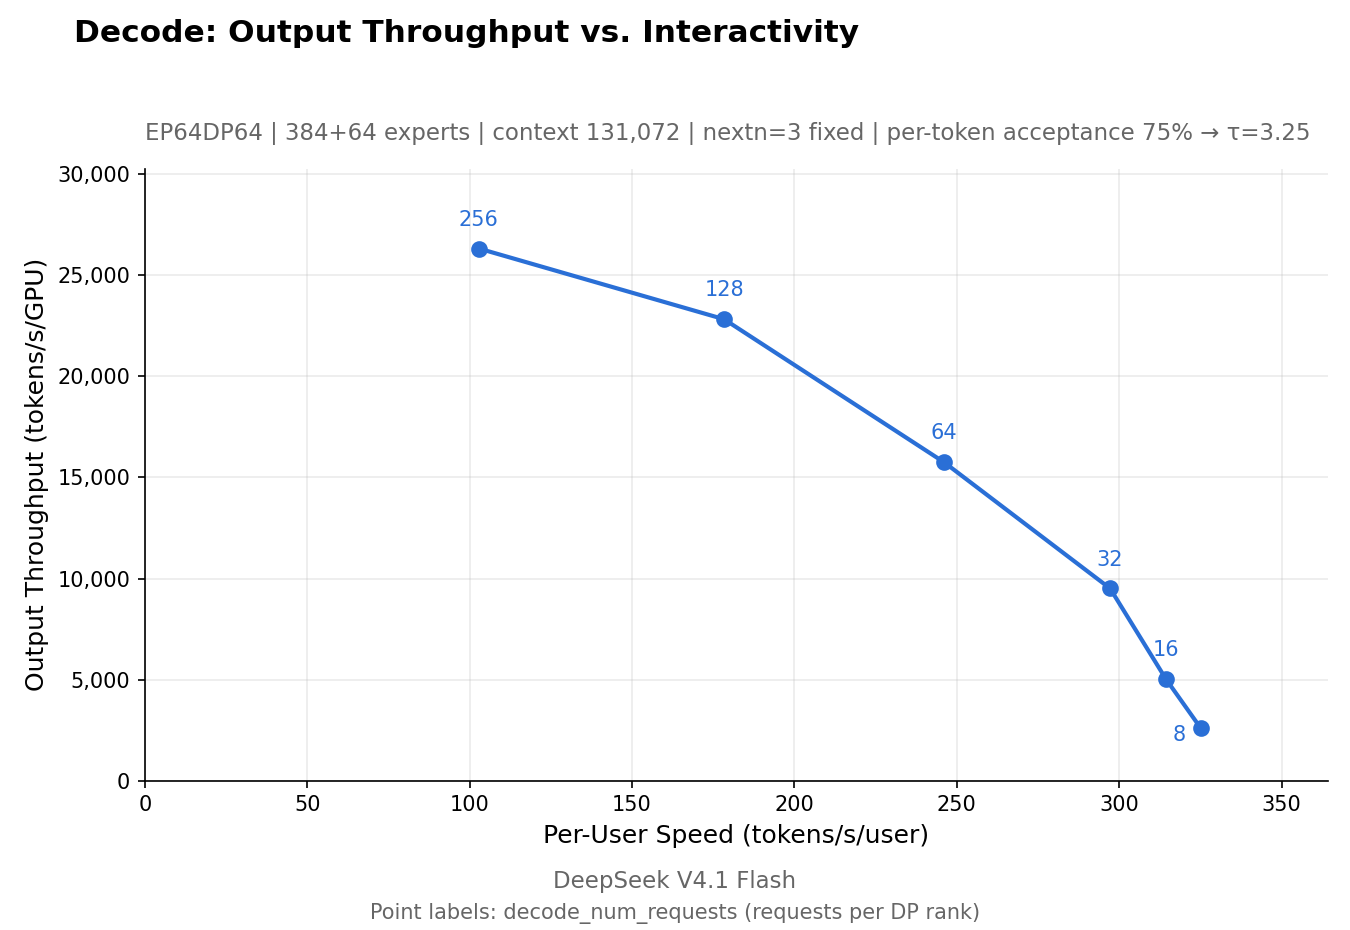 図:DeepInfer 公式 Decode Pareto 曲線、64 基の SM100 ノードで測定。高並列バッチ処理下でも出力速度が低下せず、全体スループットと単一ユーザーの応答レイテンシが高度に両立されています。出典:deepseek-ai/DeepInfer
長文列の再計算オーバーヘッドは、スライディングウィンドウの有界リプレイ機構によって解消されました。従来のスライディングウィンドウは境界超過時に過去の全文脈を再計算する必要がありました。DeepInfer はリプレイ範囲を 140 トークンの有界サフィックス内に制限します。シーケンス長がどれほど伸長しても、過去文脈の再計算コストは常に一定の定数オーダーに収束します。
投機的デコードは、DSpark 並列ドラフトモジュールと動的信頼度スケジューリングの連携によって高速化されています。エンジンの負荷状況に応じて検証長を動的に決定する設計により、同一スループット比較で MTP-1 ベースライン比 60%〜85% の単一ユーザー生成加速を達成し、クラスタ全体のスループットを 6% 押し上げました。
非同期スケジューラは CPU のオーケストレーションと GPU の実行をオーバーラップさせ、バッチ処理の隙間(バブル)を解消しています。NVIDIA プラットフォームではバッチ不変性パラメータを有効にすることで決定論的な出力を保証します。付随する deepseek-recipe ライブラリは多様な API リクエスト形式を統一し、プロンプトの組み立てと構造化検証を担います。
オープンソース化が描く本番クラスタ運用の境界線
フレームワークの公開範囲には、明確な設計上の境界が引かれています。今回のオープンソース化はオフライン推論および単一ノード規模のコアエンジンに集中しており、超大規模オンライン運用コンポーネントは内部に留め置かれました。独立した 72 時間分散 KVCache ストレージや複数レプリカ間のグローバルロードバランサはコードベースに含まれていません。
この切り分けは、自社構築環境と公式クラウドサービスの差異を明示しています。開発者はカーネルの最適化やバッチスケジューリングの知見をそのまま取り入れ、ローカル環境で優れた性能曲線を再現できます。しかし、高可用性を備えたパブリッククラウドサービスを支えるには、超大規模クラスタ特有の運用基盤が依然として不可欠です。
LLM の価格競争は、すでに低レベルの推論エンジニアリングの領域へと移行しました。モデルの重みは能力の上限を示すにすぎず、トークン提供の真のコストを決定するのはスケジューリング層です。Ascend 950 と SM100 が日量 155 兆トークンという過酷な負荷を支える中、単体カードの理論性能競争は過去のものとなりました。フルスタックのシステム連携と徹底した現場実装こそが、産業規模の AI 展開を支える真の基盤です。
参考リンク:
- DeepInfer 公式リポジトリおよびアーキテクチャ解説
- deepseek-recipe プロトコル解析・フォーマットライブラリ
- DSpark 投機的サンプリング論文(arXiv:2607.05147)
- Hacker News コミュニティ技術ディスカッション