155 000 milliards de tokens par jour : la réalité de l’échelle industrielle
Le 20 octobre 2026, DeepSeek a officiellement rendu open source son infrastructure d’inférence en production, DeepInfer, accompagnée de la bibliothèque de gestion de protocoles deepseek-recipe et d’un ensemble inédit de données d’exploitation. Traitant en moyenne 155 000 milliards de tokens par jour et par cluster, tout en générant un chiffre d’affaires théorique de 38 dollars par heure et par accélérateur, cette annonce offre un aperçu direct du débit requis au sein d’environnements de production à très grande échelle.
Ce montant de 38 dollars par heure de calcul repose sur les tarifs publics en heures creuses et illustre le volume brut généré par le cluster, et non son bénéfice net. Avec un ratio physique de 1:1 entre machines dédiées au prefill et au décodage, le chiffre d’affaires théorique par carte tourne autour de 36,70 dollars par heure, soit un écart de seulement 3 % par rapport aux indicateurs annoncés. Parvenir à maintenir un cluster d’une telle envergure avec une variance aussi infime prouve que la régulation du trafic en ligne a franchi un cap d’industrialisation décisif.
La liste du matériel compatible pose des limites architecturales très nettes. La version initiale ne prend en charge que deux accélérateurs haut de gamme : le NVIDIA SM100 et le Huawei Ascend 950, écartant d’emblée les GPU grand public. L’environnement d’exécution impose Linux, GCC 13.0 et Python 3.12, tout en communiquant directement au plus bas niveau avec CUDA 13 et CANN 9.2. L’architecture a été conçue sur mesure pour la très forte concurrence des grands centres de calcul, faisant délibérément l’impasse sur la portabilité légère.
96 % de succès de cache pour un gain d’efficacité de 25x
Le taux de réussite du cache de préfixes (prefix cache) constitue le levier technique fondamental séparant l’inférence ordinaire des standards de pointe. Les métriques officielles indiquent qu’en démarrage à froid sans cache, le débit de prefill d’une carte SM100 s’établit à 60 000 tokens par seconde. Dès lors que le préfixe est trouvé en cache, le débit unitaire s’envole instantanément à 1,5 million de tokens par seconde. Cet écart d’un facteur 25 démontre à quel point le recalcul redondant des contextes entamait les ressources de calcul utiles.
En environnement réel, la longueur moyenne des contextes en entrée atteint 77 000 tokens. Le délai d’émission du premier token (Time-to-First-Token, TTFT) s’établit en moyenne à 400 millisecondes, avec un 99e percentile (P99) maintenu sous la barre des 1 000 ms. Afin d’assurer la réutilisation des sessions longues, l’équipe a déployé un cluster de stockage distribué dédié à la KVCache, doté d’une politique de rétention de 72 heures. Sans la gestion du cycle de vie assurée par cette couche de stockage externe, un taux de cache de 96 % n’aurait jamais pu se convertir en un gain pérenne de débit en production.
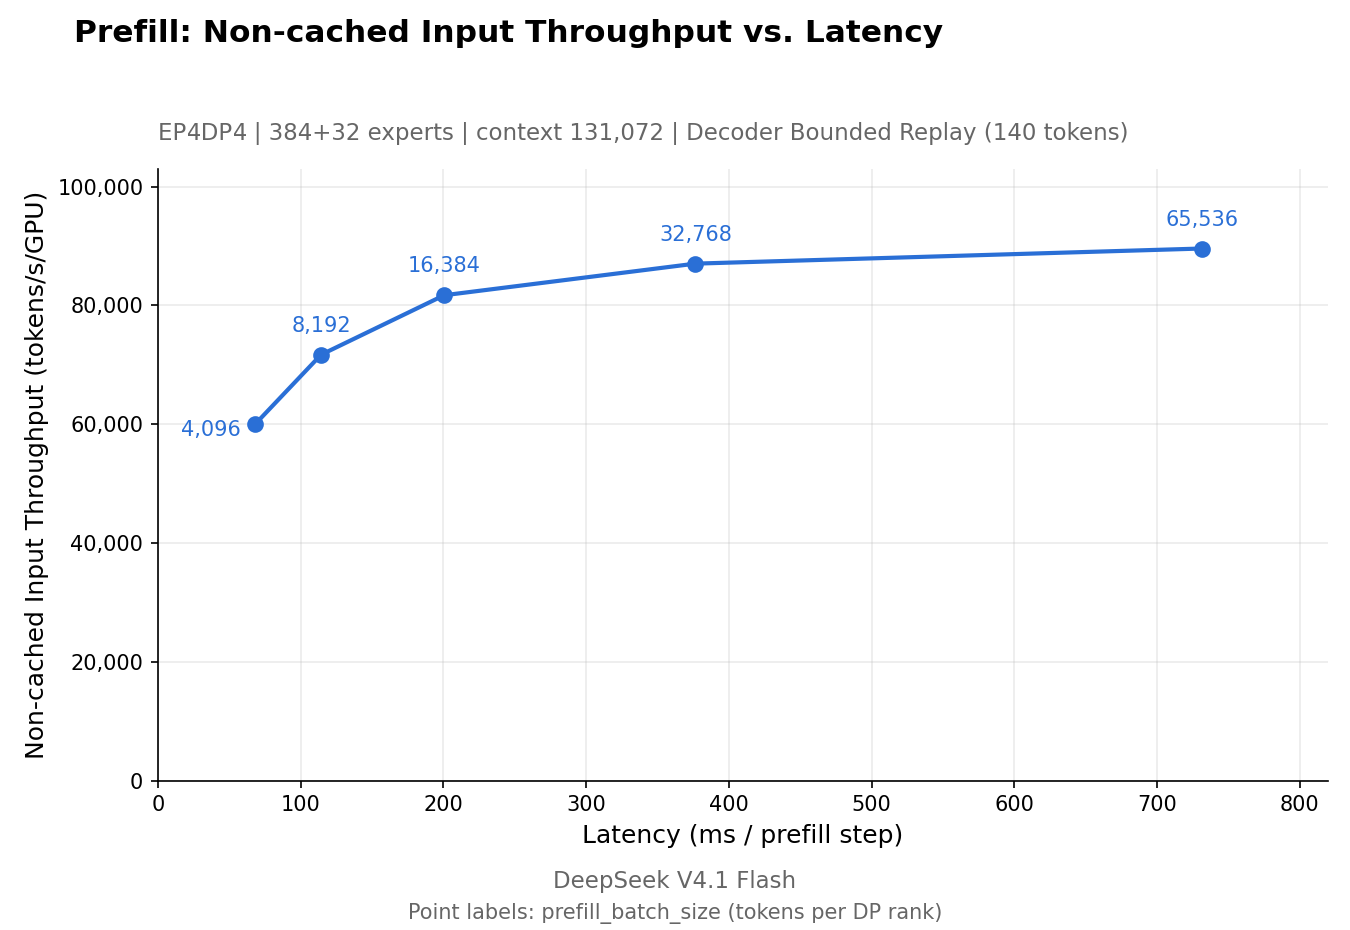 Figure : Courbe de Pareto officielle pour le Prefill dans DeepInfer (débit vs latence), mesurée sur un nœud de 4x SM100. On observe une envolée du débit lors des succès de cache à mesure que la concurrence augmente, tandis que la latence initiale reste remarquablement stable. Source : deepseek-ai/DeepInfer
Ce taux de succès redéfinit entièrement la structure des coûts d’inférence. Dans la grille tarifaire de DeepSeek, l’entrée en cache est facturée 0,02 yuan par million de tokens, contre 1,00 yuan en cas d’échec. Si ce taux venait à fléchir de 96 % à 80 %, le coût moyen effectif par million de tokens quadruplerait presque, passant de 0,06 à 0,22 yuan. L’efficacité du réemploi du cache s’affirme donc comme le principal levier de maîtrise budgétaire, reléguant la puissance brute théorique au second plan.
Ascend 950 et SM100 intégrés comme plateformes de premier rang
Le processeur Ascend 950 de Huawei est pris en charge nativement au sein même du code source. Il suffit aux équipes d’indiquer export DEEPINFER_ACCELERATOR=ascend pour compiler la solution directement au-dessus de CANN 9.2. Les semi-conducteurs chinois s’émancipent ainsi des adaptations tierces issues de la communauté pour s’ancrer dans le support amont officiel.
Cette avancée couronne un travail d’ingénierie bas niveau de longue haleine. DeepSeek avait déjà rendu publics l’opérateur d’attention FlashMLA, la bibliothèque de communication collective DeepEP et la suite de calcul matriciel DeepGEMM. Dans sa version optimisée pour l’Ascend 950DT, DeepGEMM parvient à mobiliser 99,8 % de la limite physique du composant lors de multiplications matricielles denses. Associés aux poids ouverts des modèles, les noyaux matériels, la communication et le framework supérieur composent désormais une chaîne entièrement décloisonnée.
Un moteur unifié homogénéise l’expérience d’exploitation sur des architectures hétérogènes. Face à une charge de travail identique, l’Ascend 950 et le SM100 partagent la même logique de pipeline. Voir des puces chinoises assurer un rôle de premier plan au cœur d’un dispositif traitant plus de 150 000 milliards de tokens par jour atteste que cet écosystème matériel et logiciel a franchi le cap décisif de la validation industrielle.
Quatre innovations architecturales pour supprimer les surcoûts de contexte et de batch
La phase de décodage autorégressif impose de concilier volume global et rapidité de restitution par requête. Au sein d’un domaine de 64 cartes SM100, DeepInfer maintient un débit de décodage de 14 000 tokens par seconde et par carte, tout en garantissant une cadence de 230 tps par utilisateur. L’équilibre physique entre nœuds de prefill et de decode demeure fixé à 1:1, bousculant les usages établis qui mobilisaient traditionnellement plusieurs serveurs de décodage pour chaque serveur de préremplissage.
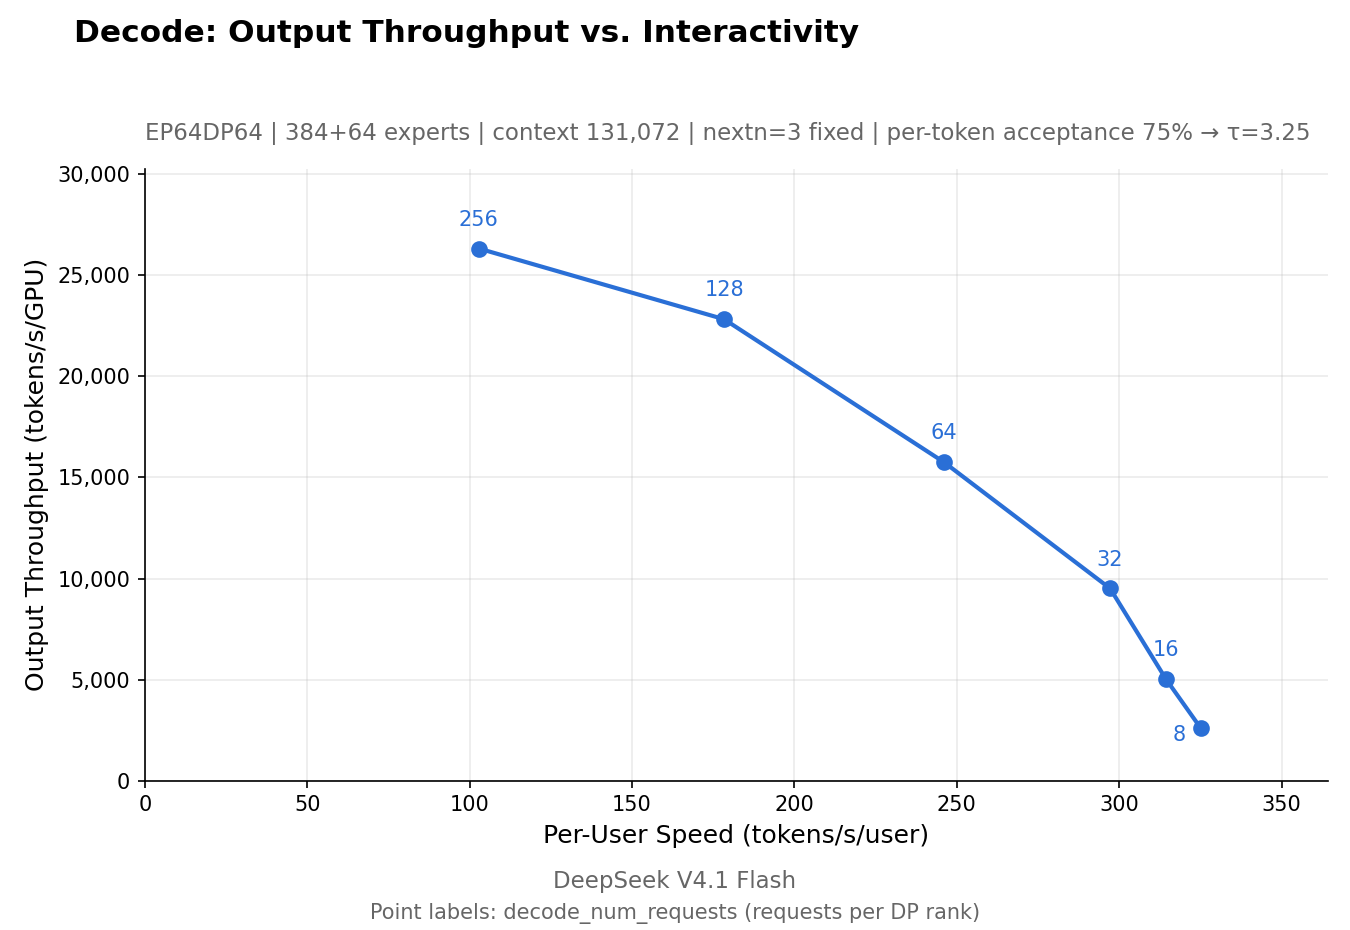 Figure : Courbe de Pareto officielle pour le Decode dans DeepInfer, évaluée sur un domaine de 64x SM100. La courbe illustre la régularité de la cadence d’émission sous forte charge par lots, préservant à la fois le débit global et le temps de réponse unitaire. Source : deepseek-ai/DeepInfer
Les surcoûts liés au recalcul des contextes étendus ont été neutralisés grâce à une fenêtre glissante à rejeu borné (bounded replay). Les architectures classiques imposent généralement de recalculer l’historique complet dès que la limite est franchie. DeepInfer borne strictement ce rejeu à un suffixe fixe de 140 tokens. Quelle que soit l’ampleur de la séquence, le coût de réévaluation du contexte reste confiné dans une complexité constante.
Le décodage spéculatif tire parti du module de brouillons parallèles DSpark associé à un ordonnancement dynamique fondé sur des seuils de confiance. Le moteur adapte la profondeur de vérification selon la charge instantanée du système. À débit constant, cette conception procure un gain de vitesse de génération par utilisateur de 60 % à 85 % par rapport à la référence MTP-1, tout en apportant 6 % de débit supplémentaire au cluster.
L’ordonnanceur asynchrone fait se chevaucher la coordination CPU et le traitement GPU, éliminant les temps morts lors des traitements par lots. Sur l’architecture NVIDIA, le paramètre d’invariance par lot garantit des réponses déterministes. En complément, la bibliothèque deepseek-recipe unifie les formats des requêtes API, se chargeant de la validation structurée et de la préparation des invites.
L’ouverture du moteur délimite les frontières de l’exploitation en production
Le périmètre de cette publication open source trace une ligne de démarcation architecturale très claire. Cette version se concentre sur le moteur d’inférence hors ligne et l’optimisation à l’échelle du nœud unique. L’infrastructure de service cloud à grande échelle de DeepSeek demeure propriétaire : ni le système de stockage distribué KVCache sur 72 heures ni les répartiteurs de charge entre réplicas ne figurent dans le code partagé.
Ce partage clarifie la frontière entre infrastructure d’entreprise sur site et plateformes managées à très grande échelle. Les équipes d’ingénierie peuvent intégrer les optimisations de bas niveau et les ordonnanceurs de batchs pour reproduire des courbes de performance remarquables en local. Néanmoins, pour exploiter un service cloud résilient à haute disponibilité, les outils d’orchestration de clusters géants restent incontournables.
La guerre des prix autour des modèles d’IA se dispute désormais sur le terrain de l’ingénierie d’inférence de bas niveau. Les poids du modèle ne font qu’esquisser un potentiel ; c’est la pile d’exécution qui dicte le coût réel de chaque token livré. Avec l’Ascend 950 et le SM100 capables d’encaisser de concert 155 000 milliards de tokens par jour, les chiffres bruts de puissance de calcul s’effacent. L’intégration matérielle-logicielle de bout en bout et la rigueur de l’ordonnancement constituent le véritable socle du passage de l’IA à l’échelle industrielle.
Liens de référence :
- Dépôt officiel et documentation d’architecture de DeepInfer
- Bibliothèque d’analyse de protocoles et de formatage deepseek-recipe
- Publication de recherche sur l’échantillonnage spéculatif DSpark (arXiv:2607.05147)
- Discussion technique sur la communauté Hacker News