155 Billionen Tokens täglich offenbaren reale Rechenzentrumsökonomie
Am 20. Oktober 2026 stellte DeepSeek sein produktives Inferenz-Framework DeepInfer offiziell unter eine Open-Source-Lizenz. Zusammen mit der Protokoll-Bibliothek deepseek-recipe wurden umfangreiche Betriebsdaten veröffentlicht: Ein einzelner Cluster verarbeitet im Schnitt 155 Billionen Tokens pro Tag und erzielt einen buchhalterischen Durchsatzumsatz von 38 US-Dollar pro GPU-Stunde. Damit legt das Framework die tatsächlichen Anforderungen an Hochleistungs-Produktionsumgebungen schonungslos offen.
Der Betrag von 38 Dollar pro Beschleunigerstunde basiert auf den Listenpreisen für Nebenzeiten und spiegelt den Bruttoumsatz des Gesamtclusters wider, nicht den Reingewinn. Bei einer 1:1-Aufteilung zwischen Prefill- und Decode-Servern beträgt der theoretische Bruttoumsatz pro Karte etwa 36,70 Dollar – eine Abweichung von lediglich 3 % gegenüber den offiziellen Daten. Dass ein derart gewaltiger Cluster mit so minimalen Abweichungen operiert, belegt die industrielle Reife des Online-Traffic-Schedulings.
Die Hardware-Unterstützung markiert klare technische Grenzen. Die initiale Version unterstützt ausschließlich zwei Spitzen-Beschleuniger: NVIDIA SM100 und Huawei Ascend 950. Consumer-Grafikkarten bleiben vollständig außen vor. Die Build-Umgebung setzt zwingend Linux, GCC 13.0 und Python 3.12 voraus und bindet auf Systemebene direkt an CUDA 13 bzw. CANN 9.2 an. Das gesamte Design ist auf hochdichte Parallelverarbeitung in Hyperscale-Rechenzentren zugeschnitten; auf leichtgewichtige Kompatibilität wurde bewusst verzichtet.
96 % Cache-Hit-Rate schaffen einen 25-fachen Leistungssprung
Die Trefferquote des Prefix-Caches ist der entscheidende Hebel für den Inferenz-Durchsatz. Offizielle Messwerte zeigen: Ohne Cache-Treffer (Cold-Start) erreicht eine einzelne SM100-Karte einen Prefill-Durchsatz von 60.000 Tokens pro Sekunde. Trifft der Prefix-Cache jedoch zu, springt die Verarbeitungsleistung schlagartig auf 1,5 Millionen Tokens pro Sekunde. Dieser 25-fache Unterschied verdeutlicht, wie stark redundante Prefix-Neuberechnungen die effektive Rechenleistung belasten.
Die durchschnittliche Eingabelänge im Produktivbetrieb liegt bei 77.000 Tokens. Die Latenz bis zum ersten Token (Time-to-First-Token, TTFT) beträgt im Schnitt 400 Millisekunden, wobei der P99-Wert unter 1.000 ms bleibt. Um langlebige Multi-Turn-Sitzungen zu unterstützen, nutzt das System einen separaten, verteilten KVCache-Speichercluster mit 72 Stunden Vorhaltezeit. Ohne das Lifecycle-Management eines solchen externen Speicherclusters ließe sich eine Cache-Hit-Rate von 96 % niemals in dauerhafte Durchsatzgewinne ummünzen.
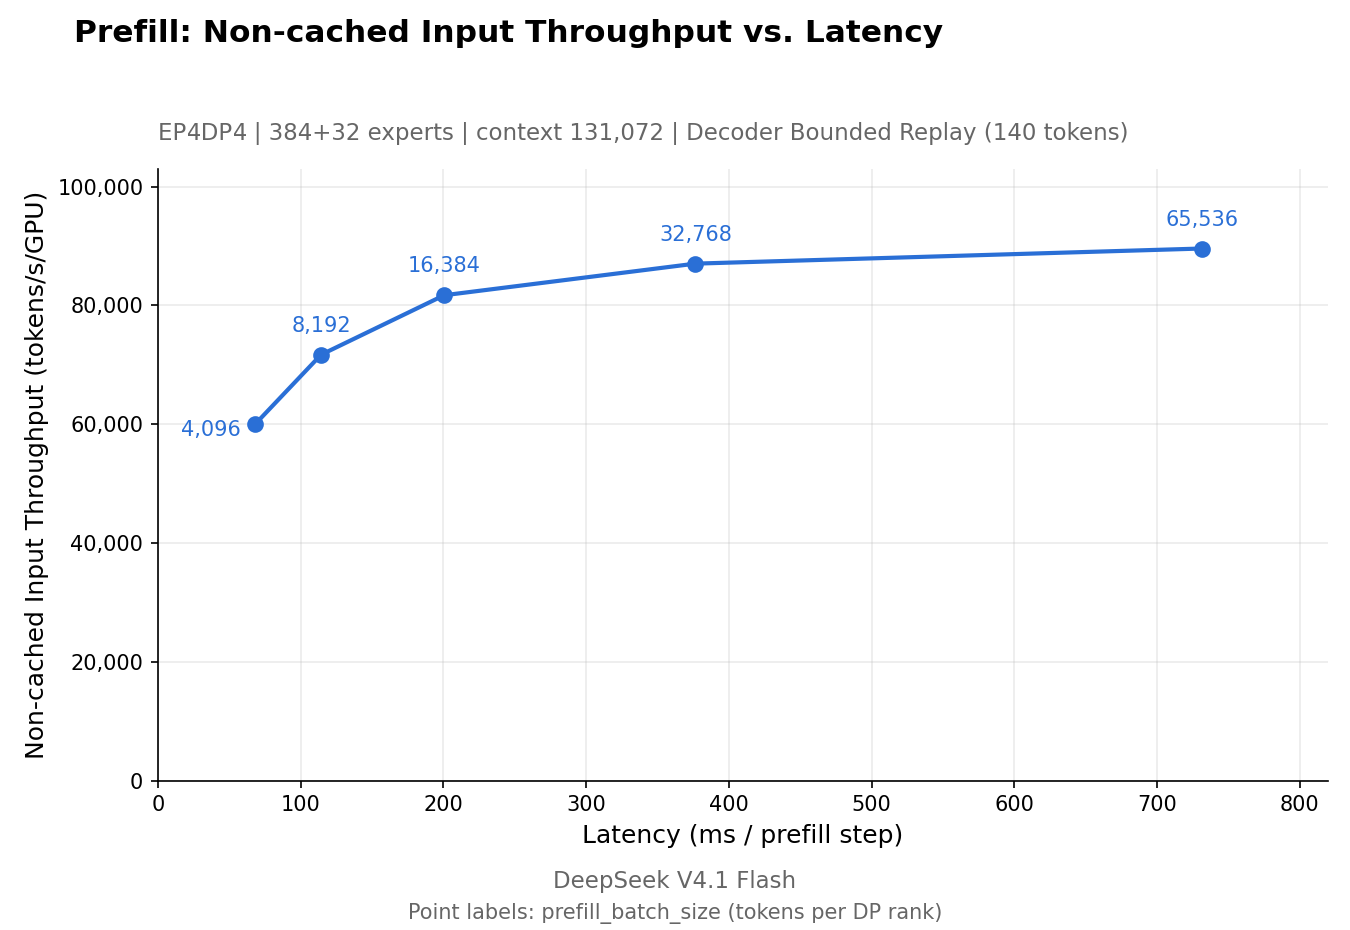 Abb.: Offizielle Prefill-Pareto-Kurve von DeepInfer (Durchsatz vs. Latenz), gemessen auf einem Node mit 4x SM100. Bei Cache-Hits steigt der Durchsatz mit wachsender Parallelität steil an, während die Initiallatenz bemerkenswert stabil bleibt. Quelle: deepseek-ai/DeepInfer
Die Cache-Trefferquote definiert die wirtschaftlichen Kosten der Inferenz neu. In DeepSeeks Preismodell kostet ein gecachter Input-Token 0,02 Yuan pro Million Tokens, während ungecachte Eingaben mit 1,00 Yuan berechnet werden. Fällt die Trefferquote von 96 % auf 80 %, steigt der effektive Mischpreis für Eingaben von 0,06 auf 0,22 Yuan pro Million Tokens – fast das Vierfache. Die Wiederverwendungsrate des Caches ist die maßgebliche Stellschraube für Betriebskosten; theoretische Rechenspitzen sind zweitrangig.
Ascend 950 und SM100 als First-Class-Plattformen gleichgestellt
Huaweis Ascend 950 erhält im Quellcode von DeepInfer eine gleichrangige native Unterstützung. Entwickler müssen lediglich export DEEPINFER_ACCELERATOR=ascend setzen, um die Software direkt gegen CANN 9.2 zu kompilieren. Damit verlässt die chinesische Hardware-Plattform das Stadium inoffizieller Community-Ports und wird von Tag eins an upstream unterstützt.
Dieser Durchbruch fußt auf jahrelanger systemnaher Entwicklungsarbeit. Zuvor hatte DeepSeek bereits grundlegende Komponenten wie den Attention-Kernel FlashMLA, die Kommunikationsbibliothek DeepEP und die Matrixbibliothek DeepGEMM als Open Source bereitgestellt. Die Ascend-Version von DeepGEMM erzielt auf dem Ascend 950DT eine Hardwareauslastung von 99,8 % bei dichten Matrixmultiplikationen. Im Zusammenspiel mit offenen Modellgewichten bildet dies eine lückenlos optimierte Kette vom Low-Level-Kernel bis zum High-Level-Framework.
Ein vereinheitlichtes Framework nivelliert die betrieblichen Unterschiede zwischen heterogenen Plattformen. Unter identischer Modelllast laufen Ascend 950 und SM100 nach der gleichen Pipeline-Logik. Dass chinesische Hardware eine tragende Rolle bei einem Durchsatz von über hundert Billionen Tokens pro Tag einnehmen kann, signalisiert den Übergang von theoretischer Machbarkeit zu verlässlicher industrieller Praxis.
Vier Architektur-Optimierungen eliminieren Overheads bei langen Sequenzen und Batches
In der autoregressiven Decoding-Phase müssen Gesamtdurchsatz und individuelle Ausgabegeschwindigkeit gleichzeitig stimmen. In einer Domäne mit 64 SM100-Beschleunigern erzielt DeepInfer einen Decode-Durchsatz von 14.000 Tokens pro Sekunde und Karte bei einer Ausgabegeschwindigkeit von 230 Tokens pro Sekunde je Nutzer. Das physische Verhältnis zwischen Prefill- und Decode-Servern bleibt exakt bei 1:1 – eine deutliche Abkehr von bisherigen Branchenstandards, die oft ein Vielfaches an Decode-Knoten erforderten.
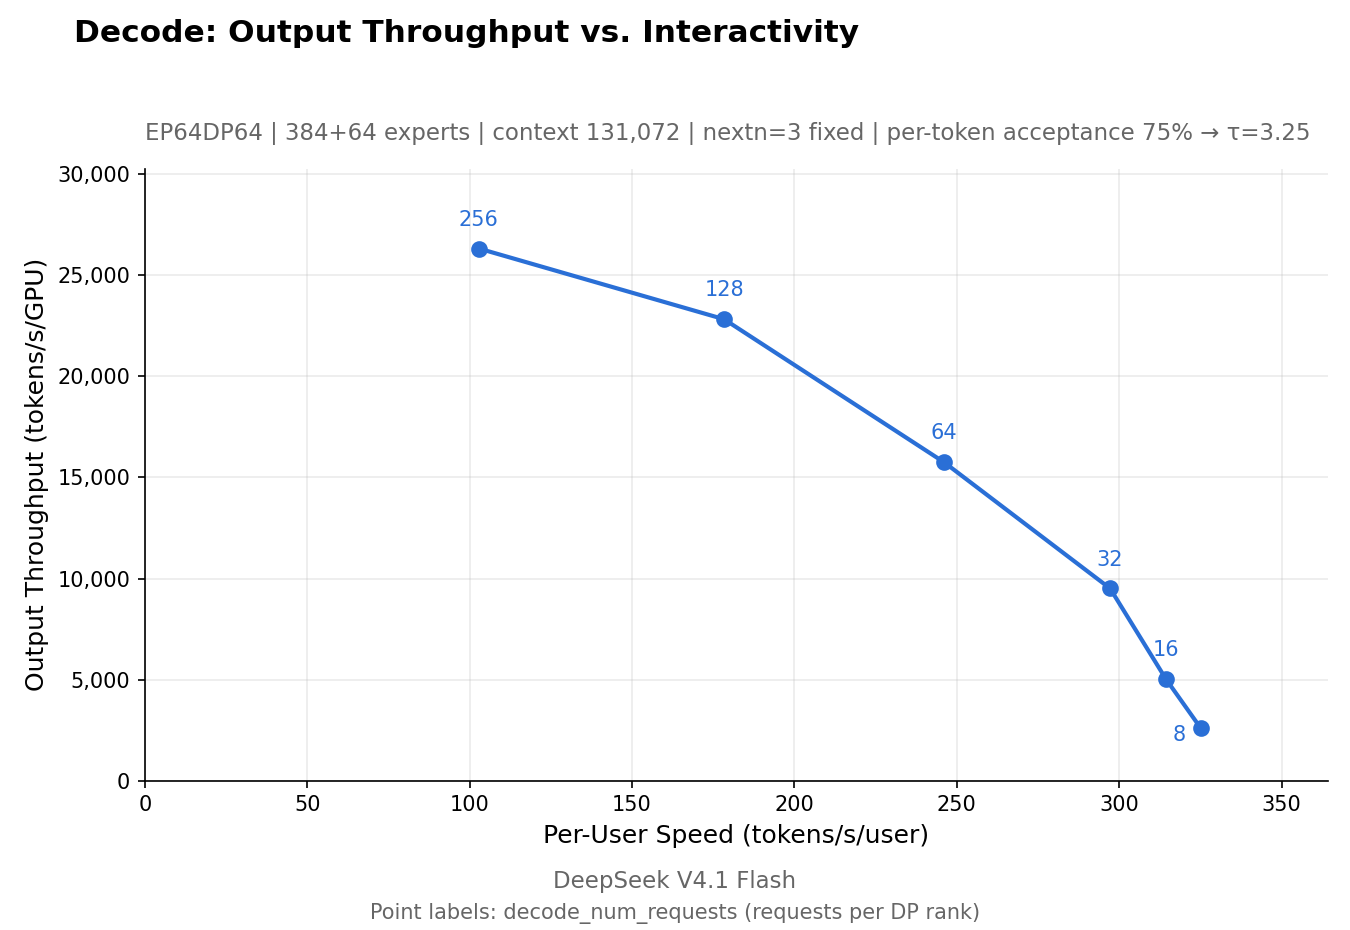 Abb.: Offizielle Decode-Pareto-Kurve von DeepInfer auf Basis von 64x SM100. Selbst unter massiver Batch-Parallelität bleibt die Generierungsgeschwindigkeit pro Nutzer stabil und balanciert Gesamtdurchsatz mit Reaktionszeit aus. Quelle: deepseek-ai/DeepInfer
Der Neuberechnungsaufwand bei langen Kontexten wird durch einen Sliding-Window-Mechanismus mit beschränktem Replay (Bounded Replay) gelöst. Herkömmliche Sliding-Window-Ansätze müssen oft den gesamten Verlauf neu berechnen, sobald Grenzen überschritten werden. DeepInfer beschränkt das Replay strikt auf ein Suffix von 140 Tokens. Unabhängig davon, wie lang die Sequenz wird, bleiben die Kosten für die Rekonstruktion konstant.
Spekulatives Decoding nutzt das parallele DSpark-Draft-Modul in Kombination mit dynamischer Konfidenzsteuerung. Das System passt die Verifizierungslänge dynamisch an die aktuelle Auslastung an. Dies bringt bei gleichem Durchsatz einen Geschwindigkeitsvorteil von 60 % bis 85 % gegenüber dem MTP-1-Standard und erhöht den Cluster-Gesamtdurchsatz um 6 %.
Ein asynchroner Scheduler überlappt CPU-Planung und GPU-Ausführung, wodurch Leerlaufphasen (Bubbles) im Batching vermieden werden. Auf NVIDIA-Karten garantiert ein Parameter für Batch-Invarianz deterministische Antworten. Die Hilfsbibliothek deepseek-recipe vereinheitlicht zudem API-Formate und kümmert sich um Prompt-Aufbereitung und Validierung.
Open-Source-Engine markiert die Grenzen des Produktivbetriebs
Der Umfang der Veröffentlichung folgt einer durchdachten Linie. DeepSeek hat den Kern für Offline-Inferenz und die Skalierung einzelner Knoten offengelegt, behält jedoch die darüber liegende Infrastruktur für globale Cloud-Dienste im eigenen Haus. Weder das verteilte 72-Stunden-KVCache-Speichersystem noch die übergreifenden Load-Balancer wurden im Repository veröffentlicht.
Diese Trennung verdeutlicht den Unterschied zwischen On-Premises-Setups und Hyperscale-Cloud-Angeboten. Unternehmen können Kernel-Optimierungen und Batch-Scheduler lokal nutzen, um exzellente Durchsatzwerte zu erzielen. Um jedoch hochverfügbare, weltweite Cloud-APIs bereitzustellen, bleibt eine spezialisierte Cluster-Orchestrierung unverzichtbar.
Der Preiskampf bei großen Sprachmodellen hat sich unwiderruflich in die systemnahe Inferenztechnik verlagert. Offene Modellgewichte definieren nur die Leistungsobergrenze; das Inferenz-Framework bestimmt die realen Bereitstellungskosten je Token. Wenn Ascend 950 und SM100 gemeinsam 155 Billionen Tokens pro Tag bewältigen, verliert der reine Spitzenwert einzelner Chips an Bedeutung. Ganzheitliche Systemarchitektur und praxiserprobte Orchestrierung bilden das wahre Fundament für den industriellen KI-Einsatz.
Weiterführende Links:
- Offizielles DeepInfer Code-Repository und Architekturübersicht
- deepseek-recipe: Protokoll- und Formatierungsbibliothek
- DSpark Forschungsarbeit zu spekulativem Decoding (arXiv:2607.05147)
- Technische Diskussion in der Hacker-News-Community