Unberührte Algorithmen-Rezeptur, Terminal-Benchmark springt um 11,1 Punkte
Am 17. Oktober 2026 veröffentlichte DeepSeek den Gewichtungs-Snapshot V4.1-Flash-1017. Im begleitenden technischen Bericht stellte das Team unmissverständlich klar, dass keine neuen Algorithmen eingeführt wurden und die Optimierungsrezeptur völlig unverändert blieb. Dennoch kletterte der Wert im Terminal-Bench 4.0, der praktische Terminal- und CLI-Operationen evaluiert, bei diesem Zwischenrelease von 31,2 auf 42,3 Punkte.
Ein Sprung um 11,1 Punkte markiert eine spürbare Verschiebung des Wettbewerbsfeldes. Zwar behält Claude Opus 5 in derselben Testsuite bei Terminal-Bench 4.0, ProgramBench, NL2Repo und HLE weiterhin die Führung, doch die 1017-Iteration zog bei DeepSWE v1.1, Automation-Bench, Agents’ Last Exam und Apex Bench an der geschlossenen Konkurrenz vorbei. Dieser Zuwachs von über 11 Punkten entstand ohne die Modifikation einer einzigen Zeile algorithmischen Trainingscodes.
DeepSeek bezeichnete das Release als „Wish-Driven Coding“ und stellte durchgängige Software-Engineering-Workflows in den Vordergrund. Die vorgestellten Demos reichten von der 3D-Modellierung der Verbotenen Stadt über webbasierte Rennspiele bis hin zur Rekonstruktion von Spieleklassikern in der Godot-Engine. Gegenüber Vorgängermodellen bewältigt das Modell Aufgaben schneller und generiert deutlich kürzere Token-Sequenzen. Die Reduktion redundanter Ausgaben verringert spürbar die kumulierte Latenz über mehrstufige Dialoge hinweg.
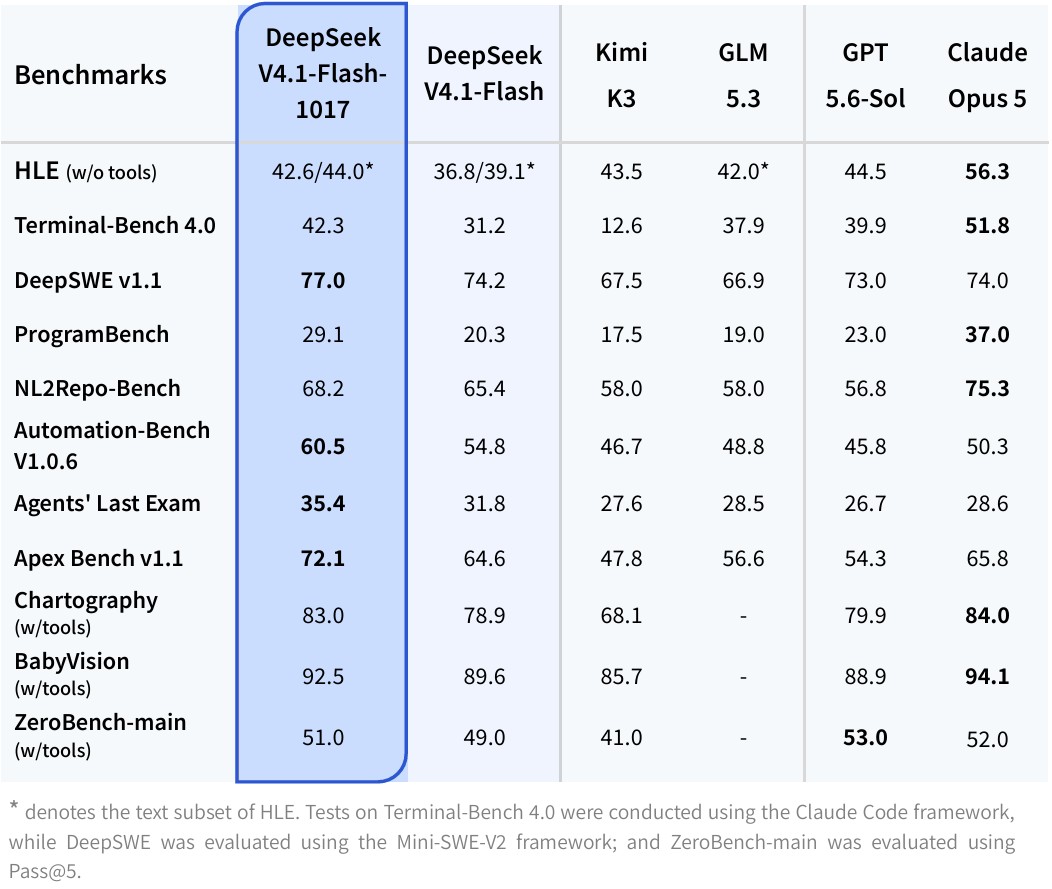 Abbildung: Offizielle Benchmark-Vergleichstabelle mit den Punktedifferenzen des 1017-Snapshots gegenüber dem Vorgänger. Quelle: Offizielle Release-Ankündigung von DeepSeek
Auch andere Agenten-Metriken verzeichneten deutliche Zuwächse. In der Testumgebung von Claude Code stieg die Lösungsrate von DeepSWE v1.1 von 74,2 % auf 77,0 %. ProgramBench verbesserte sich von 20,3 auf 29,1 Punkte, während Apex Bench v1.1 von 64,6 auf 72,1 Punkte vorrückte. Die Leistungsobergrenze für automatisierte Programmier-Benchmarks verschiebt sich kontinuierlich nach oben.
Grenzerträge verlagern sich auf Umgebungspipelines: Synthetische Aufgaben stützen langes Schließen
Abschnitt 5.1 des technischen Berichts beleuchtet den ingenieurtechnischen Schwerpunkt hinter dem Benchmark-Sprung. Das Post-Training folgte weiterhin der standardisierten Routine aus Supervised Fine-Tuning (SFT), Reinforcement Learning (RL) und On-Policy-Destillation. Stattdessen investierte das Team das Rechenbudget massiv in die Generierung synthetischer Aufgaben und die Bereitstellung interaktiver Umgebungen.
Der Bericht formuliert eine klare Schlussfolgerung: Zum gegenwärtigen Zeitpunkt übertrifft der Grenzertrag aus Daten- und Umgebungspipelines algorithmische Neuerungen deutlich. Statische, manuell annotierte Datensätze stoßen bei komplexen, langwierigen Interaktionen rasch an ihre Grenzen. Terminal-Interaktionen erfordern Zustandswiederherstellungen und präzises Abfangen von Fehlern – ein Verhalten, das zwingend durch programmatische Synthese skaliert werden muss.
Das Team entwickelte automatisierte Pipelines, um verifizierbare und diverse Interaktionsräume programmatisch zu erzeugen. Alle synthetisierten Aufgaben durchlaufen eine strikte Deduplizierung sowie eine präzise Kalibrierung des Schwierigkeitsgrades. Die deterministische Überprüfbarkeit der Aufgaben liefert dem Reinforcement Learning stabile Belohnungssignale und verhindert effektiv Reward-Hacking bei der Strategieexploration.
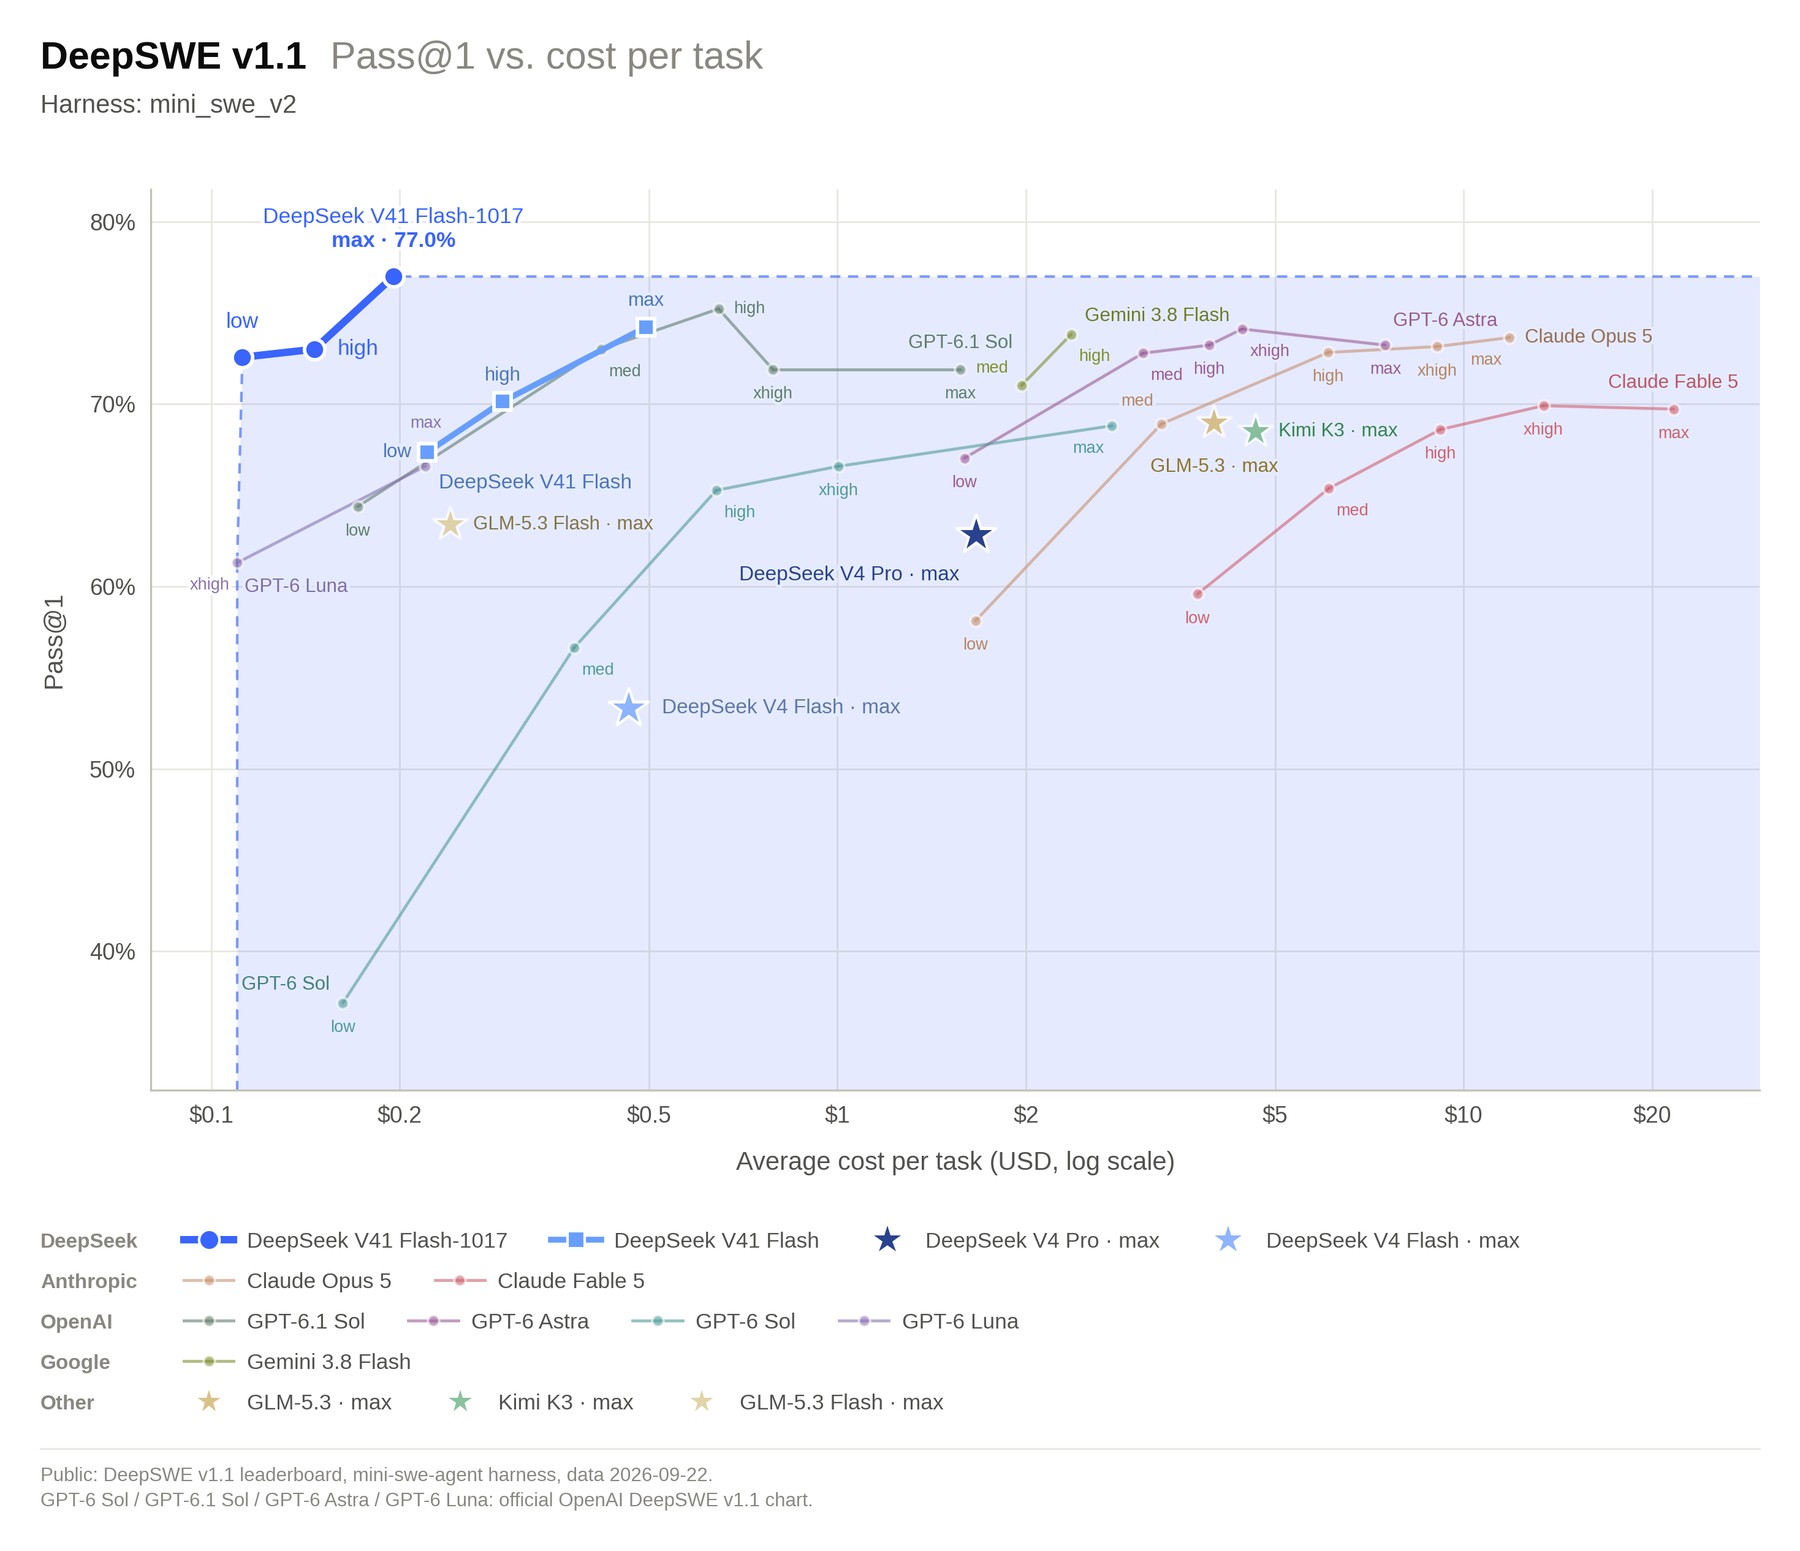 Abbildung: Offizielle Performance-Kosten-Kurve, die den Rechenaufwand pro Aufgabe im Verhältnis zu DeepSWE v1.1 Pass@1 darstellt. Quelle: Offizielle Release-Ankündigung von DeepSeek
Multimodale Kennzahlen bestätigen die Wirksamkeit dieses Umgebungsansatzes. Im Chartography-Test mit externen Werkzeugaufrufen verbesserte sich das Modell von 78,9 auf 83,0 Punkte. BabyVision stieg von 89,6 auf 92,5, und ZeroBench-main rückte von 49,0 auf 51,0 Punkte vor. Die durch reale Umgebungsinteraktionen gewonnenen Fähigkeiten strahlten unmittelbar auf modalitätsübergreifende Wahrnehmungsaufgaben ab.
Auf 890 Byte pro Token komprimiert: KV-Cache setzt ein neues Kostenfundament
Agentisches Schließen erfordert gigantische Kontextmengen. Wiederholte Werkzeugaufrufe verlängern die Dialoghistorie fortlaufend, wodurch die Speicherbandbreite der GPUs als erstes an ihre Grenzen gerät. Damit extrem lange Kontexte zum standardmäßigen Arbeitsmodus werden können, müssen die Kosten pro Cache-Einheit auf ein absolutes Minimum gesenkt werden.
Das architektonische Design von V4.1-Flash liefert dafür das hardwareseitige Fundament. Das Modell basiert auf einer kausalen Encoder-Decoder-Struktur mit insgesamt 552 Mrd. Parametern und verarbeitete im Pre-Training 45 Billionen multimodale Daten-Token. In der Dekodierungsphase werden 16 Mrd. Parameter aktiviert, in der Prefill-Phase lediglich 8 Mrd. Parameter. Dieses leichtgewichtige Prefill reduziert die Latenz bis zum ersten Token (TTFT) dramatisch.
Der physikalische Durchbruch basiert auf der Kombination der CSA2-Attention-Kompression mit FP4-Caching. Durch ebenenübergreifende Wiederverwendung schrumpft der globale KV-Cache-Bedarf auf lediglich 890 Byte pro Token. Dieser Speicher-Footprint entspricht einem Viertel des Vorgängers V4-Flash und lediglich 1/437 der Architektur der ersten Generation.
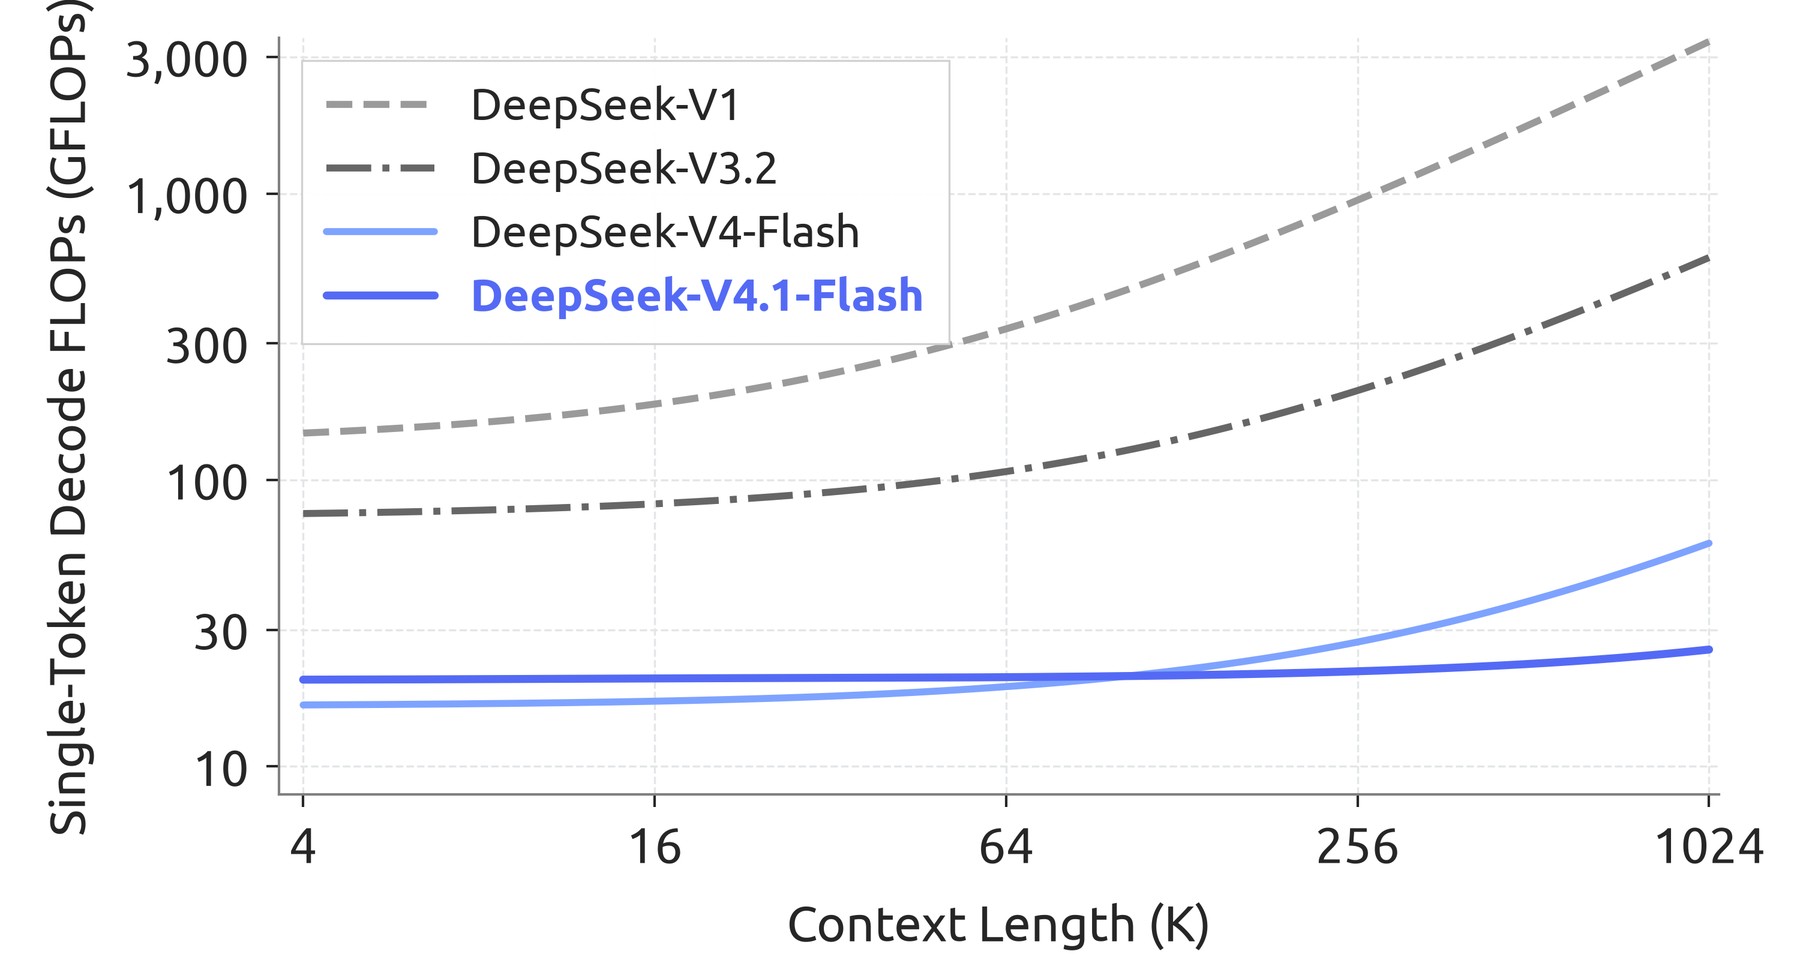 Abbildung: Berechnungsaufwand (FLOPs) für die Dekodierung eines einzelnen Tokens bei Kontextlängen von bis zu 1M Tokens. Quelle: Technischer Bericht zu DeepSeek-V4.1-Flash
In Kombination mit einem Sliding-Window-Mechanismus für Boundary-Replays sank der persistente Cache-Bedarf auf ein Achtel der vorherigen Generation. Auch die Rechenaufwandskurve verläuft bemerkenswert flach: Eine 256-fache Vergrößerung des Kontextes von 4K auf 1M Tokens erhöht die Gleitkommaoperationen pro dekodiertem Token um lediglich 25 %. Extrem lange Kontexte wandeln sich damit von einem kostspieligen Luxus zum praxistauglichen Standard.
Abschied von Jinja-Templates: Automatisierte Protokolle ersetzen manuelle Feinheiten
Der drastische Verfall der Inferenzkosten beschleunigt die Evolution der Entwickler-Toolchains. Auf der Hosting-Plattform OpenRouter liegt der Eingabepreis für das Modell bei 0,10 US-Dollar pro Million Tokens. Der Ausgabepreis bleibt bei 0,50 US-Dollar, während Cache-Lesezugriffe auf minimale 0,002 US-Dollar gesenkt wurden.
Parallel dazu öffnete DeepSeek den Zugriff auf seine hauseigenen Schnittstellen für Search und Fetch. Das Suchsystem verarbeitet täglich Hunderte Millionen externer Anfragen und wird mit 0,75 US-Dollar pro 1.000 Aufrufen bepreist. In den offiziellen Werkzeugen und führenden Programmierassistenten bleibt die Funktion bis zum 31. Oktober 2026 kostenlos. Günstige Retrieval-Mechanismen befreien Agenten von den Wissensgrenzen statischer Pre-Training-Stände.
Mit dieser Generation verabschiedet sich DeepSeek vollständig von traditionellen Jinja-Template-Dateien. Stattdessen stellt das Team eine in sich geschlossene Python-Referenzimplementierung bereit, flankiert von einer nativen Rust-Bibliothek mit Python-Bindings. Der Parser verarbeitet mehrstufige Dialoge, Chain-of-Thought-Abläufe, das nachträgliche Injizieren von Systemnachrichten sowie gemischte Text-Bild-Markups. Die Übernahme des Parsings durch eine native Low-Level-Bibliothek eliminiert das Risiko von Formatierungsfehlern vollständig.
Auch die empfohlenen Sampling-Hyperparameter spiegeln eine klare Philosophie wider: Sowohl Temperatur als auch Top-P sind auf 1,0 festgesetzt, bei einer geforderten Mindestausgabelänge von 256K Tokens. Über das 1-Million-Token-Fenster hinweg muss das Modell langfristigen Instruktionen strikt folgen. Durch den Einsatz strukturierter Kommunikationsbibliotheken gehören Parsing-Konflikte bei multiplen Werkzeugaufrufen endgültig der Vergangenheit an.
Die interaktive Umgebung als Wasserscheide: Der Wettbewerb kehrt zum Engineering-Durchsatz zurück
Das Signal des 1017-Snapshots ist eindeutig: Während die Erträge reiner Algorithmen-Optimierung abflachen, lassen sich durch skalierte, deterministisch überprüfbare Umgebungen und robuste Kalibrierungspipelines zweistellige Benchmark-Zuwächse erzielen.
Gleichzeitig schafft der 890-Byte-Cache das Fundament für einen praxistauglichen Produktiveinsatz. Erst wenn die Kosten für Lese- und Schreibzugriffe vernachlässigbar werden, lässt sich hochfrequentes Ausprobieren von Agenten wirtschaftlich rechtfertigen. Der Hebel im Open-Source-Ökosystem hat sich von statischen Modellgewichten hin zu Umgebungspipelines und Systemintegration verschoben: Wer in der Lage ist, überprüfbare Interaktionswelten dauerhaft und kostengünstig bereitzustellen, definiert die nächsten Leistungsgrenzen moderner KI.
Weiterführende Links:
- DeepSeek-V4.1-Flash-1017 Offizielle Ankündigung und Open-Source-Modellgewichte
- DeepSeek-V4.1-Flash Technischer Bericht: Pushing the Limits of KV Cache Compression
- Terminal-Bench 4.0 und DeepSWE v1.1 Technische Spezifikationen
- Hacker News Community-Diskussion