Ein komplettes Code-Repository oder ein Dutzend dicker Fachbücher auf einen Schlag in ein Chatfenster einzuspeisen, war lange der kühnste Traum von Softwareentwicklern. Selbst wenn LLMs auf dem Papier Millionen-Token-Fenster versprachen, fraßen astronomischer VRAM-Verbrauch und explodierende Rechenkosten das Budget binnen Minuten auf. DeepSeek hat nun auf Hugging Face die Modellgewichte von DeepSeek-V4.1-Flash-1017 unter der MIT-Lizenz veröffentlicht. Dieser Gigant mit 763 Milliarden (763B) Parametern erweitert das Kontextfenster auf 1 Million Token (die elementare Sinneinheit der Textverarbeitung; entspricht rund 750.000 bis 1 Million Wörtern). Der begleitende technische Bericht nennt das zentrale Ziel bereits im Titel beim Namen: DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression (Die Grenzen der KV-Cache-Kompression ausreizen).
Bisher rückten KI-Labore bei Neuvorstellungen fast ausnahmslos Benchmark-Rekorde ins Rampenlicht, die menschliche Spitzenforscher übertreffen sollten. Diesmal räumt DeepSeek der eher trockenen Cache-Kompressionstechnik den prominentesten Platz ein. Der eigentliche Kern dieses Updates liegt darin, die Betriebskosten für extrem lange Kontexte radikal zu senken: Durch die KV-Cache-Kompression werden 1 Million Token vom unbezahlbaren Ausstellungsstück zum praxistauglichen Alltagswerkzeug; der Engpass für Entwickler verschiebt sich damit von der Fenstergröße hin zu Kostenkontrolle und Engineering-Disziplin.
 Abb.: Markenlogo im offiziellen DeepSeek-Repository; das neu veröffentlichte V4.1-Flash-1017 setzt weiterhin auf die liberale MIT-Open-Source-Lizenz. Quelle: Offizielles GitHub-Repository von DeepSeek
Den KV-Cache bis zum Limit ausreizen: 1 Million Token in regulärem GPU-Speicher
Warum ist die Verarbeitung langer Texte für große Sprachmodelle eigentlich so teuer? Ein menschlicher Leser behält beim Umblättern einer Seite lediglich die wesentlichen Handlungsstränge im Gedächtnis. Wenn ein Sprachmodell jedoch ein neues Wort generiert, muss es die berechneten internen Repräsentationen von Hunderttausenden vorangegangenen Wörtern vollständig im VRAM vorhalten, um sie abzugleichen. Dieser reservierte VRAM-Bereich, der dem permanenten Auswendiglernen des Kontextes dient, nennt sich KV-Cache (Key-Value-Cache; die internen Zwischenzustände, mit denen das Modell während der Inferenz den bisherigen Kontext bewahrt).
Wächst eine Konversation von einigen Tausend Wörtern auf 1 Million Token an, explodiert der vom KV-Cache belegte Speicherplatz wie eine Lawine. Noch bevor die Grafikkarte eine einzige Zeile neuen Code ausgibt, verstopft das bloße Hin- und Herschaufeln dieses gigantischen Verlaufs-Caches die gesamte Speicherbandbreite. Viele Modelle, die Millionen-Kontexte bewerben, reagieren in der Praxis quälend langsam oder schlagen bei einer einzelnen Anfrage mit horrenden Kosten zu Buche. Die Gesetze der Physik sind unerbittlich: Solange das Datenvolumen dieser Zwischenzustände nicht drastisch schrumpft, bleiben extrem lange Kontexte auf Präsentationsfolien beschränkt.
DeepSeek-V4.1-Flash-1017 richtet seine schärfste Waffe trotz seiner gewaltigen 763B Parameter direkt gegen diese VRAM-Mauer. Der technische Bericht widmet sich der physikalischen Grenze der Cache-Kompression; die offizielle Modellkarte stellt sogleich vier Präzisionsformate bereit: BF16, F32, F8_E4M3 und I8. Die synchrone Reduktion des KV-Cache-Volumens und die Bereitstellung niedrigpräziser Gewichte verschlanken den Speicherbedarf eines 1-Million-Token-Gedächtnisses grundlegend. Arbeitslasten, die zuvor sündhaft teure Rechencluster erforderten, erhalten damit eine realistische physikalische Basis für den täglichen Hochfrequenzeinsatz.
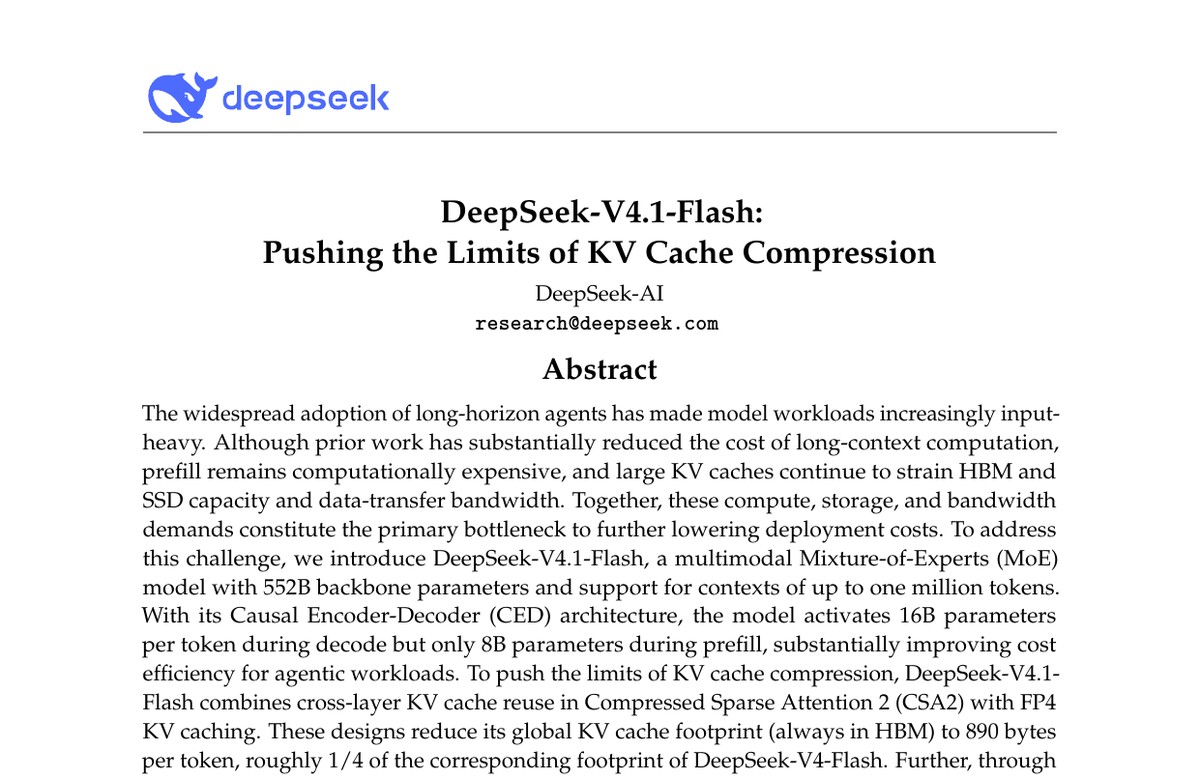 Abb.: Die Titelseite des technischen Berichts stellt das Ausreizen der KV-Cache-Kompression direkt heraus und unterstreicht das zentrale Ingenieursziel: massive Kostensenkung bei der Long-Context-Inferenz. Quelle: Technischer Bericht zu DeepSeek-V4.1-Flash (Pushing the Limits of KV Cache Compression)
Terminal-Benchmark klettert um 11,1 Punkte: Gesparter Cache ermöglicht ausgiebige Fehlersuche
Muss man befürchten, dass ein Modell an Schärfe verliert, wenn der Fokus so radikal auf Cache-Kompression und Inferenzkosten liegt? Ein Blick auf die Benchmark-Tabelle der offiziellen Modellkarte auf Hugging Face im Vergleich zur Vorgängerversion DS-V4.1-Flash, zu K3, GLM-5.3, GPT-5.6 Sol und dem proprietären Maßstab Opus 5 verdeutlicht die Marschrichtung. Im werkzeuglosen Extremtest für menschliches Wissen (HLE) erzielt das Modell 42,6 Punkte und liegt damit noch hinter Opus 5 (56,3 Punkte). Bei ProgramBench, das algorithmisches Programmieren bewertet, klettert das Modell zwar von 20,3 auf 29,1 Punkte, ordnet sich jedoch weiterhin hinter Opus 5 (37,0 Punkte) ein.
Sobald die Testszenarien jedoch zu anspruchsvollen Engineering-Aufgaben wechseln, die lange Kontexte und wiederholte Werkzeugaufrufe erfordern, wendet sich das Blatt. Im Terminal-Benchmark Terminal-Bench 4.0 – mit Claude Code als Ausführungsumgebung – springt das Modell von 31,2 auf 42,3 Punkte. Dieser Sprung um 11,1 Punkte bringt es in unmittelbare Reichweite von Opus 5 (51,8 Punkte). Im Software-Engineering-Benchmark DeepSWE v1.1 auf Basis von Mini-SWE-V2 verbessert sich das Ergebnis von 74,2 auf 77,0 Punkte. Und im Härtetest Agents’ Last Exam erzielt das Modell 35,4 Punkte und überholt damit GPT-5.6 Sol (26,7 Punkte) deutlich.
Darüber hinaus verbucht es 68,2 Punkte beim Repository-Aufbau (NL2Repo-Bench), 60,5 Punkte bei Automation-Bench v1.0.6 und 72,1 Punkte bei Apex Bench v1.1. In den werkzeuggestützten Tests Chartography und BabyVision liefert es starke 83,0 bzw. 92,5 Punkte ab. Warum schneidet das Modell bei Aufgaben mit Tool-Nutzung, Repository-Eingriffen und Terminal-Ausführung derart überzeugend ab? Weil autonome Agenten wie Softwareentwickler arbeiten: Sie lesen Fehlermeldungen, wälzen alte Dateien und rufen externe Befehle Runde für Runde auf. Mit jedem Fehlversuch verdoppelt sich der Kontext. Bei punktuellen Spitzenleistungen im abstrakten Denken behalten proprietäre Spitzenmodelle die Oberhand; bei kontextintensiven, iterativen Entwicklungsaufgaben erlaubt der günstige KV-Cache dem Modell jedoch, durch ausdauernde Fehlersuche den Sieg zu erringen.
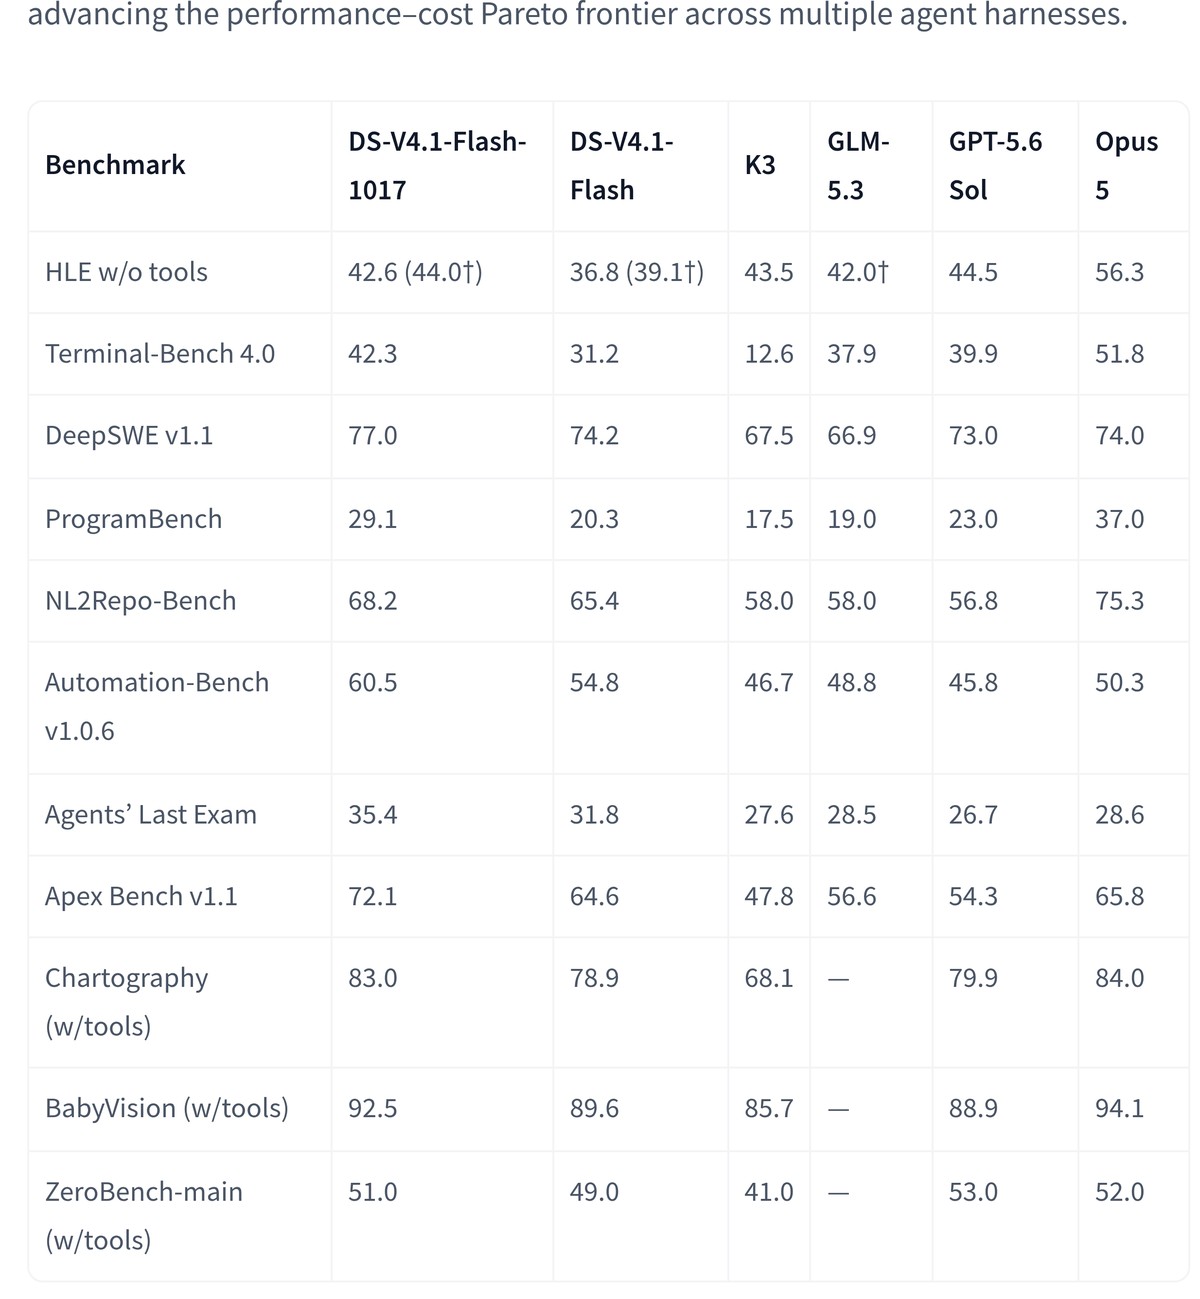 Abb.: Benchmark-Vergleich der offiziellen Modellkarte: Gegenüberstellung von V4.1-Flash-1017 mit der Vorgängerversion, K3, GLM-5.3, GPT-5.6 Sol und Opus 5 in verschiedenen Disziplinen. Quelle: Hugging Face Modellkarte (DeepSeek-V4.1-Flash-1017)
Verzicht auf Jinja-Templates: 19 Community-Quantisierungen übernehmen das Deployment
Um stabile Funktionsaufrufe über Konversationen von einer Million Token hinweg zu garantieren, zog DeepSeek auf Schnittstellenebene einen klaren Schlussstrich. Üblicherweise legen Open-Source-Modelle Jinja-Chat-Templates bei – Skripte, die Unterhaltungen anhand von Platzhaltern zu einem zusammenhängenden Eingabestring zusammenfügen. Wenn sich jedoch Dutzende Werkzeugaufrufe und endlose Codeblöcke im Prompt mischen, führen einfache String-Verkettungen leicht zu Formatierungsfehlern. Das offizielle Repository verzichtet daher komplett auf Jinja-Templates und stellt stattdessen eine encoding-Referenzimplementierung bereit, die Formate wie Messages, Chat Completions und Responses passgenau in die interne Conversation-Struktur überführt.
Gleichzeitig enthält die Modellkarte eine bemerkenswerte Empfehlung für die Sampling-Parameter: Sowohl temperature (reguliert den Zufall bei der Textgenerierung) als auch top_p (Nucleus-Sampling-Schwellenwert) sollten auf 1,0 gesetzt werden. Entwickler, die zur Absicherung gerne niedrige Temperaturwerte wählen, mag diese Vorgabe überraschen. Nach umfangreichem Training in extrem langen Kontexten sorgt die unverfälschte Wahrscheinlichkeitsverteilung bei 1,0 jedoch dafür, dass das Modell in verwinkelten Terminal-Debug-Schleifen flexibel bleibt und nicht in Sackgassen verharrt.
Das Ökosystem reagierte prompt auf die Veröffentlichung der Gewichte. Obwohl DeepSeek selbst auf Hugging Face keine gehosteten Inferenz-Endpunkte anbot, stellte die Open-Source-Community binnen kürzester Zeit 3 feinabgestimmte Varianten und 19 Quantisierungen bereit (komprimierte Versionen mit reduzierter Zahlenpräzision für erschwingliche Consumer-Grafikkarten). DeepSeek schloss mit robuster encoding-Logik Formatierungsrisiken bei langen Konversationen aus, während die Community mit 19 Quantisierungen die Lücke bei der Rechenkapazität schloss. Das Open-Source-Ökosystem hat damit eine praxistaugliche, kostengünstige Bereitstellungspipeline aufgebaut.
Das 20-Dollar-Abo in Minuten verbrannt: Engineering-Disziplin entscheidet über die Rechnung
Sobald das 1-Million-Token-Fenster und der komprimierte KV-Cache den Entwicklern zur Verfügung standen, verlagerte sich die Debatte rasch von der Frage der Machbarkeit hin zur Belastbarkeit des Budgets. In internationalen Entwicklerforen drehten sich die Diskussionen fast ausschließlich um die Betriebskosten. Mehrere Praktiker rechneten vor: Füttert man ganze Repositories in iterative Agenten-Schleifen, ist ein fixes 20-Dollar-Monatsabonnement bei Volllast in wenigen Minuten erschöpft. Wesentlich wirtschaftlicher ist es oft, direkt verbrauchsabhängige APIs (Application Programming Interfaces) anzubinden und rein nach tatsächlichem Token-Verbrauch abzurechnen.
Mit größeren Kontextfenstern und sinkenden Preisen pro Token trat zudem ein versteckter Kostenfaktor zutage. Erfahrene Entwickler geben zu bedenken: Selbst wenn ein Modell 77,0 Punkte in DeepSWE v1.1 erreicht und eigenständig im Terminal Code repariert, enthält der generierte Code nach wie vor redundante Logik und ungeprüfte Randfälle. Senior-Entwickler müssen weiterhin Zeit investieren, um den Code Zeile für Zeile zu prüfen – ein personeller Aufwand, der sich nicht wegkürzen lässt. Als Kontexte auf wenige Tausend Wörter beschränkt waren, filterten Programmierer relevante Abschnitte sorgfältig von Hand. Mit einem offenen Fenster von 1 Million Token verfallen viele in die Gewohnheit, komplette Projekte mitsamt unpräzisen Anforderungen ungefiltert in den Prompt zu kippen.
In der Softwaretechnik gelten die Gesetze der Erhaltung: Was Entwickler sich an Mühe beim Vorab-Filtern sparen, fordern API-Abrechnung und Code-Reviews später unweigerlich zurück. DeepSeek-V4.1-Flash-1017 reißt mit 763B Parametern und extremer KV-Cache-Kompression die Begrenzung des Kontextfensters ein, schafft aber kein kostenloses Mittagessen. Die KV-Cache-Kompression verwandelt 1 Million Token vom kostspieligen Rechenleistungs-Spektakel in ein produktives Arbeitsmittel. Wenn die Kontextgrenzen fallen, profitieren am Ende diejenigen, die unüberlegte Prompt-Völlerei zügeln und strenge Qualitätsdisziplin bei der Code-Prüfung wahren.
Weiterführende Links:
- Hugging Face Modellkarte: DeepSeek-V4.1-Flash-1017
- DeepSeek-V4.1-Flash Technischer Bericht (Pushing the Limits of KV Cache Compression)
- Hacker News Diskussion