リポジトリ全体や十数冊の専門書を丸ごとチャット欄に投入することは、かつてソフトウェアエンジニアにとって最も贅沢な夢だった。仮に大規模言語モデルがカタログスペック上で100万トークンの窓幅を掲げていても、莫大なVRAM消費と計算コストによって、わずか数分で予算が吹き飛んでしまうのが常だったからだ。DeepSeekはHugging Face上で、MITライセンスを採用したオープンモデルの重み『DeepSeek-V4.1-Flash-1017』を公開した。763B(7630億)パラメータという巨躯を備えながら、コンテキストウィンドウを100万トークン(テキスト処理の最小単位;日本語で約75万〜100万字相当)へと拡大。付属の技術レポートは、その野心をタイトルで率直に示している——『DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression』(KVキャッシュ圧縮の限界を押し広げる)。
これまで各社が新モデルを発表する際、スポットライトを浴びせるのは博士レベルを凌駕するベンチマークスコアが常だった。しかし今回、DeepSeekが一等地を与えたのは、地味とも言えるキャッシュ圧縮技術だった。今回のアップデートの真骨頂は、超長文コンテキストの運用コストを限界まで引き下げた点にある。KVキャッシュの劇的な圧縮によって、100万トークンは「高嶺の花の展示品」から「日常の開発ツール」へと変貌を遂げた。開発者の直面するボトルネックは、もはや窓の長さではなく、推論コストとエンジニアリング規律へと移行している。
 図:DeepSeek公式リポジトリに掲載されたブランドロゴ。今回リリースされたV4.1-Flash-1017も寛容なMITライセンスを踏襲している。出典:DeepSeek公式GitHubリポジトリ
KVキャッシュの限界を絞り尽くし、100万トークンを日常的なGPUメモリへ
なぜLLMで長い文章を読み込ませると、これほどコストが跳ね上がるのか。人間が本を読むときは、ページをめくっても頭の中に大まかな筋書きを残しておけば十分だ。しかしLLMが次の単語を生成する際、直前の数十万文字から算出された内部特徴量をすべてVRAM上に保持し、照合し続けなければならない。この前文の手がかりを丸暗記するために専有されるメモリ領域こそが、KVキャッシュ(Key-Value Cache;推論時に過去の文脈を保持するための中間状態)である。
対話の長さが数千字から100万トークンへと膨らむと、KVキャッシュが占有するメモリ容量は雪だるま式に激増する。GPUが新たなコードを生成し始める前に、この膨大な過去キャッシュをメモリ帯域間で行き来させるだけで、ハードウェア帯域は完全に飽和してしまう。市場に溢れる「100万トークン対応」を謳うモデルの多くが、実際の推論ではカタツムリのように遅くなるか、1回のリクエストで法外な請求が発生するのはこのためだ。中間状態のデータ量を劇的に削らない限り、超長文コンテキストはプレゼンスライドの域を出ないという物理的な壁があった。
『DeepSeek-V4.1-Flash-1017』は総計763Bという巨大なパラメータ規模を持ちながら、その主力をこのメモリの障壁へと集中させた。技術レポートはKVキャッシュ圧縮の物理的限界を正面から突き詰め、公式モデルカードでは BF16、F32、F8_E4M3、I8 という4種類の量子化・精度フォーマットを最初から用意した。KVキャッシュ容量と低精度重みを同時に圧縮することは、100万トークンという超長大な記憶を徹底的に軽量化することを意味する。これまで巨額の計算クラスタを専有しなければ動かせなかった100万字の文脈処理が、日常的に高頻度で呼び出せる物理的基盤を手に入れたのだ。
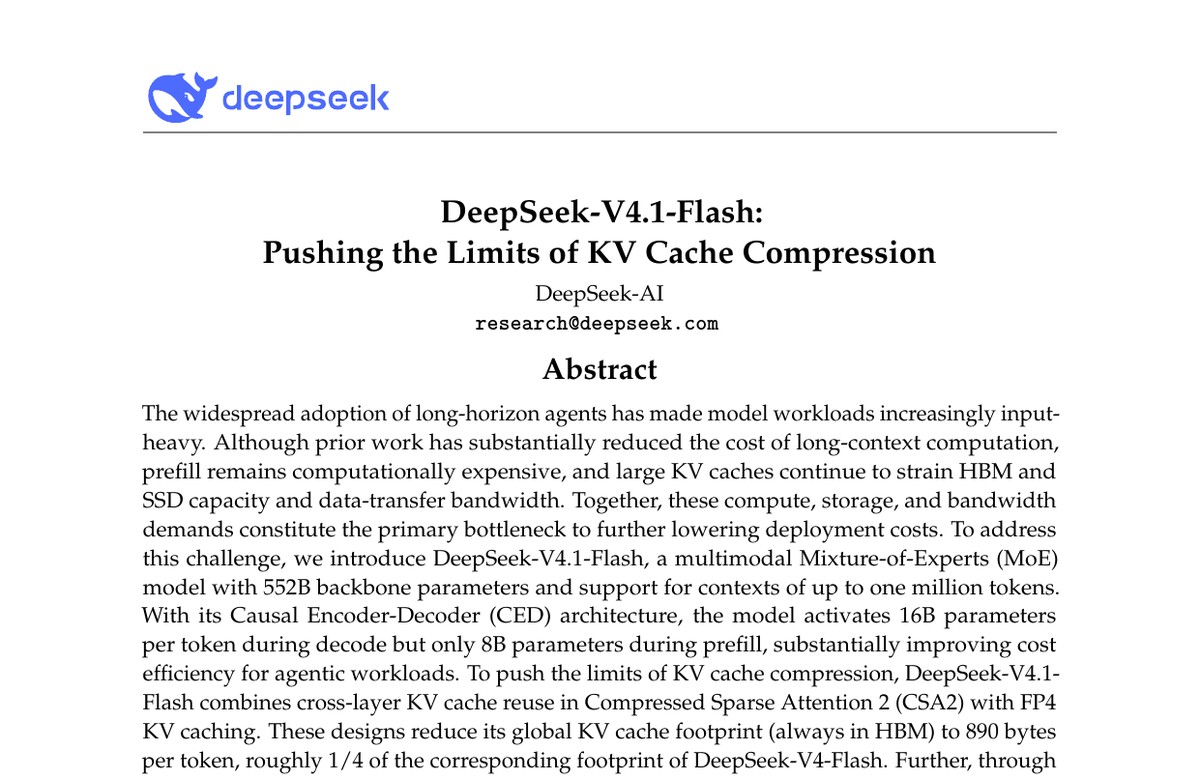 図:技術レポート表紙は「KVキャッシュ圧縮の限界を押し広げる」と直接掲げており、長文推論のコスト削減というコア目標を明確にしている。出典:DeepSeek-V4.1-Flash技術レポート(Pushing the Limits of KV Cache Compression)
端末ベンチマークで11.1ポイントの大幅伸長、キャッシュ節約が生む反復試行力
キャッシュ圧縮やコスト削減に注力した結果、モデル自体の知能が損なわれてはいないだろうか。Hugging Faceの公式モデルカードに掲載されたベンチマークスコアをめくり、前世代のDS-V4.1-Flash、K3、GLM-5.3、GPT-5.6 Sol、そしてプロプライエタリの最高峰Opus 5と比較すると、その開発意図が明瞭に見えてくる。外部ツールを使わない純粋な難関テストHLE(Humanity’s Last Exam)では42.6点を記録し、Opus 5の56.3点には届かない。アルゴリズムプログラミングを評価するProgramBenchでも前バージョンの20.3点から29.1点へと伸ばしたものの、Opus 5の37.0点の後塵を拝している。
だが、評価環境が「長大なコンテキストを保持し、反復的にツールを叩く」実戦的なエンジニアリングタスクへ移ると、潮目が一変する。Claude Codeを実行基盤として採用した端末ベンチマークTerminal-Bench 4.0において、新モデルは前バージョンの31.2点から42.3点へと急伸した。この11.1ポイントの跳躍により、Opus 5の51.8点へと一気に迫っている。Mini-SWE-V2フレームワークを用いたソフトウェア工学ベンチマークDeepSWE v1.1でも、スコアは74.2点から77.0点へと向上。自律型エージェントの総合力を試すAgents’ Last Examでは35.4点をマークし、GPT-5.6 Solの26.7点を直接逆転した。
さらに、リポジトリ全体を構築するNL2Repo-Benchで68.2点、Automation-Bench v1.0.6で60.5点、Apex Bench v1.1で72.1点を記録。ツール併用のChartographyとBabyVisionでもそれぞれ83.0点、92.5点という高得点を叩き出している。なぜ外部ツールを駆使し、リポジトリを改修し、ターミナルを実行するタスクでこれほどの強さを発揮するのか。AIエージェントの作業はプログラマーのバグ修正そのものであり、エラーログを読み、過去のファイルを漁り、外部コマンドを叩くサイクルを何度も繰り返すからだ。試行回数が増えるたび、コンテキスト長は倍々で膨らむ。単発の純粋な難問推論では依然として商用フラッグシップが優位に立つが、コンテキストを浴びるように消費する反復型エンジニアリング作業では、安価なKVキャッシュを武器にした高頻度の試行錯誤が勝利をもたらす。
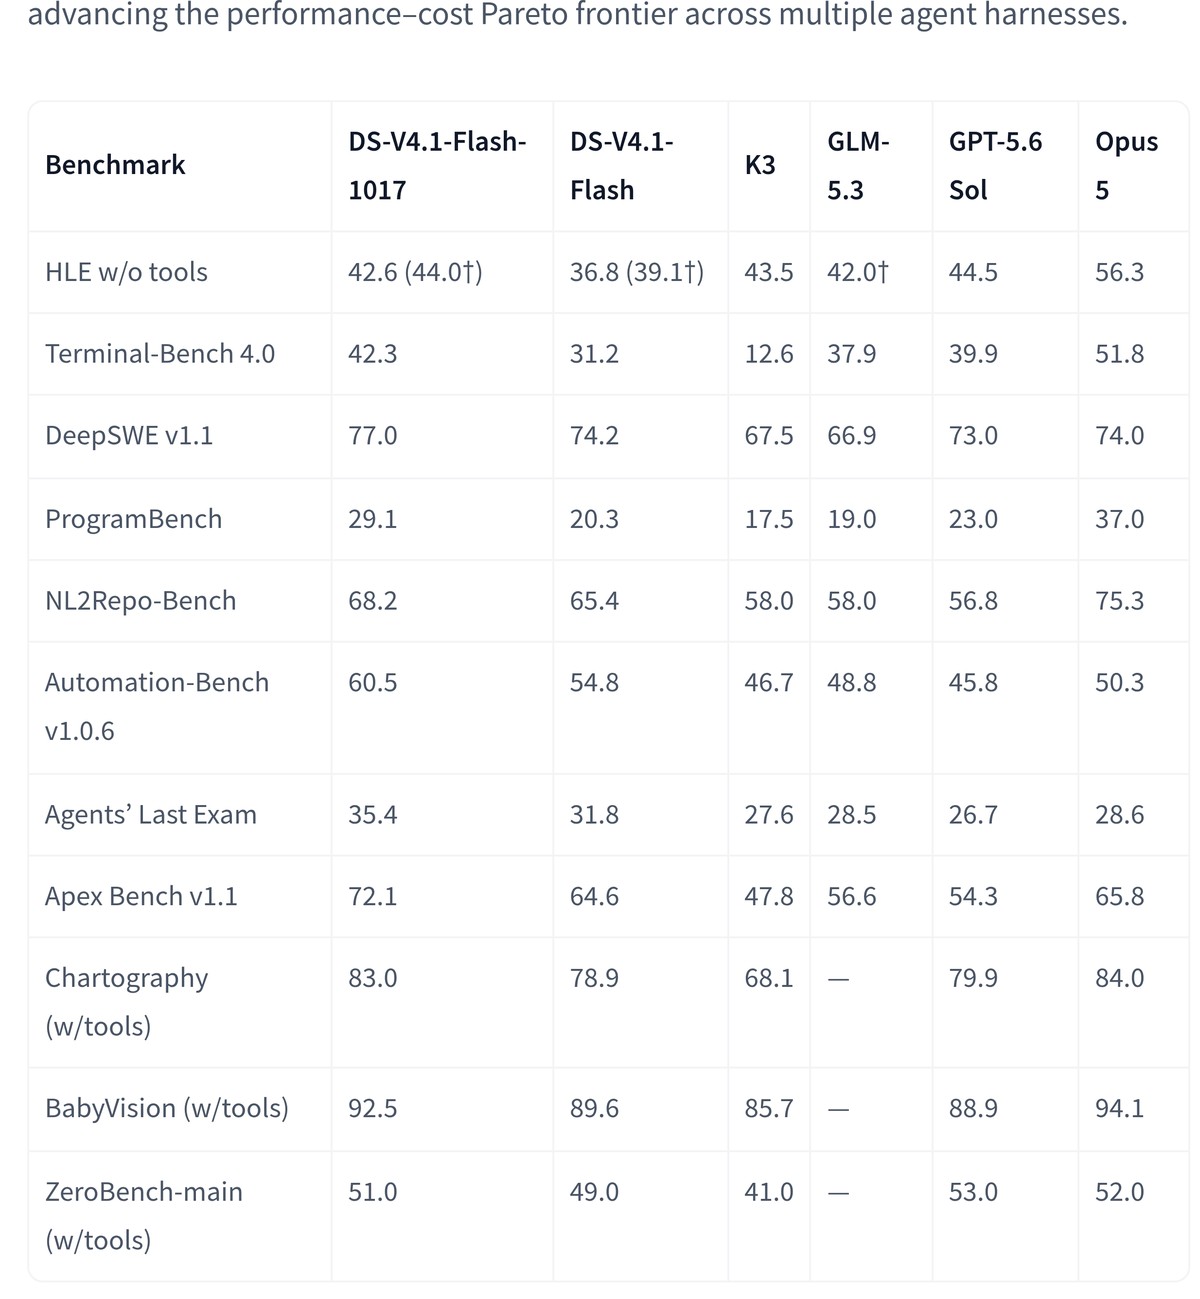 図:公式モデルカードに掲載されたベンチマーク比較。V4.1-Flash-1017と前代モデル、K3、GLM-5.3、GPT-5.6 Sol、Opus 5の各スコアを対比している。出典:Hugging Faceモデルカード(DeepSeek-V4.1-Flash-1017)
Jinjaテンプレートを撤廃、コミュニティの19量子化版が実運用を牽引
100万トークンに及ぶ長大な対話の中で安定したツール呼び出しを維持するため、DeepSeekはエンジニアリングの接合面で思い切った決断を下した。従来のオープンソースモデルは、対話履歴を文字列として連結するJinjaテンプレートファイルを同梱するのが通例だった。しかし、数十回に及ぶツール実行結果や長大なソースコードが混ざり合う環境では、単純な文字列連結はフォーマット崩れを極めて起こしやすい。そこで今回の公式リポジトリではJinjaテンプレートを完全に排除し、Messages、Chat Completions、Responses という主要3系統のAPIフォーマットを内部の Conversation 形式へ厳密にマッピングする公式 encoding リファレンス実装を投入した。
あわせて公式モデルカードでは、注目すべきサンプリング推奨値を提示している。temperature(生成のランダム性を制御する温度パラメータ)を1.0とし、top_p(核サンプリングの足切り閾値)も1.0のまま運用するという設定だ。安全のために温度を下げがちな開発者にとって、この指定は意外に思えるかもしれない。だが超長文環境で学習を重ねた結果、1.0本来の確率分布を維持する方が、迷路のようなターミナルデバッグにおいてモデルが袋小路に陥らず、柔軟な探索を継続できるのだ。
重み公開を受けたエコシステムの動きも極めて迅速だった。DeepSeek自身はHugging Face上でホスト型の推論エンドポイントを提供しなかったものの、オープンソースコミュニティは自発的に3種類のファインチューン版と19種類もの量子化版(数値精度を落としてモデルサイズを縮小し、低コストGPUでの動作を可能にする派生モデル)を立ち上げた。公式が堅牢な encoding 実装で長文対話のフォーマット破綻を防ぎ、コミュニティが19の量子化版によって計算リソースの隙間を埋める。オープンソースのエコシステムは、低コストで実用化へ繋ぐソフト・ハード連携のパイプラインをすでに完成させている。
20ドルの定額枠は数分で蒸発、エンジニアリング規律が請求額を決める
100万トークンの窓幅と圧縮されたKVキャッシュが実際に開発者の手に渡ったことで、議論の焦点は「収まるかどうか」から「財布がどこまで耐えられるか」へと急速にシフトした。海外の開発者コミュニティにおける新モデルの議論は、その大半がコストの損益計算に集中している。リポジトリ全体をまるごと読み込ませて自律エージェントを全開で走らせた場合、月額20ドルの定額サブスクリプション枠など数分で底をつくという試算が出ている。これに対し、従量課金制のAPIを利用して実消費分だけを支払う方が、結果的にコントロールしやすいという声も多い。
窓幅が広がり、トークン単価が安くなったことで、別の見えないコストも浮き彫りになりつつある。多くの現場プログラマーが指摘するのは、モデルがDeepSWE v1.1で77.0点を叩き出し、ターミナルで自律的にコードを修正できるとしても、出力されたコードには依然として冗長なロジックや境界値のバグが潜んでいるという点だ。熟練のエンジニアが1行ずつコードレビューを行って品質を担保する手間は、どれほどモデルが進化しても削ることができない。コンテキストが数千文字に限られていた時代、開発者は頭を使って重要なコード片を慎重に選別していた。だが100万トークンの扉が開かれた今、プロジェクト丸ごとと曖昧な要件をAIへ乱暴に投げつける悪癖が広がりつつある。
ソフトウェア工学における物理法則は常に保存される。プロンプトを推敲する初期の手間をAIに肩代わりさせても、そのツケは膨大なAPI請求書と過酷なコードレビューとなって必ず返ってくる。『DeepSeek-V4.1-Flash-1017』は763Bの規模と極限のKVキャッシュ圧縮によって、開発者の眼前に立ちはだかっていたコンテキストの壁を打ち砕いた。しかし、フリーランチ(無料の昼食)を生み出したわけではない。KVキャッシュ圧縮は、100万トークンを高価な計算力の見せ物から日常の生産性ツールへと引き戻した。コンテキストの上限という制約が消え去った今、無軌道なコンテキスト浪費を自制し、人間のエンジニアによるコード検証の規律を保てる者だけが、超長文時代の果実を真に享受できる。
参考リンク:
- Hugging Face モデルカード:DeepSeek-V4.1-Flash-1017
- DeepSeek-V4.1-Flash 技術レポート(Pushing the Limits of KV Cache Compression)
- Hacker News ディスカッション