Introducir un repositorio de código completo o una docena de manuales técnicos en una sola ventana de chat fue durante mucho tiempo la fantasía más codiciada de los ingenieros de software. Incluso cuando los grandes modelos anunciaban sobre el papel ventanas de un millón de palabras, el descomunal consumo de VRAM y las astronómicas facturas de cómputo agotaban los presupuestos en cuestión de minutos. DeepSeek acaba de publicar en Hugging Face los pesos de DeepSeek-V4.1-Flash-1017 bajo licencia MIT. Este coloso de 763.000 millones (763B) de parámetros eleva la ventana de contexto a 1 millón de tokens (la unidad básica de segmentación en procesamiento de texto, equivalente a unas 750.000 o 1.000.000 de palabras). El informe técnico que lo acompaña deja claras sus intenciones desde el propio título: DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression (Llevando la compresión de la caché KV al límite).
Hasta ahora, los laboratorios de IA solían centrar sus anuncios en marcas récord de rendimiento destinadas a superar exámenes de nivel de doctorado. En esta ocasión, DeepSeek ha reservado la portada para la técnica, a priori árida, de la compresión de caché. El verdadero valor de esta actualización reside en reducir drásticamente los costes operativos del contexto largo: la compresión de la caché KV convierte el millón de tokens de una pieza de museo prohibitiva en una herramienta diaria viable; el cuello de botella de los desarrolladores pasa así del tamaño de la ventana a la gestión del coste y la disciplina de ingeniería.
 Figura: Logotipo de la marca en el repositorio oficial de DeepSeek; el recién lanzado V4.1-Flash-1017 mantiene la permisiva licencia de código abierto MIT. Fuente: Repositorio oficial de DeepSeek en GitHub
Exprimir la caché KV al límite: 1 millón de tokens en la memoria gráfica habitual
¿Por qué resulta tan costoso para un LLM procesar textos extensos? Cuando un lector humano lee un libro, al pasar de página solo necesita retener una idea general en la memoria. Sin embargo, cuando un modelo de lenguaje genera cada nueva palabra, debe mantener en la memoria VRAM todas las representaciones internas calculadas a lo largo de los cientos de miles de palabras previas para poder cotejarlas. Este espacio exclusivo de memoria gráfica dedicado a memorizar el contexto anterior se conoce como caché KV (Key-Value cache; los estados intermedios que almacena el modelo durante la inferencia para recordar el texto previo).
Cuando una conversación pasa de unos miles de palabras a 1 millón de tokens, el volumen de memoria ocupado por la caché KV crece como una bola de nieve. Antes de que la tarjeta gráfica pueda escribir una sola línea de código nuevo, el mero trasiego de esta inmensa pila de caché a través del bus satura por completo el ancho de banda del hardware. Muchos modelos del mercado que prometen contextos millonarios se vuelven lentos como tortugas en la práctica o disparan el coste de cada petición individual. La física impone sus reglas: sin reducir el volumen de estos estados intermedios, el contexto ultra largo jamás saldrá de las diapositivas de presentación.
DeepSeek-V4.1-Flash-1017, a pesar de su descomunal escala de 763B parámetros, ha dirigido toda su artillería contra este muro de memoria. Su informe técnico aborda frontalmente los límites teóricos de compresión de la caché KV, y la ficha oficial del modelo ofrece directamente cuatro formatos de precisión: BF16, F32, F8_E4M3 e I8. Comprimir de forma coordinada el tamaño de la caché KV y los pesos de baja precisión aligera la carga de memoria de un flujo de 1 millón de tokens. Operaciones que antes exigían clusters de cálculo millonarios disponen ahora de una base física viable para su ejecución cotidiana y de alta frecuencia.
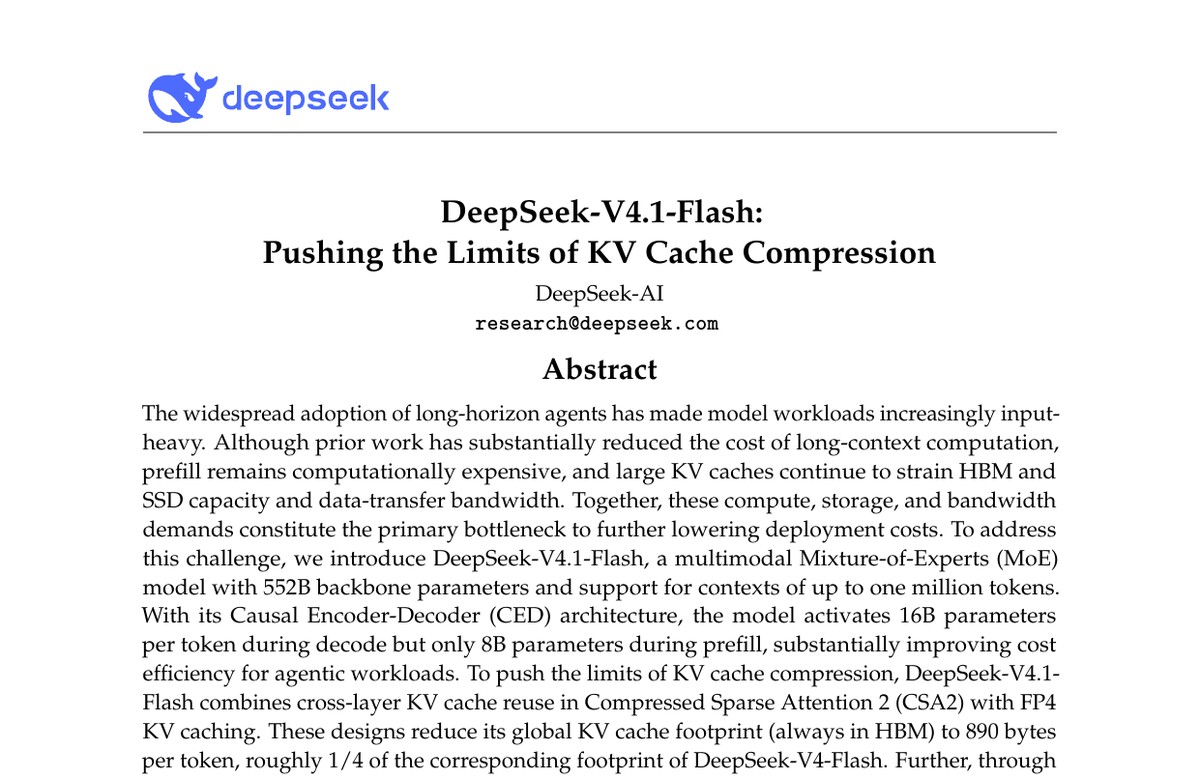 Figura: La portada del informe técnico subraya directamente «Llevando la compresión de la caché KV al límite», evidenciando el objetivo de ingeniería de recortar drásticamente los costes de inferencia en textos largos. Fuente: Informe técnico de DeepSeek-V4.1-Flash (Pushing the Limits of KV Cache Compression)
La evaluación en terminal sube 11,1 puntos: ahorrar caché permite iterar en depuración
Cabe preguntarse si obsesionarse con la compresión y la eficiencia económica compromete la inteligencia general del modelo. Al examinar la tabla comparativa de la ficha oficial en Hugging Face frente a la versión previa DS-V4.1-Flash, K3, GLM-5.3, GPT-5.6 Sol y el referente privativo Opus 5, se aprecia con claridad la dirección elegida. En el examen de conocimiento humano sin herramientas externas (HLE), el nuevo modelo alcanza 42,6 puntos, aún a cierta distancia de los 56,3 de Opus 5; en ProgramBench, centrado en programación algorítmica, asciende de 20,3 a 29,1 puntos, pero sigue por detrás de los 37,0 de Opus 5.
Sin embargo, cuando el escenario de pruebas cambia a tareas reales de ingeniería que demandan contextos extensos y llamadas recurrentes a herramientas, la tendencia se invierte. En Terminal-Bench 4.0 —utilizando Claude Code como marco de ejecución—, el modelo salta de 31,2 a 42,3 puntos. Esta mejora de 11,1 puntos lo acerca de inmediato a los 51,8 puntos de Opus 5. En DeepSWE v1.1, evaluación de ingeniería de software basada en Mini-SWE-V2, la puntuación pasa de 74,2 a 77,0 puntos; y en la prueba Agents’ Last Exam, firma 35,4 puntos, superando los 26,7 de GPT-5.6 Sol.
Asimismo, obtiene 68,2 puntos en NL2Repo-Bench para generación de repositorios, 60,5 en Automation-Bench v1.0.6 y 72,1 en Apex Bench v1.1; mientras que en evaluaciones asistidas por herramientas como Chartography y BabyVision registra 83,0 y 92,5 puntos respectivamente. ¿Por qué destaca tanto en tareas con terminal, repositorios y herramientas externas? Porque los agentes autónomos trabajan igual que un programador depurando errores: leen registros de error, examinan archivos históricos y ejecutan comandos una y otra vez. Con cada iteración, el contexto se duplica. En pruebas puntuales de razonamiento puro los buques insignia cerrados conservan su ventaja; pero en tareas iterativas de ingeniería que consumen contexto sin tregua, una caché KV económica permite al modelo triunfar a base de ensayo y error continuo.
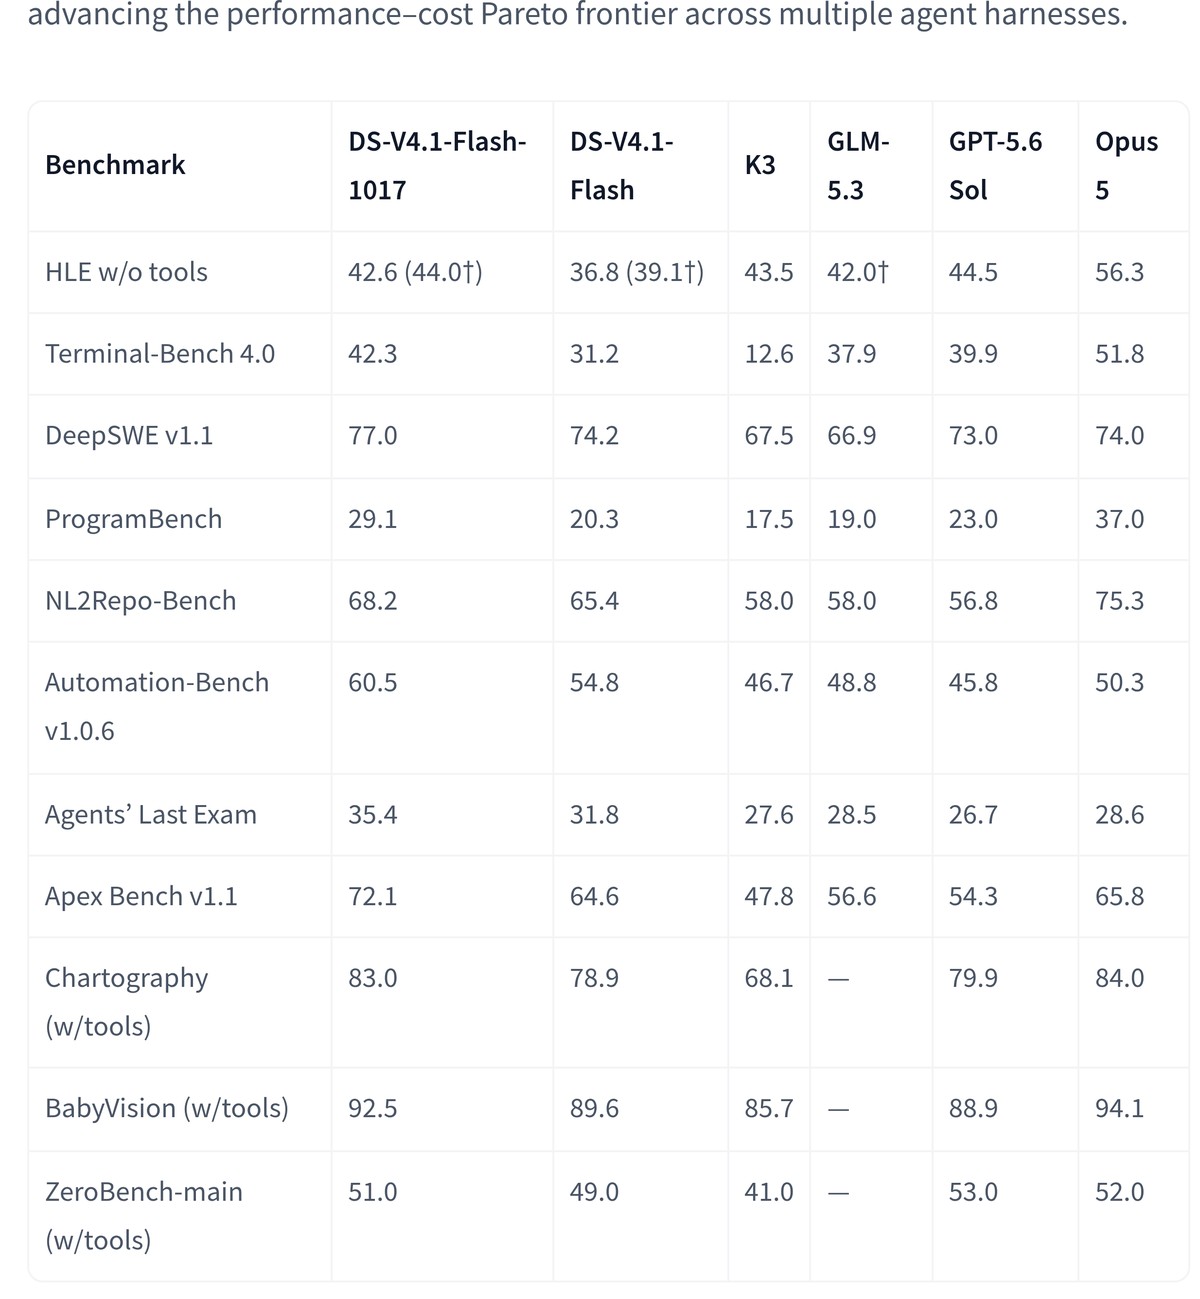 Figura: Comparativa de rendimiento en la ficha oficial; muestra las puntuaciones de V4.1-Flash-1017 frente a generaciones anteriores, K3, GLM-5.3, GPT-5.6 Sol y Opus 5. Fuente: Ficha de modelo en Hugging Face (DeepSeek-V4.1-Flash-1017)
Adiós a las plantillas Jinja: 19 cuantizaciones comunitarias toman el relevo del despliegue
Para garantizar llamadas a herramientas estables a lo largo de un millón de tokens, DeepSeek tomó una decisión tajante en su interfaz de ingeniería. Habitualmente, los modelos abiertos incluyen una plantilla de chat Jinja (un script que une las intervenciones mediante marcadores de texto). No obstante, cuando la conversación combina decenas de llamadas a herramientas y bloques extensos de código, la concatenación simple de cadenas provoca desajustes de formato con facilidad. El repositorio oficial ha prescindido de las plantillas Jinja y ha publicado en su lugar una implementación de referencia de encoding, encargada de transformar con exactitud las llamadas en formato Messages, Chat Completions y Responses en la estructura interna Conversation.
Al mismo tiempo, la ficha oficial ofrece una singular recomendación de muestreo: fijar tanto temperature (control de aleatoriedad del texto) como top_p (umbral del muestreo de núcleo) en 1.0. Quienes acostumbran a reducir la temperatura por precaución podrían extrañarse ante estos parámetros. Sin embargo, tras entrenar en contextos ultralargos, conservar la distribución de probabilidad nativa en 1.0 otorga al modelo la flexibilidad exploratoria indispensable para resolver depuraciones complejas en terminal sin quedar atrapado en callejones sin salida.
La reacción del ecosistema fue fulgurante. Aunque DeepSeek no habilitó servicios de inferencia alojados en Hugging Face, la comunidad de código abierto publicó por iniciativa propia 3 versiones con fine-tuning y 19 modelos cuantizados (que reducen la precisión numérica para achicar el modelo y permitir su ejecución en GPU domésticas). DeepSeek blindó el formato de los diálogos largos con un código de encoding riguroso, mientras la comunidad cubrió el despliegue con 19 cuantizaciones; el ecosistema abierto ha consolidado una vía práctica y accesible para llevar el modelo a producción.
Suscripciones de 20 dólares agotadas en minutos: la disciplina de ingeniería fija la factura
Una vez que la ventana de 1 millón de tokens y la caché KV comprimida llegaron a manos de los desarrolladores, el debate pasó rápidamente de «si cabe todo» a «cuánto aguantará el bolsillo». En los foros técnicos internacionales, las conversaciones se centraron casi en su totalidad en la contabilidad de costes. Varios profesionales calcularon que alimentar a un agente autónomo con repositorios enteros a pleno rendimiento agota una suscripción fija de 20 dólares mensuales en cuestión de minutos. Frente a esto, conectarse directamente a una API de pago por uso según el consumo real resulta a menudo más predecible y económico.
Al ampliarse la ventana y abaratarse el coste unitario, afloró otro coste oculto. Diversos ingenieros señalan que, aunque el modelo obtenga 77,0 puntos en DeepSWE v1.1 y repare código en la terminal por sí solo, el resultado sigue conteniendo patrones redundantes y casos límite imprevistos. Los desarrolladores senior siguen teniendo que invertir horas en revisar el código línea por línea, un coste humano imposible de eludir. En el pasado, con ventanas de pocos miles de palabras, los programadores se veían obligados a seleccionar con rigor los fragmentos pertinentes. Ahora, con un millón de tokens a su disposición, muchos han adquirido la costumbre de volcar proyectos enteros junto con requisitos vagos directamente en el prompt.
En la ingeniería de software rigen leyes de conservación: el esfuerzo previo que ahorras redactando prompts lo cobrarán más tarde las facturas de la API y las revisiones de código. DeepSeek-V4.1-Flash-1017 derriba la barrera de la longitud de contexto gracias a sus 763B parámetros y a una compresión extrema de la caché KV, pero no regala nada. La compresión de la caché KV transforma el millón de tokens de un alarde técnico en una herramienta de productividad cotidiana; eliminada la limitación de espacio, solo quienes sepan contener los envíos indiscriminados y mantener la disciplina de revisión de código aprovecharán de verdad las ventajas del contexto ultra largo.
Enlaces de referencia:
- Ficha de modelo en Hugging Face: DeepSeek-V4.1-Flash-1017
- Informe técnico de DeepSeek-V4.1-Flash (Pushing the Limits of KV Cache Compression)
- Debate en Hacker News