전체 코드 저장소나 수십 권의 두꺼운 전공 서적을 채팅창 하나에 통째로 밀어 넣는 일은 오랜 세월 소프트웨어 엔지니어들의 가장 사치스러운 환상이었다. 대형 언어 모델들이 규격상 100만 토큰의 창을 지원한다고 홍보해도, 천문학적인 VRAM 점유율과 연산 비용 청구서는 불과 몇 분 만에 예산을 바닥내기 일쑤였다. DeepSeek가 허깅페이스(Hugging Face)에 MIT 라이선스를 적용한 오픈소스 가중치 DeepSeek-V4.1-Flash-1017을 전격 공개했다. 763B(7,630억) 매개변수를 지닌 이 거대한 모델은 컨텍스트 창을 100만 토큰(텍스트 처리의 기본 단위로 한글 약 75만~100만 자 분량)까지 확장했다. 함께 공개된 기술 보고서는 제목에서부터 핵심 목표를 솔직하게 드러낸다. 바로 《DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression》(KV 캐시 압축의 한계를 밀어붙이다)이다.
지금껏 인공지능 기업들이 신규 모델을 내놓을 때면 박사급 지능을 뛰어넘었다는 벤치마크 점수에 모든 스포트라이트를 집중하곤 했다. 그러나 이번 DeepSeek는 화려한 점수 대신 다소 투박하고 건조한 캐시 압축 기술을 전면에 내세웠다. 이번 업데이트의 본질은 초장문 컨텍스트의 실질적 구동 비용을 바닥까지 끌어내린 데 있다. KV 캐시 압축 기술 덕분에 100만 토큰은 감당하기 힘든 전시용 기술에서 일상적인 실무 도구로 변모했으며, 개발자가 마주한 병목은 창의 길이에서 구동 비용과 엔지니어링 규율로 완전히 전환되었다.
 그림: DeepSeek 공식 저장소의 브랜드 로고. 이번에 출시된 V4.1-Flash-1017 역시 자유도 높은 MIT 오픈소스 라이선스를 유지한다. 출처: DeepSeek 공식 GitHub 저장소
KV 캐시의 한계를 쥐어짜다: 100만 토큰을 일상적 GPU 메모리에 담아내기
대형 언어 모델이 긴 글을 읽을 때 왜 이토록 많은 비용이 드는 것일까? 일반적인 독자는 책장을 넘기더라도 머릿속에 대략적인 줄거리만 남겨두면 그만이다. 하지만 언어 모델이 새로운 단어를 하나 생성하려면, 앞서 지나간 수십만 자에서 계산해 둔 내부 특징 벡터 전체를 GPU 메모리에 올려두고 대조해야 한다. 직전 문맥의 단서를 빠짐없이 기억하기 위해 전용으로 할당되는 이 메모리 공간을 바로 KV 캐시(Key-Value Cache; 추론 과정에서 이전 문맥을 유지하기 위해 저장하는 중간 상태)라고 부른다.
대화 길이가 수천 자에서 100만 토큰으로 팽창하면 KV 캐시가 차지하는 메모리 용량은 눈덩이처럼 불어난다. 그래픽 카드가 새로운 코드를 작성하기도 전에 이 거대한 과거 캐시를 메모리 버스에서 옮겨 나르는 작업만으로도 하드웨어 대역폭은 완전히 포화 상태에 이른다. 시중에 100만 토큰 지원을 내건 모델 상당수가 실제 호출 시 거북이처럼 느려지거나 단 한 번의 요청에 막대한 비용을 청구하는 이유가 여기에 있다. 중간 상태의 물리적 용량을 획기적으로 줄이지 않는 한, 초장문 컨텍스트는 언제나 발표 자료 속 시연용에 머물 수밖에 없다.
DeepSeek-V4.1-Flash-1017은 763B라는 거대한 매개변수 규모를 갖추었으면서도 핵심 화력을 바로 이 메모리의 장벽을 허무는 데 집중했다. 기술 보고서는 KV 캐시 압축의 물리적 한계를 집요하게 파고들었으며, 공식 모델 카드에서는 BF16, F32, F8_E4M3, I8의 4가지 가중치 정밀도 포맷을 기본으로 제공한다. KV 캐시 용량과 저정밀도 가중치를 동시에 압축한 것은 100만 토큰에 달하는 장기 기억의 체급을 가볍게 감량한 셈이다. 천문학적인 비용의 대규모 컴퓨팅 클러스터를 동원해야만 겨우 돌릴 수 있었던 100만 자 규모의 문맥 처리가 마침내 일상적으로 자주 호출할 수 있는 현실적 토대를 마련했다.
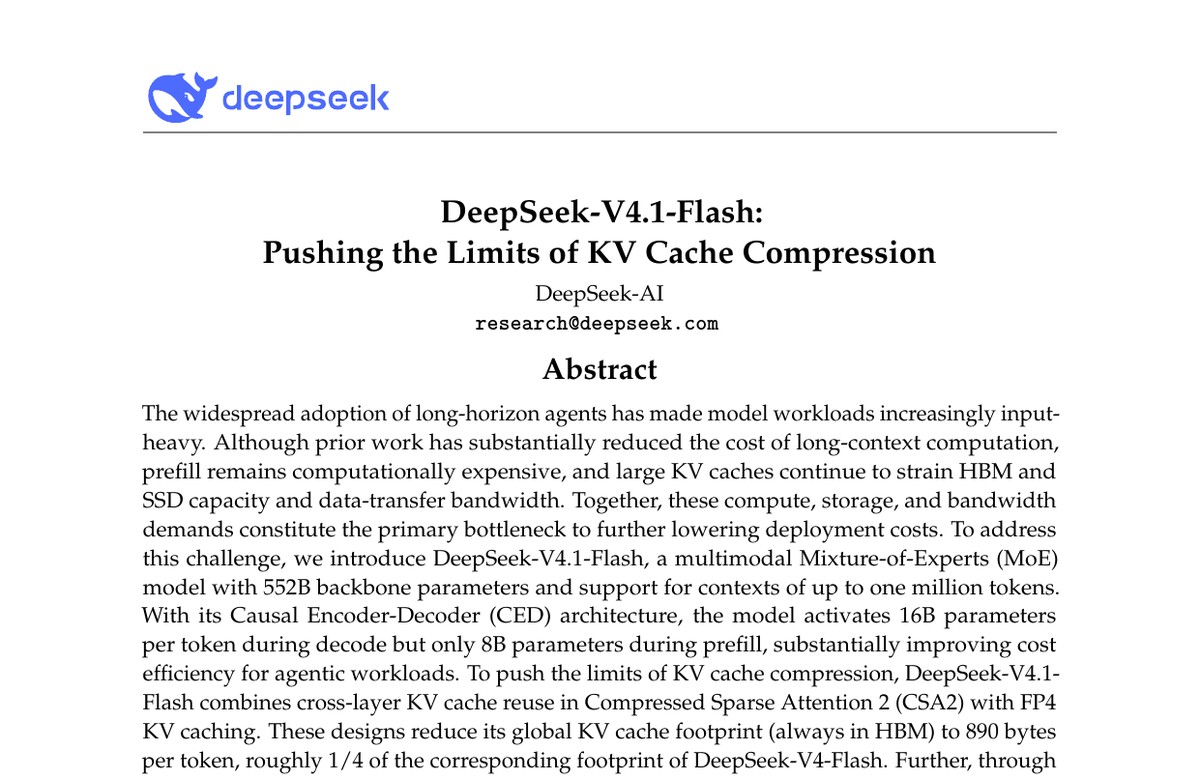 그림: 기술 보고서 첫 페이지는 “KV 캐시 압축의 한계를 밀어붙이다”라는 문구를 정면에 내세워 장문 추론 비용 절감이라는 핵심 공학 목표를 명확히 제시한다. 출처: DeepSeek-V4.1-Flash 기술 보고서(Pushing the Limits of KV Cache Compression)
터미널 벤치마크 11.1점 급상승, 캐시 절감이 가능하게 한 다회차 시행착오
캐시 압축과 추론 비용 절감에만 매달리다 보면 모델 본연의 지능이 떨어지지는 않았을까 하는 의문이 들 수 있다. 허깅페이스 공식 모델 카드의 벤치마크 지표를 통해 이전 세대인 DS-V4.1-Flash, K3, GLM-5.3, GPT-5.6 Sol, 그리고 폐쇄형 최고 모델인 Opus 5와 비교해 보면 명확한 개발 방향이 드러난다. 외부 도구를 쓰지 않는 순수 인간 지능 평가 HLE(Humanity’s Last Exam)에서 신규 모델은 42.6점을 기록해 Opus 5의 56.3점과는 여전히 격차가 있다. 알고리즘 코딩 능력을 측정하는 ProgramBench에서도 이전 버전의 20.3점에서 29.1점으로 상승했으나 Opus 5의 37.0점에는 미치지 못한다.
하지만 테스트 환경이 긴 문맥을 유지하며 지속적으로 도구를 호출해야 하는 실제 엔지니어링 작업으로 바뀌면 판도가 완전히 뒤집힌다. Claude Code를 실행 프레임워크로 사용하는 터미널 벤치마크 Terminal-Bench 4.0에서 신규 모델은 이전 버전의 31.2점에서 42.3점으로 크게 뛰어올랐다. 이 11.1점의 수직 상승을 통해 Opus 5의 51.8점을 턱밑까지 추격했다. Mini-SWE-V2 프레임워크 기반의 소프트웨어 공학 벤치마크 DeepSWE v1.1에서도 점수가 74.2점에서 77.0점으로 상승했으며, 에이전트 종합 평가인 Agents’ Last Exam에서는 35.4점을 획득해 GPT-5.6 Sol의 26.7점을 앞질렀다.
또한 전체 저장소 구축 테스트인 NL2Repo-Bench에서 68.2점, Automation-Bench v1.0.6에서 60.5점, Apex Bench v1.1에서 72.1점을 기록했다. 외부 도구를 결합한 Chartography와 BabyVision 테스트에서는 각각 83.0점과 92.5점이라는 높은 성적을 거두었다. 외부 도구를 다루고, 코드 저장소를 수정하며, 터미널 명령어를 실행하는 환경에서 이처럼 강세를 보이는 이유는 무엇일까? 자율 에이전트의 작업 방식은 버그를 잡는 프로그래머와 똑같이 오류 로그를 검토하고 이전 파일을 뒤적이며 외부 툴을 호출하는 과정을 끊임없이 반복하기 때문이다. 시행착오가 한 차례 늘어날 때마다 문맥은 기하급수적으로 길어진다. 단발성 최고 난도 추론 대결에서는 폐쇄형 주력 모델이 여전히 우위에 있지만, 문맥을 물 쓰듯 소비하는 반복 엔지니어링 작업에서는 저렴한 KV 캐시를 바탕으로 과감하게 잦은 시행착오를 거듭하는 오픈소스 모델이 실질적인 성과를 거둘 수 있다.
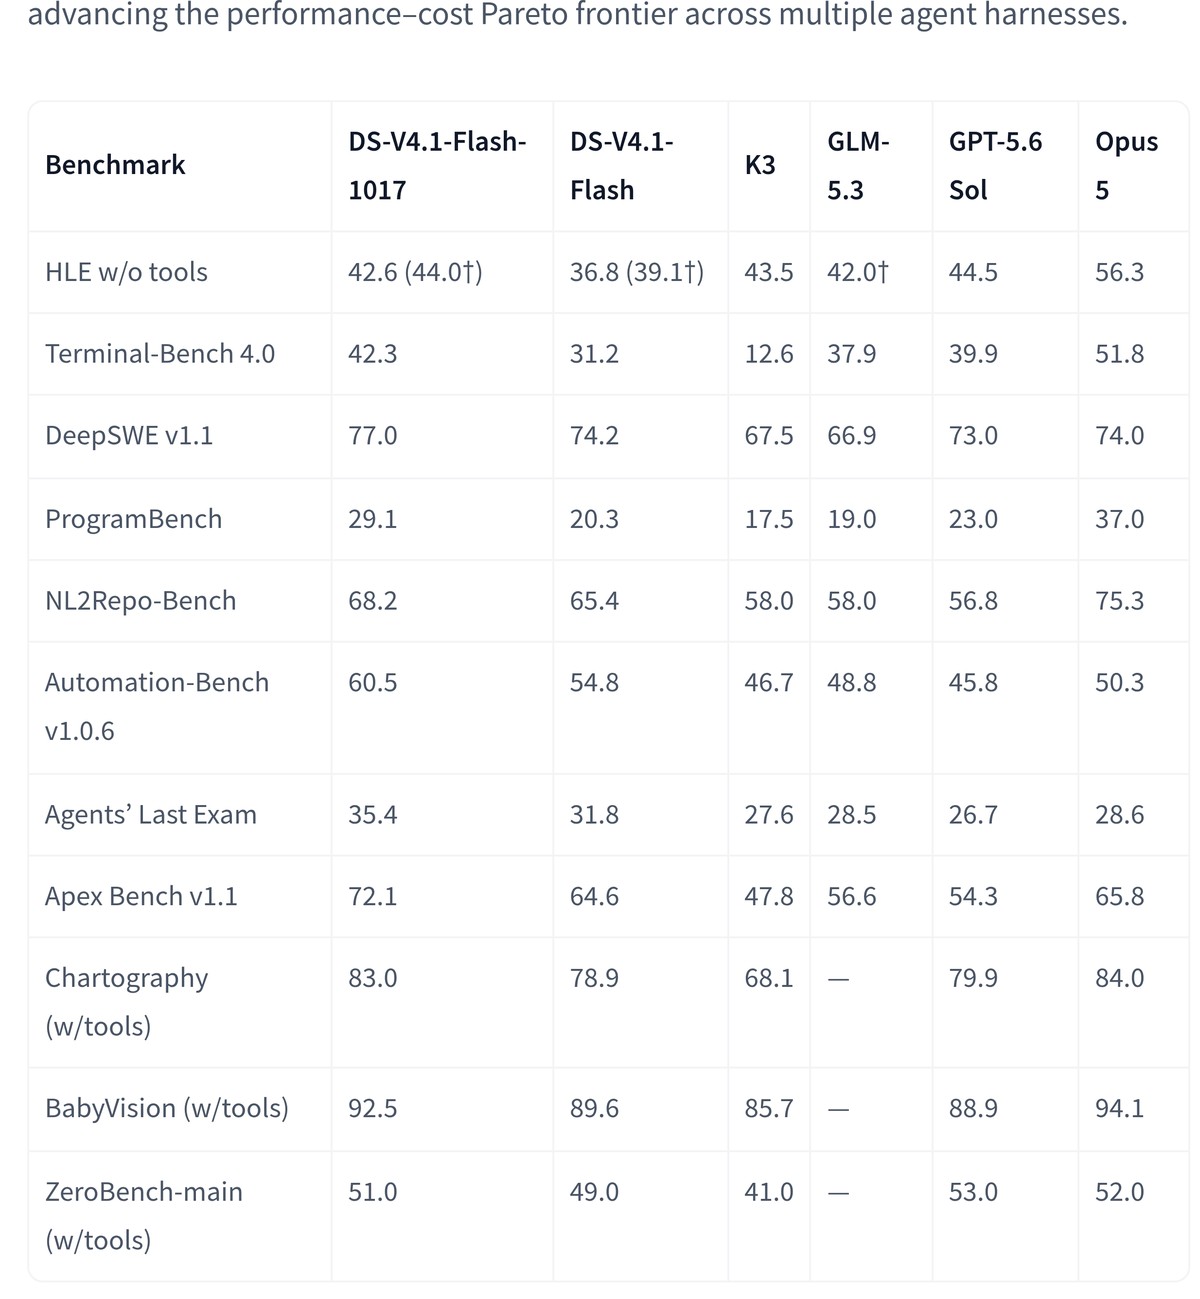 그림: 공식 모델 카드의 벤치마크 비교표. V4.1-Flash-1017과 이전 세대 및 K3, GLM-5.3, GPT-5.6 Sol, Opus 5의 각 평가 항목별 점수를 한눈에 보여준다. 출처: Hugging Face 모델 카드(DeepSeek-V4.1-Flash-1017)
Jinja 템플릿 제거, 커뮤니티의 19개 양자화 버전이 이끄는 실전 배포
100만 토큰에 이르는 장기 대화 속에서 안정적인 도구 호출을 보장하기 위해 DeepSeek는 엔지니어링 인터페이스 측면에서 과감한 결단을 내렸다. 기존 오픈소스 모델들은 대화 기록을 단순 문자열로 이어 붙이는 Jinja 템플릿 스크립트를 기본 제공하는 것이 관례였다. 하지만 대화 도중 수십 번의 도구 호출과 방대한 소스코드가 뒤섞이면 단순한 문자열 연결 방식은 규격 왜곡을 일으키기 십상이다. 이번 공식 저장소에서는 Jinja 템플릿을 완전히 걷어내고 Messages, Chat Completions, Responses의 3가지 표준 규격을 내부 Conversation 포맷으로 빈틈없이 변환하는 공식 encoding 참조 코드를 제공했다.
동시에 공식 모델 카드는 매우 흥미로운 샘플링 권장 설정을 제안했다. 텍스트 생성의 무작위성을 조절하는 temperature 값을 1.0으로 두고, 후보 단어의 확률 범위를 제한하는 top_p 역시 1.0으로 유지하라는 조언이다. 평소 안정적인 출력을 위해 온도를 낮추어 쓰던 개발자들에게는 다소 생소하게 느껴질 수 있다. 그러나 초장문 환경에서 심층 학습을 거친 모델의 경우 1.0 본연의 확률 분포를 유지하는 것이 복잡한 터미널 디버깅 과정에서 모델이 막다른 길에 갇히지 않고 유연하게 탐색을 지속하는 데 유리하다.
가중치 공개에 따른 생태계의 반응도 놀라울 만큼 빨랐다. DeepSeek 본사는 허깅페이스 페이지에 호스팅 기반 추론 서비스를 별도로 열지 않았지만, 오픈소스 커뮤니티가 자발적으로 3개의 파인튜닝 버전과 19개의 양자화 버전(수치 정밀도를 낮추어 모델 용량을 대폭 줄이고 저비용 GPU에서도 구동할 수 있도록 한 파생 모델)을 빠르게 등록했다. 공식 측은 빈틈없는 encoding 변환 코드로 장문 대화의 포맷 오류를 원천 차단했고, 커뮤니티는 19개의 양자화 모델로 연산 인프라의 공백을 발 빠르게 메웠다. 오픈소스 진영이 소프트웨어와 하드웨어를 아우르는 저비용 실전 배포 파이프라인을 구축해 낸 셈이다.
20달러 구독권이 몇 분 만에 증발하는 현실, 엔지니어링 규율이 최종 청구서를 좌우한다
100만 토큰의 창과 압축된 KV 캐시가 실제로 개발자들의 손에 쥐어지자, 논의의 무게중심은 “전체 코드가 다 들어가는가”에서 “지갑이 과연 버텨줄 것인가”로 급격히 옮겨갔다. 해외 개발자 커뮤니티의 반응 역시 대다수가 냉정한 비용 계산서에 집중되고 있다. 전체 저장소 코드를 통째로 밀어 넣고 자율 에이전트를 최대 속도로 돌릴 경우, 월 20달러 수준의 정액제 구독권은 불과 몇 분 만에 한도에 도달한다는 계산이 나온다. 오히려 사용한 토큰만큼만 정산하는 종량제 API를 직접 연동해 사용하는 편이 실질적인 비용 통제에 유리하다는 분석이다.
창이 넓어지고 단가가 저렴해지면서 또 다른 보이지 않는 비용도 수면 위로 드러났다. 현업 프로그래머들은 모델이 DeepSWE v1.1에서 77.0점을 기록하고 터미널에서 코드를 척척 고친다 하더라도, 출력된 코드 안에는 여전히 불필요한 군더더기 로직과 미처 검증되지 않은 예외 상황이 도사리고 있다고 지적한다. 결국 숙련된 엔지니어가 시간을 들여 한 줄 한 줄 코드를 검토해야 하며, 이러한 인건비는 모델이 아무리 발전해도 결코 줄어들지 않는다. 과거 컨텍스트가 수천 자에 불과했을 때는 개발자가 먼저 머리를 써서 핵심 코드 조각을 추려내야 했다. 그러나 100만 토큰의 문이 활짝 열리자 프로젝트 전체와 불명확한 요구사항을 무작정 AI에 던져 넣는 안이한 습관이 확산되고 있다.
소프트웨어 엔지니어링의 세계에서도 물리 법칙은 철저히 보존된다. 프롬프트를 다듬는 초반 노력을 모델 덕분에 아꼈다면, 부풀려진 API 청구서와 험난한 코드 리뷰 과정이 그 대가를 고스란히 되돌려 받게 된다. DeepSeek-V4.1-Flash-1017은 763B 규모와 한계까지 밀어붙인 KV 캐시 압축 기술을 통해 개발자 앞을 가로막던 컨텍스트 길이의 장벽을 통쾌하게 부수었다. 그러나 공짜 점심까지 만들어낸 것은 아니다. KV 캐시 압축은 100만 토큰을 호화로운 연산 과시용 기술에서 일상적인 생산성 도구로 끌어내렸다. 컨텍스트 크기의 제약이 사라진 지금, 무분별한 토큰 남용을 자제하고 사람 엔지니어의 엄격한 코드 검증 규율을 지켜내는 이들만이 진정한 초장문 기술의 혜택을 온전히 누릴 수 있을 것이다.
참고 링크:
- Hugging Face 모델 카드: DeepSeek-V4.1-Flash-1017
- DeepSeek-V4.1-Flash 기술 보고서(Pushing the Limits of KV Cache Compression)
- Hacker News 토론