Injecter d’un coup l’intégralité d’un dépôt de code ou une dizaine d’épais manuels techniques dans une interface de chat a longtemps constitué le fantasme le plus inaccessible des ingénieurs logiciels. Même lorsque les modèles affichaient sur le papier des fenêtres d’un million de mots, l’explosion de l’empreinte VRAM et les factures de calcul astronomiques asséchaient les budgets en quelques minutes. DeepSeek vient de mettre en ligne sur Hugging Face les poids de son modèle DeepSeek-V4.1-Flash-1017 sous licence MIT. Ce mastodonte fort de 763 milliards (763B) de paramètres porte la fenêtre de contexte à 1 million de tokens (l’unité élémentaire de segmentation du texte, soit environ 750 000 à 1 000 000 de mots). Le rapport technique qui l’accompagne annonce d’emblée la couleur dès son titre : DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression (Repousser les limites de la compression du cache KV).
Jusqu’ici, les laboratoires d’IA braquaient presque systématiquement leurs projecteurs sur des scores de référence prétendant surpasser les docteurs humains. Cette fois-ci, DeepSeek a accordé la première place à la mécanique ingrate de la compression de mémoire cache. L’enjeu central de cette mise à jour réside dans l’effondrement des coûts d’exploitation des contextes ultra-longs : la compression du cache KV transforme le million de tokens d’une pièce de musée intouchable en un instrument de travail quotidien ; le goulot d’étranglement des développeurs passe ainsi de la taille de la fenêtre à la maîtrise des coûts et à la discipline d’ingénierie.
 Figure : Logo officiel de DeepSeek sur son dépôt ; le nouveau V4.1-Flash-1017 continue d’adopter la licence open source permissive MIT. Source : Dépôt officiel GitHub de DeepSeek
Dompter les limites du cache KV : 1 million de tokens dans une mémoire GPU standard
Pourquoi la lecture de textes très longs par les modèles de langage coûte-t-elle si cher ? Lorsqu’un lecteur humain tourne une page, il ne conserve en tête qu’une idée générale de l’intrigue. En revanche, à chaque nouveau mot généré par un modèle de langage, celui-ci doit garder en mémoire VRAM les représentations internes calculées à partir de centaines de milliers de mots précédents afin de les comparer. Cet espace de mémoire graphique dédié à mémoriser l’historique de la conversation s’appelle le cache KV (Key-Value cache ; les états intermédiaires conservés par le modèle pendant l’inférence pour garder la trace du contexte antérieur).
Lorsque l’échange enfle de quelques milliers de mots à 1 million de tokens, l’espace mémoire accaparé par le cache KV grossit comme une avalanche. Avant même que la carte graphique ne commence à écrire la moindre ligne de code, le simple transfert de cette montagne de données historiques à travers le bus sature totalement la bande passante matérielle. De nombreux modèles vantant une prise en charge du million de tokens deviennent en réalité lents comme des escargots ou facturent chaque requête à prix d’or. Les lois de la physique ne mentent pas : sans réduction radicale du volume de ces états intermédiaires, le contexte ultra-long restera cantonné aux diapositives de présentation.
DeepSeek-V4.1-Flash-1017, malgré ses 763 milliards de paramètres, a pointé l’essentiel de son artillerie sur ce mur de mémoire. Le rapport technique s’attaque frontalement aux limites de compression du cache KV, tandis que la fiche officielle du modèle met d’emblée à disposition quatre formats de précision : BF16, F32, F8_E4M3 et I8. Comprimer de concert le volume du cache KV et les poids à basse précision revient à alléger drastiquement l’empreinte mémoire d’un contexte de 1 million de tokens. Des flux de travail qui exigeaient auparavant des supercalculateurs hors de prix reposent désormais sur une base matérielle viable pour un usage intensif et régulier.
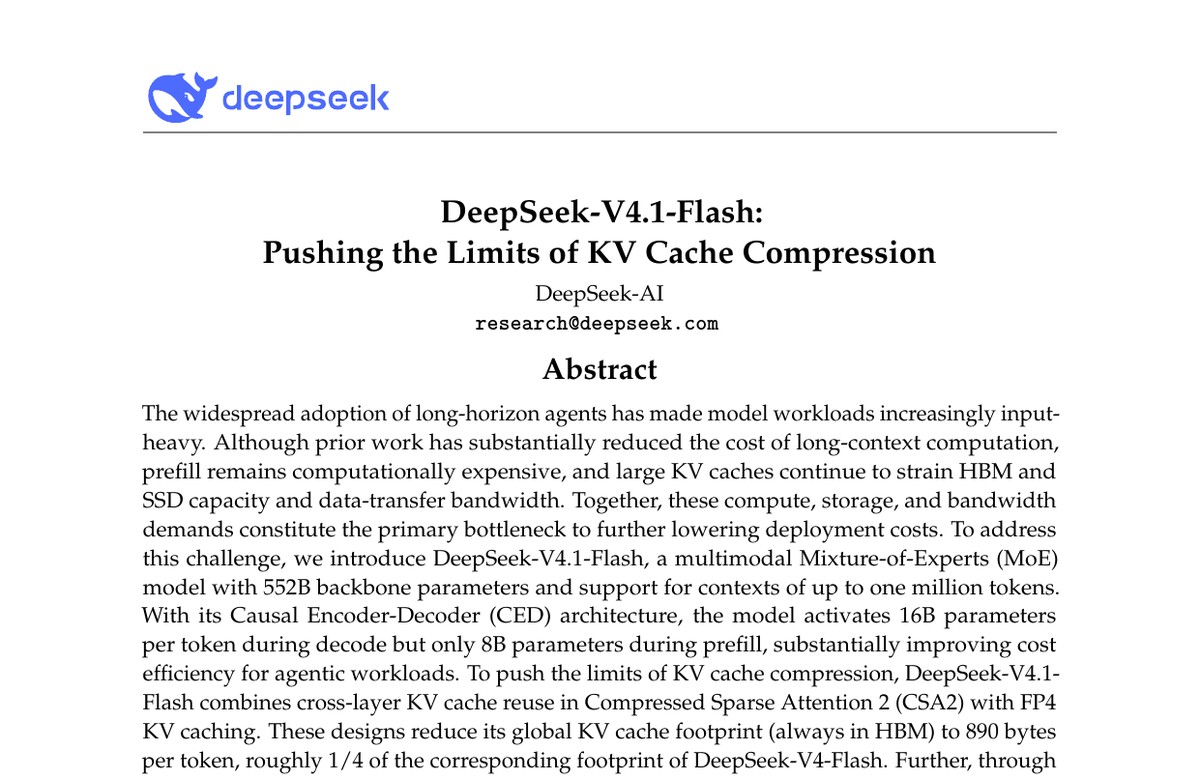 Figure : La première page du rapport technique met directement en exergue « Pushing the Limits of KV Cache Compression », affirmant l’objectif d’ingénierie prioritaire : réduire les coûts d’inférence sur textes longs. Source : Rapport technique DeepSeek-V4.1-Flash (Pushing the Limits of KV Cache Compression)
Les benchmarks de terminal bondissent de 11,1 points : économiser du cache pour persévérer dans le débogage
Faut-il craindre qu’en concentrant tous ses efforts sur la compression et la réduction des coûts, le modèle n’ait perdu de sa vivacité intellectuelle ? La lecture du tableau comparatif sur la fiche Hugging Face, face aux versions précédentes DS-V4.1-Flash, K3, GLM-5.3, GPT-5.6 Sol et à la référence propriétaire Opus 5, éclaire précisément sa direction. Sur le test d’aptitude humaine sans outils HLE, le nouveau modèle signe un score de 42,6 points, encore distancé par les 56,3 points d’Opus 5. Sur ProgramBench, axé sur la programmation algorithmique, il progresse de 20,3 à 29,1 points, restant toutefois derrière les 37,0 points d’Opus 5.
Mais dès que l’évaluation bascule vers des tâches d’ingénierie réelles exigeant un contexte étendu et des appels d’outils répétés, la dynamique s’inverse. Sur Terminal-Bench 4.0 — qui utilise Claude Code comme environnement d’exécution —, le modèle passe de 31,2 à 42,3 points. Ce bond de 11,1 points le rapproche nettement des 51,8 points d’Opus 5. Sur DeepSWE v1.1, référence d’ingénierie logicielle s’appuyant sur Mini-SWE-V2, son score progresse de 74,2 à 77,0 points. Enfin, dans l’épreuve Agents’ Last Exam, il décroche 35,4 points, dépassant nettement les 26,7 points de GPT-5.6 Sol.
Par ailleurs, il obtient 68,2 points sur NL2Repo-Bench pour la création de dépôts, 60,5 points sur Automation-Bench v1.0.6 et 72,1 points sur Apex Bench v1.1. Sur les bancs d’essai avec outils Chartography et BabyVision, il affiche respectivement 83,0 et 92,5 points. Pourquoi les performances sont-elles aussi remarquables sur ces tâches exécutées en terminal et modifiant des bases de code ? Parce qu’un agent autonome agit exactement comme un développeur qui traque un bug : il lit les journaux d’erreurs, fouille les anciens fichiers et lance des commandes externes, tour après tour. À chaque tentative, le contexte se démultiplie. Si les fleurons fermés conservent l’avantage sur les énigmes abstraites en un seul coup, le cache KV économique permet aux modèles ouverts de triompher des défis d’ingénierie complexes par l’expérimentation et l’erreur répétées.
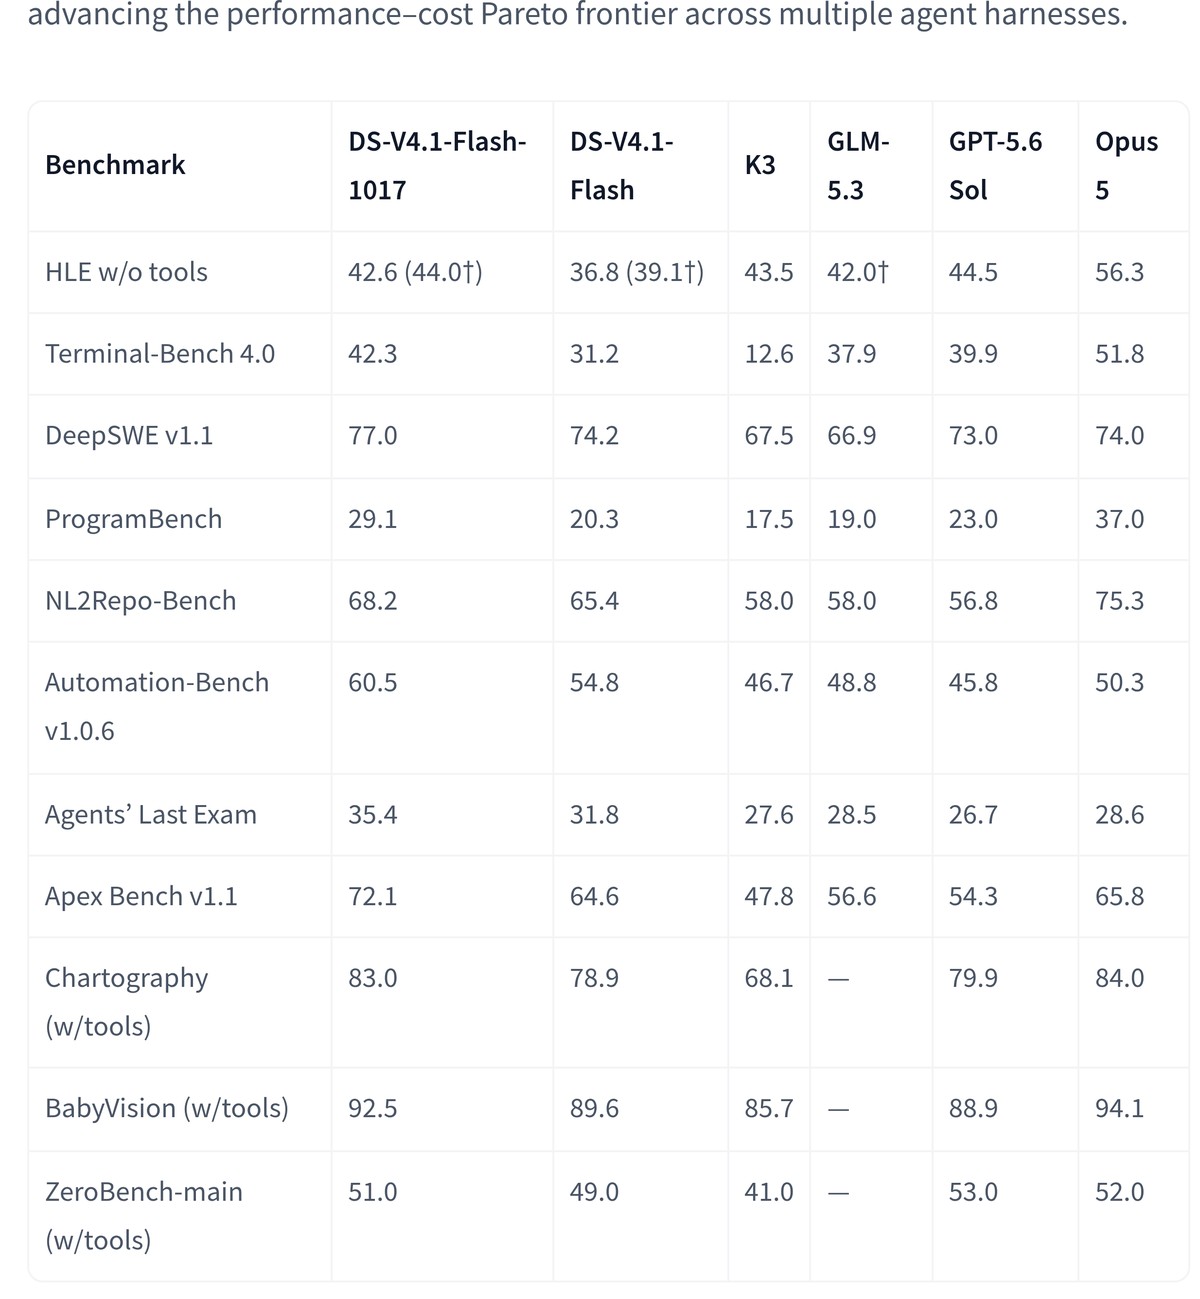 Figure : Comparatif de benchmarks de la fiche officielle ; confrontation des scores de V4.1-Flash-1017 face aux générations antérieures, K3, GLM-5.3, GPT-5.6 Sol et Opus 5. Source : Fiche de modèle Hugging Face (DeepSeek-V4.1-Flash-1017)
Abandon des modèles Jinja : 19 quantifications communautaires prennent le relais du déploiement
Afin de préserver la fiabilité des appels d’outils au fil de conversations de plus d’un million de tokens, DeepSeek a opéré une simplification radicale de son interface. Les modèles open source sont d’ordinaire distribués avec des templates de chat Jinja (des scripts utilisant des balises pour concaténer les tours de parole en une chaîne de texte). Or, lorsque des dizaines d’appels d’outils et de longs fragments de code s’entremêlent, une simple concaténation de chaînes engendre fréquemment des dérives de formatage. DeepSeek a donc purement et simplement écarté les templates Jinja au profit d’une implémentation de référence encoding, chargée de traduire sans faille les formats Messages, Chat Completions et Responses dans la structure native Conversation.
Parallèlement, la fiche officielle suggère une recommandation d’échantillonnage atypique : fixer à la fois la temperature (qui régit le caractère aléatoire du texte) et le top_p (seuil de filtrage probabiliste) à 1.0. Les développeurs habitués à baisser la température par mesure de précaution pourront s’en étonner. Pourtant, après un entraînement sur contextes géants, conserver la distribution de probabilité native à 1.0 offre au modèle la souplesse d’exploration requise pour dénouer des débogages complexes en terminal sans s’enfermer dans une impasse.
L’écosystème a réagi immédiatement. Bien que DeepSeek n’ait pas mis en place d’inférence hébergée sur sa page Hugging Face, la communauté open source a spontanément publié 3 versions affinées et 19 déclinaisons quantifiées (réduisant la précision numérique pour alléger le modèle et permettre son exécution sur des cartes graphiques grand public). DeepSeek a verrouillé les dérives de format des longues conversations avec un code d’encodage rigoureux, tandis que la communauté a comblé le besoin de calcul avec 19 versions quantifiées. L’écosystème libre dispose désormais d’un pipeline complet et économique pour passer en production.
Un abonnement à 20 dollars évaporé en quelques minutes : la discipline d’ingénierie dicte la facture
Une fois la fenêtre de 1 million de tokens et le cache KV compressé mis à la disposition des développeurs, les discussions ont rapidement délaissé la question de la faisabilité pour se focaliser sur celle du budget. Sur les forums techniques internationaux, les échanges portent presque exclusivement sur le coût d’usage. Plusieurs praticiens ont fait le calcul : alimenter des boucles d’agents autonomes avec des bases de code entières épuise un abonnement mensuel standard de 20 dollars en seulement quelques minutes à plein régime. Passer directement par des API facturées au jeton consommé s’avère bien plus contrôlable et économique.
Avec des fenêtres agrandies et un coût unitaire en baisse, un autre coût masqué a fait son apparition. De nombreux ingénieurs chevronnés soulignent que, même si le modèle obtient 77,0 points sur DeepSWE v1.1 et sait corriger du code en terminal de manière autonome, sa production recèle encore des redondances logiques et des cas limites négligés. Les développeurs seniors doivent toujours consacrer du temps à relire le code ligne à ligne, un coût humain irréductible. À l’époque où les fenêtres ne comptaient que quelques milliers de mots, les programmeurs prenaient soin de sélectionner en amont les extraits pertinents. Aujourd’hui, face à une porte ouverte sur 1 million de tokens, beaucoup prennent le réflexe paresseux de jeter des projets entiers et des spécifications floues dans le prompt.
Les lois de conservation s’appliquent à l’ingénierie logicielle : l’effort initial économisé lors de la rédaction du prompt se paiera plus tard sur la facture d’API et lors des revues de code. DeepSeek-V4.1-Flash-1017 brise la barrière de la longueur de contexte grâce à ses 763B paramètres et à une compression extrême du cache KV, mais il n’invente pas de repas gratuit. La compression du cache KV fait passer 1 million de tokens d’une démonstration de force coûteuse à un véritable levier de productivité quotidienne. Maintenant que le plafond de contexte s’efface, seuls ceux qui sauront éviter le gavage aveugle de données et maintenir une stricte discipline de relecture tireront pleinement parti du contexte ultra-long.
Liens de référence :
- Fiche de modèle sur Hugging Face : DeepSeek-V4.1-Flash-1017
- Rapport technique DeepSeek-V4.1-Flash (Pushing the Limits of KV Cache Compression)
- Discussion sur Hacker News