把整座代码仓库或十几本厚书一次性塞进聊天框,曾是软件工程师最奢侈的幻想;即便大模型账面上开放了百万字窗口,高昂的显存消耗与算力账单也会在几分钟内榨干预算。DeepSeek 在 Hugging Face 上放出了采用 MIT 许可证的 DeepSeek-V4.1-Flash-1017 模型权重;这个拥有 763B(7630 亿)参数的庞然大物,把上下文窗口拉到了 100 万 token(文本处理的基本切分单元;约合 75 万到 100 万汉字)。配套技术报告更是在标题里亮出了底牌:《DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression》(把 KV 缓存压缩推到极限)。
以往厂商宣传新模型,总爱把聚光灯打在超越人类博士的极限跑分上;这次 DeepSeek 却把头版位置留给了枯燥的缓存压缩技术。本次更新的主角在于把长上下文的运行成本压下来;KV 缓存压缩让 100 万 token 从用不起的展品变成日常工具;开发者的瓶颈随之从窗口长度转到成本与工程纪律。
 图:DeepSeek 官方仓库中的品牌标志;本次发布的 V4.1-Flash-1017 继续沿用宽松的 MIT 开源许可。来源:DeepSeek 官方 GitHub 仓库
压榨 KV 缓存极限,100 万字长文塞进日常显存
为什么大模型读长文章会这么贵?普通读者看书时,翻过一页只需在脑海里留个大概印象;大模型生成每一个新字时,却要把前面几十万字算出的内部特征全部留在显存里比对。这块用来死记硬背前文线索的专属显存空间,就叫 KV cache(键值缓存;即模型在推理时记住前文用的中间状态)。
当对话长度从几千字膨胀到 100 万 token 时,KV 缓存占用的显存体积会像滚雪球一样暴涨;显卡还没开始写新代码,光是在显存里搬运这堆历史缓存,就已经把硬件带宽堵得水泄不通。市面上不少号称支持百万上下文的模型,实际调用时要么响应慢如蜗牛;要么单次请求贵得让人肉疼。物理规律摆在那里:不把中间状态的体积压下来,长上下文就永远只能停留在演示幻灯片里。
DeepSeek-V4.1-Flash-1017 虽然有着 763B 的总参数规模,却把核心火力对准了这道显存高墙。技术报告直奔 KV 缓存压缩极限而去;官方模型卡中还直接提供了 BF16、F32、F8_E4M3 与 I8 四种权重精度格式。把 KV 缓存体积与低精度权重同步压下来,等于给 100 万 token 的超长记忆做了轻量化瘦身;原本需要天价算力集群才能塞下的百万字上下文,从此具备了日常高频调用的物理基础。
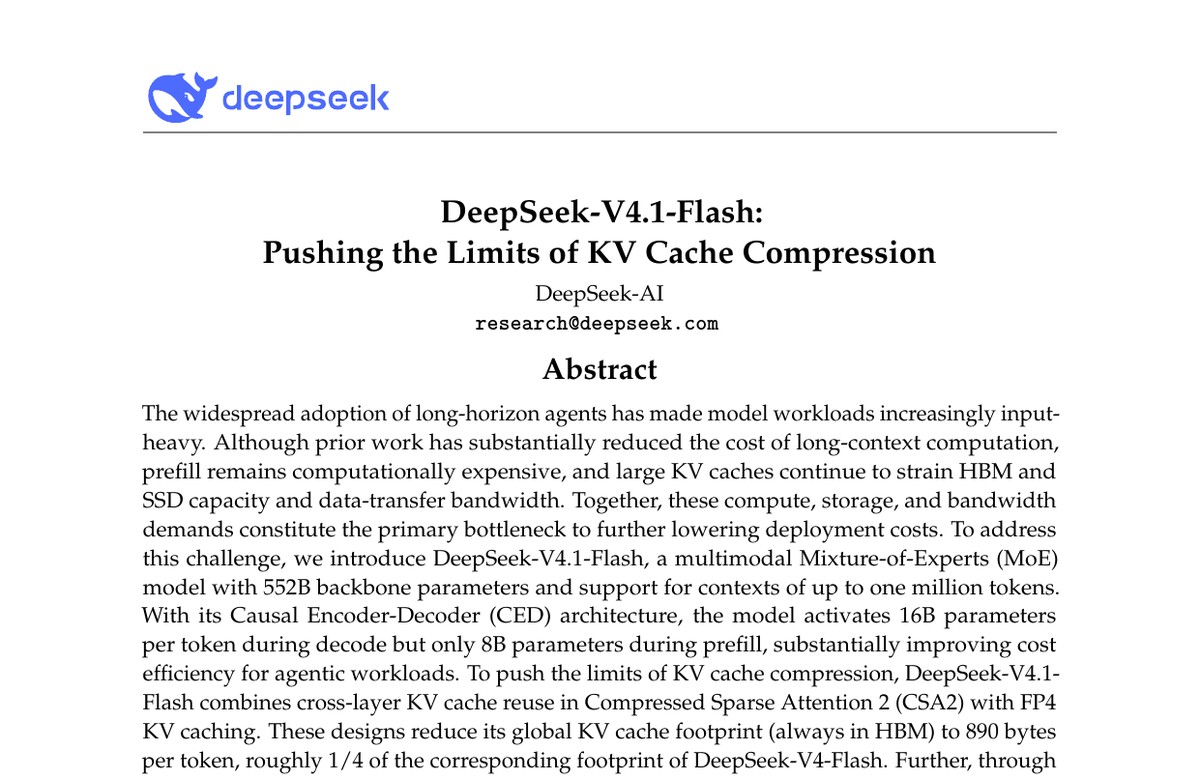 图:技术报告首页直接点明「把 KV 缓存压缩推到极限」;凸显长文本推理降本的核心工程目标。来源:DeepSeek-V4.1-Flash 技术报告(Pushing the Limits of KV Cache Compression)
终端跑分跳涨 11.1 分,省下缓存才能支撑多轮试错
有人会问,死磕缓存压缩和推理成本,模型的聪明程度会不会缩水?翻开 Hugging Face 官方模型卡的基准测试表;把新模型与上一版 DS-V4.1-Flash、K3、GLM-5.3、GPT-5.6 Sol 以及闭源标杆 Opus 5 放在一起对比,就能看清它的发力方向。在不使用工具的人类极限考试 HLE 中,新模型拿到 42.6 分,离 Opus 5 的 56.3 分仍有差距;在考察算法编程的 ProgramBench 上,新模型虽从上一版的 20.3 分涨到 29.1 分,依然排在 Opus 5 的 37.0 分之后。
一旦测试场景切换到需要长上下文、反复调用工具的工程任务,风向就变了。在以 Claude Code 作为执行框架的终端基准 Terminal-Bench 4.0 中,新模型从上一版的 31.2 分跳涨到 42.3 分;这 11.1 分的跃升,让它大步逼近了 Opus 5 的 51.8 分。在采用 Mini-SWE-V2 框架的软件工程基准 DeepSWE v1.1 上,它的得分也从 74.2 分推高至 77.0 分;到了 Agents’ Last Exam(智能体终极考试)测试里,新模型拿下 35.4 分,直接反超了 GPT-5.6 Sol 的 26.7 分。
此外,它在代码库构建测试 NL2Repo-Bench 中取得 68.2 分,在 Automation-Bench v1.0.6 拿到 60.5 分,在 Apex Bench v1.1 拿下 72.1 分;而在带工具的 Chartography 与 BabyVision 测试中,更是分别交出了 83.0 分和 92.5 分的成绩单。为什么这些带工具、改代码库、跑终端的任务表现如此抢眼?因为智能体干活就像程序员修 Bug,得一轮接一轮地读报错日志、翻历史文件、调外部工具;每多试错一轮,上下文就会成倍拉长。单次极限脑力比拼上闭源旗舰依旧占优;但在吃上下文如喝水的多轮工程任务里,廉价的 KV 缓存让模型敢于用高频试错换取最终胜利。
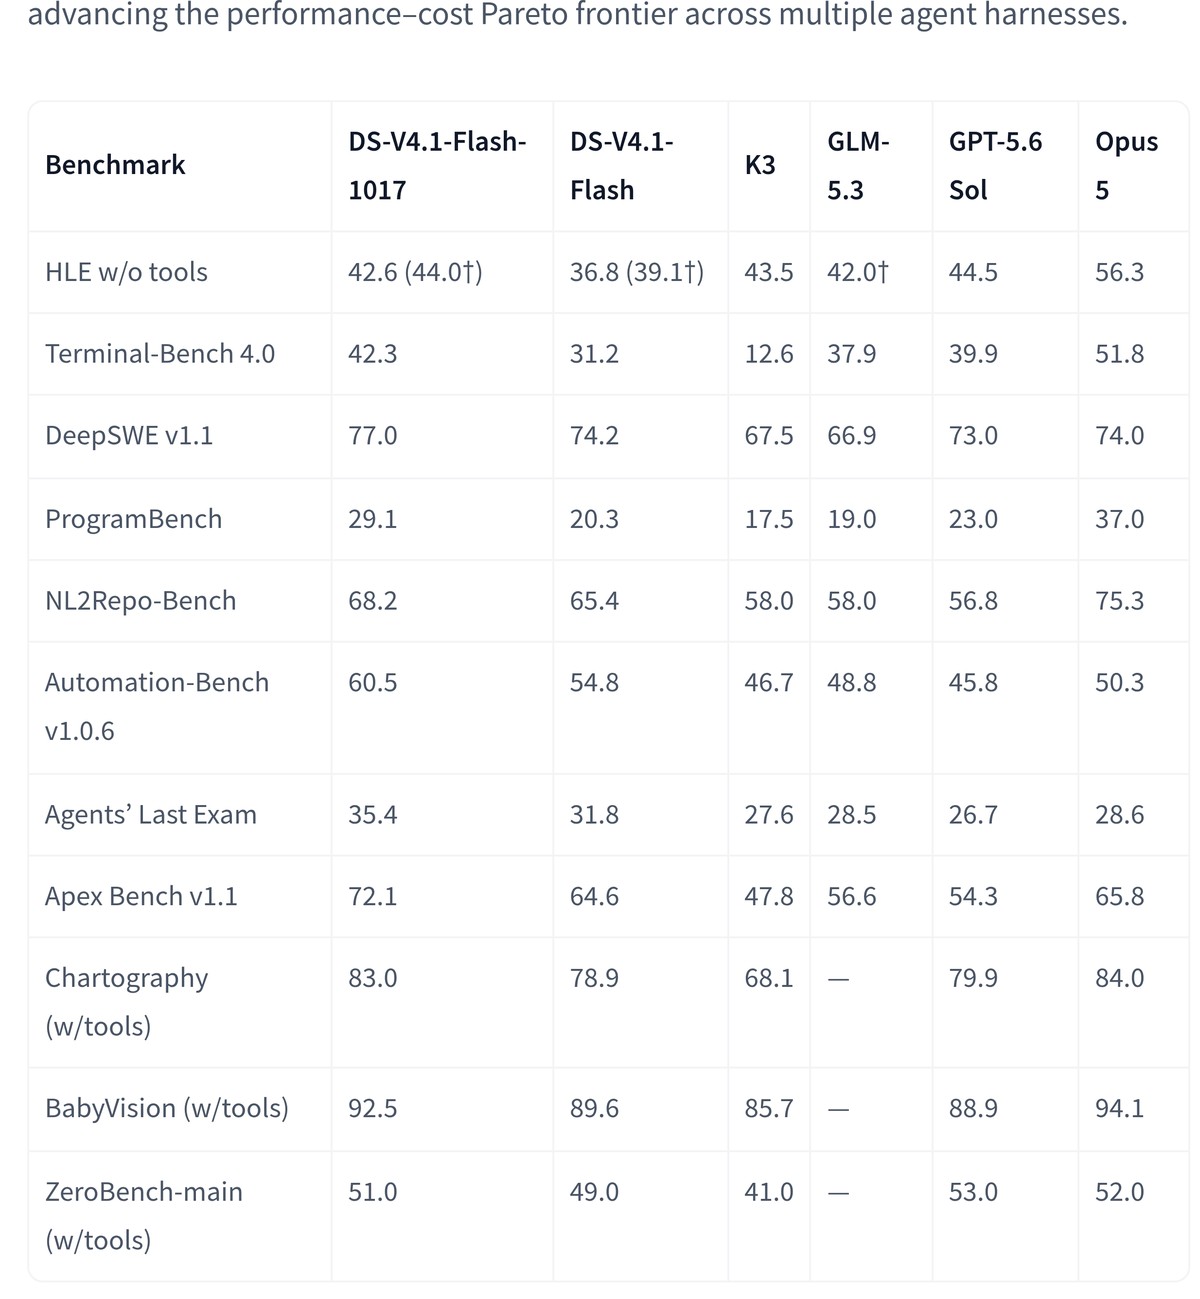 图:官方模型卡基准对比表;展示了 V4.1-Flash-1017 与前代版本及 K3、GLM-5.3、GPT-5.6 Sol、Opus 5 在各项任务上的得分对照。来源:Hugging Face 模型卡(DeepSeek-V4.1-Flash-1017)
抛弃 Jinja 模板,19 个社区量化版接管推理部署
为了让模型在百万字长程对话里保持稳定的工具调用,DeepSeek 在工程接口上做了一个果断的减法。以往开源模型发布时,都会附带一份 Jinja 对话模板文件(一种用文本占位符把多轮对话拼接成输入字符串的脚本);但当对话里混杂着几十轮工具调用与长篇代码时,简单的字符串拼接极易发生格式错位。这次官方仓库干脆不提供 Jinja 对话模板,转而放出了一套 encoding 参考实现;它专门负责把 Messages、Chat Completions 和 Responses 三种接口格式,严丝合缝地转成内部 Conversation 格式。
与此同时,官方模型卡给出了一个耐人寻味的采样建议:将 temperature(温度参数;控制生成文本的随机性)设为 1.0,同时将 top_p(核采样参数;控制候选词的概率筛选范围)也设为 1.0。不少习惯把温度调低以求稳妥的开发者看到这组参数会感到意外;但在长程环境训练后,保持 1.0 的原生概率分布,反而能让模型在百转千回的终端排错中维持探索弹性,避免陷入死胡同。
权重页面上的生态反应同样迅速:官方并未在 Hugging Face 模型卡页面挂载在线推理服务;开源社区却已经自发上架了 3 个微调版本与 19 个量化版本(通过降低数值精度来缩减模型体积、方便低成本显卡运行的衍生版本)。官方用严谨的 encoding 转换代码封堵了长对话的格式漏洞,社区则用 19 个量化版本迅速填补了算力分发空缺;开源生态已经搭起一套软硬接力的低成本落地管线。
20 美元订阅几分钟烧光,工程纪律决定最终账单
当 100 万 token 的窗口与压缩后的 KV 缓存真正交到开发者手里,讨论焦点迅速从「能不能塞进去」转到了「钱包能撑多久」。在海外开发者社区里,围绕新模型的讨论几乎全数落在成本账本上;有开发者算了一笔账,面对动辄几十万字的全库代码投喂与多轮智能体调用,20 美元档的固定月度订阅在全速运转下几分钟就会见底。相比之下,直接对接按量计费的 API(Application Programming Interface;即应用程序编程接口),按实际消耗付费反而更划算。
窗口变大、单价变便宜之后,另一种隐性成本也浮出了水面。多位一线程序员指出,即便模型在 DeepSWE v1.1 上拿到 77.0 分、能自己跑终端修补代码,它产出的代码依然夹杂着冗余逻辑与边界隐患;团队还是得安排经验丰富的开发者花时间逐行清理,这部分人力成本一分钱都省不掉。过去上下文只有几千字时,开发者被迫先自己动脑筋筛选关键代码片段;如今 100 万 token 的窗口敞开大门,不少人养成了一股脑把整个项目连同需求一起丢给 AI 的习惯。
物理规律在工程世界里总是守恒的:模型帮你省下了精简提示词的前期力气,账单和后期的代码审查就会把这笔债讨回来。DeepSeek-V4.1-Flash-1017 用 763B 参数和极限的 KV 缓存压缩,拆掉了横亘在开发者面前的上下文长度围墙;但它并没有发明免费的午餐。KV 缓存压缩把 100 万 token 从昂贵的算力炫技变成了日常生产力工具;当上下文容量不再卡脖子,谁能管住无脑投喂的调用账单、守住人类工程师的代码清理纪律,谁才能真正吃到长上下文的红利。
参考链接:
- Hugging Face 模型卡:DeepSeek-V4.1-Flash-1017
- DeepSeek-V4.1-Flash 技术报告(Pushing the Limits of KV Cache Compression)
- Hacker News 讨论