알고리즘 레시피는 그대로, 터미널 벤치마크 11.1점 수직 상승
2026년 10월 17일, DeepSeek는 V4.1-Flash-1017 가중치 스냅샷을 공개했다. 기술 보고서에서 개발팀은 새로운 알고리즘을 도입하지 않았으며 기존 최적화 레시피를 그대로 유지했다고 명확히 밝혔다. 그러나 터미널 환경 조작 능력을 평가하는 Terminal-Bench 4.0에서 이 마이너 버전의 점수는 31.2점에서 42.3점으로 껑충 뛰어올랐다.
11.1점의 격차는 판도를 바꾸어 놓았다. 동일한 평가군 내에서 Claude Opus 5는 여전히 Terminal-Bench 4.0, ProgramBench, NL2Repo, HLE 등에서 선두를 지켰지만, 1017 스냅샷은 DeepSWE v1.1, Automation-Bench, Agents’ Last Exam, Apex Bench 등 네 가지 항목에서 역전에 성공했다. 이 11점의 상승분에는 알고리즘 수정이 단 한 줄도 반영되지 않았다.
공식 발표에서는 이번 버전을 ‘소원 중심 프로그래밍(Wish-Driven Coding)‘이라 명명하며 엔드투엔드 소프트웨어 엔지니어링 구축을 핵심 가치로 내세웠다. 시연 사례로는 자금성 3D 모델링, 웹 기반 레이싱 게임 제작, Godot 엔진을 활용한 고전 명작 게임 복원 등이 포함되었다. 이전 세대 모델과 비교해 작업 완료 속도가 눈에 띄게 빨라졌고 출력 토큰 수도 대폭 줄어들었다. 불필요한 출력을 덜어냄으로써 다중 턴 대화에서 누적되던 지연 시간을 효과적으로 낮췄다.
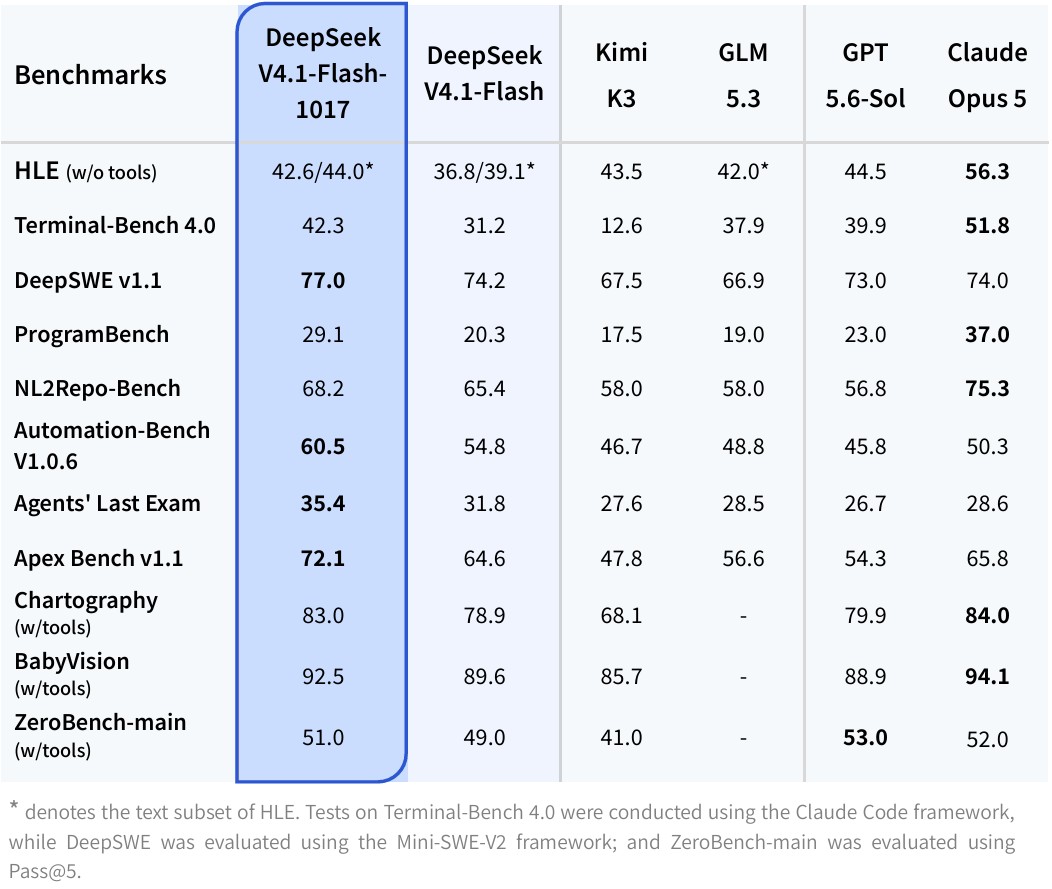 그림: 공식 벤치마크 비교표. 1017 스냅샷과 이전 버전 간의 항목별 격차. 출처: DeepSeek 공식 발표
다른 에이전트 평가 지표에서도 뚜렷한 상승세가 이어졌다. Claude Code 평가 환경에서 DeepSWE v1.1의 문제 해결률은 74.2%에서 77.0%로 향상되었다. ProgramBench는 20.3점에서 29.1점으로 상승했고, Apex Bench v1.1은 64.6점에서 72.1점으로 전진했다. 자동화 코딩 벤치마크의 상한선이 지속적으로 높아지고 있다.
한계 효용의 축이 환경 파이프라인으로 이동: 합성 작업이 견인하는 장기 추론
기술 보고서 5.1절에서는 벤치마크 점수 급상승의 배후에 자리한 엔지니어링 무게중심을 설명한다. 사후 학습 단계는 여전히 지도 미세조정(SFT), 강화학습(RL), 온폴리시(On-policy) 증류라는 표준 파이프라인을 그대로 따른다. 개발팀은 대신 연산 예산을 합성 작업 설계와 상호작용 환경 구축에 전폭적으로 투자했다.
보고서는 현 단계에서 데이터와 환경 파이프라인이 창출하는 한계 수익이 알고리즘 혁신을 크게 앞선다는 명확한 추론을 제시한다. 기존의 정적 수작업 라벨링 데이터는 복잡하고 긴 호흡의 상호작용 환경에서 급격히 한계에 부딪힌다. 터미널 조작에는 상태 롤백과 오류 포착이 빈번하게 요구되므로, 이를 뒷받침하기 위해 프로그래밍 방식으로 합성된 환경이 필수적이다.
개발팀은 자동화 파이프라인을 구축하여 다양하고 검증 가능한 상호작용 공간을 프로그래밍 방식으로 설계했다. 합성된 작업에는 엄격한 중복 제거 필터링과 난이도 캘리브레이션이 적용된다. 결과 검증이 가능한 작업 설정을 통해 강화학습 에이전트는 안정적인 보상 신호를 획득할 수 있었고, 정책 탐색 과정에서 발생하는 보상 해킹(Reward Hacking)을 방지했다.
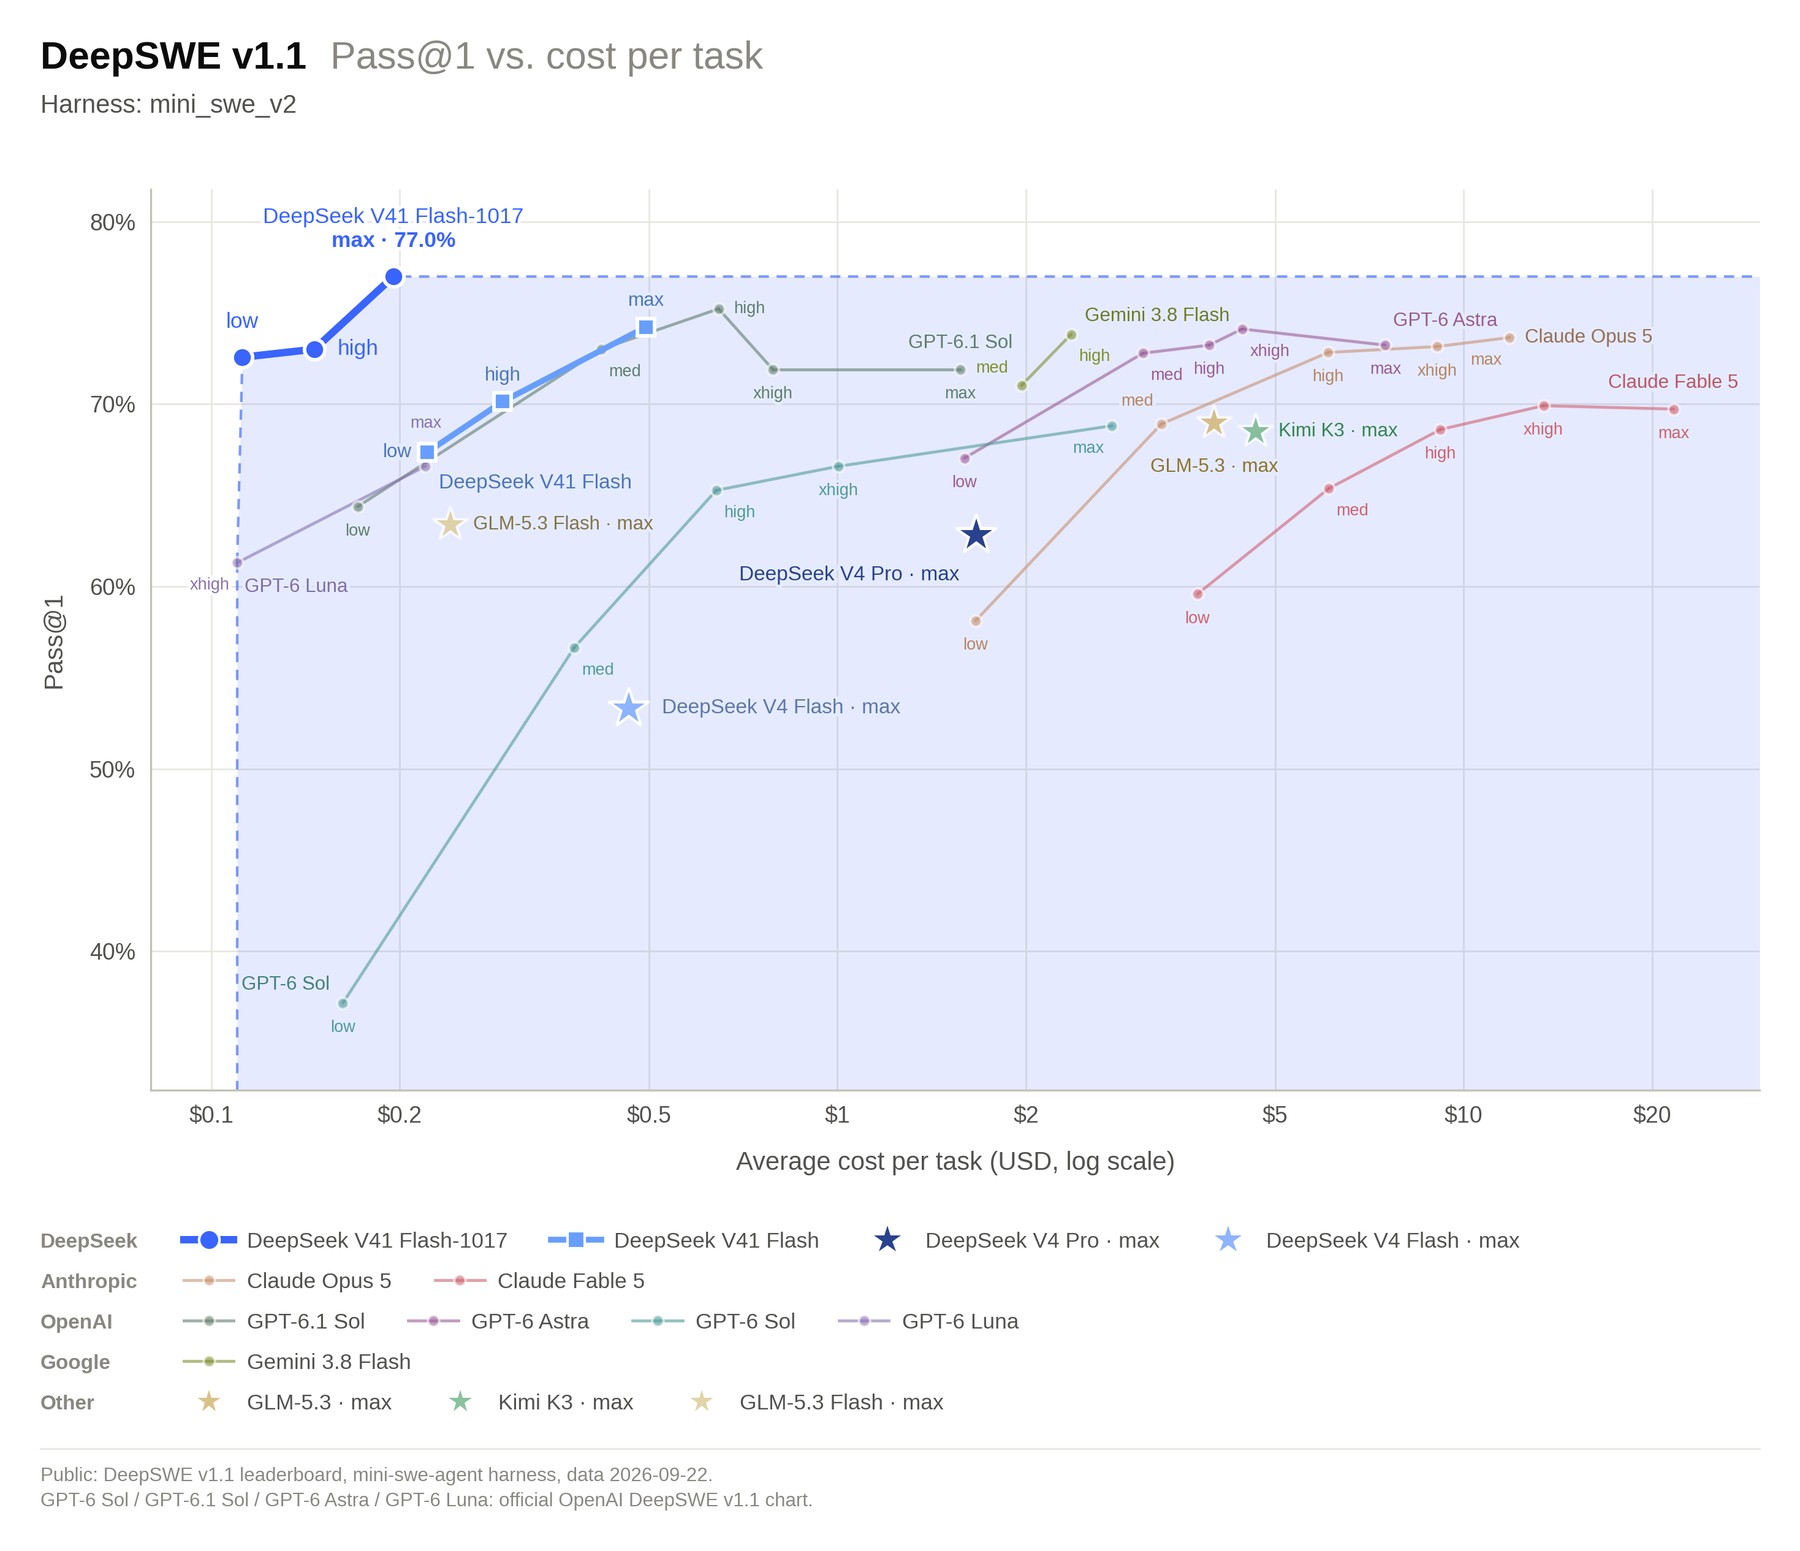 그림: 공식 성능 및 비용 곡선. DeepSWE v1.1 Pass@1 달성에 필요한 단일 작업 비용 추이. 출처: DeepSeek 공식 발표
멀티모달 벤치마크 지표 역시 이러한 환경 파이프라인의 효용을 입증한다. 도구 호출이 수반되는 Chartography 테스트에서 모델 점수는 78.9점에서 83.0점으로 뛰었다. BabyVision은 89.6점에서 92.5점으로 올랐고, ZeroBench-main도 49.0점에서 51.0점으로 향상되었다. 실제 환경과의 상호작용을 통해 획득한 역량 향상이 교차 모달 인지 작업으로 그대로 전이된 것이다.
토큰당 890바이트로 압축: KV 캐시가 구축한 비용의 최저선
에이전트 추론은 방대한 양의 컨텍스트를 소모한다. 도구 호출이 반복되면서 대화 기록은 쉼 없이 길어지며, 가장 먼저 병목을 겪는 지점은 그래픽 메모리 대역폭이다. 긴 컨텍스트가 기본 사양으로 자리 잡으려면 단위 캐시 비용을 한계까지 끌어내려야 한다.
V4.1-Flash의 아키텍처 설계는 하드웨어 수준에서 이를 든든하게 뒷받침한다. 총 552B 매개변수의 인과적 인코더-디코더 구조를 채택했으며, 사전 학습 단계에서 45T의 멀티모달 데이터를 학습했다. 디코딩 단계에서는 16B 매개변수만 활성화되고, 프리필 단계에서는 단 8B 매개변수만 활성화된다. 경량화된 프리필을 통해 첫 토큰 생성 지연 시간(TTFT)을 획기적으로 줄였다.
물리적 돌파구는 CSA2 어텐션 압축 기술과 FP4 캐시의 결합에서 나왔다. 레이어 간 재사용 설계를 통해 글로벌 KV 캐시 크기는 토큰당 단 890바이트 수준으로 압축되었다. 이는 이전 세대인 V4-Flash의 4분의 1에 불과하며, 1세대 아키텍처와 비교하면 무려 437분의 1 수준이다.
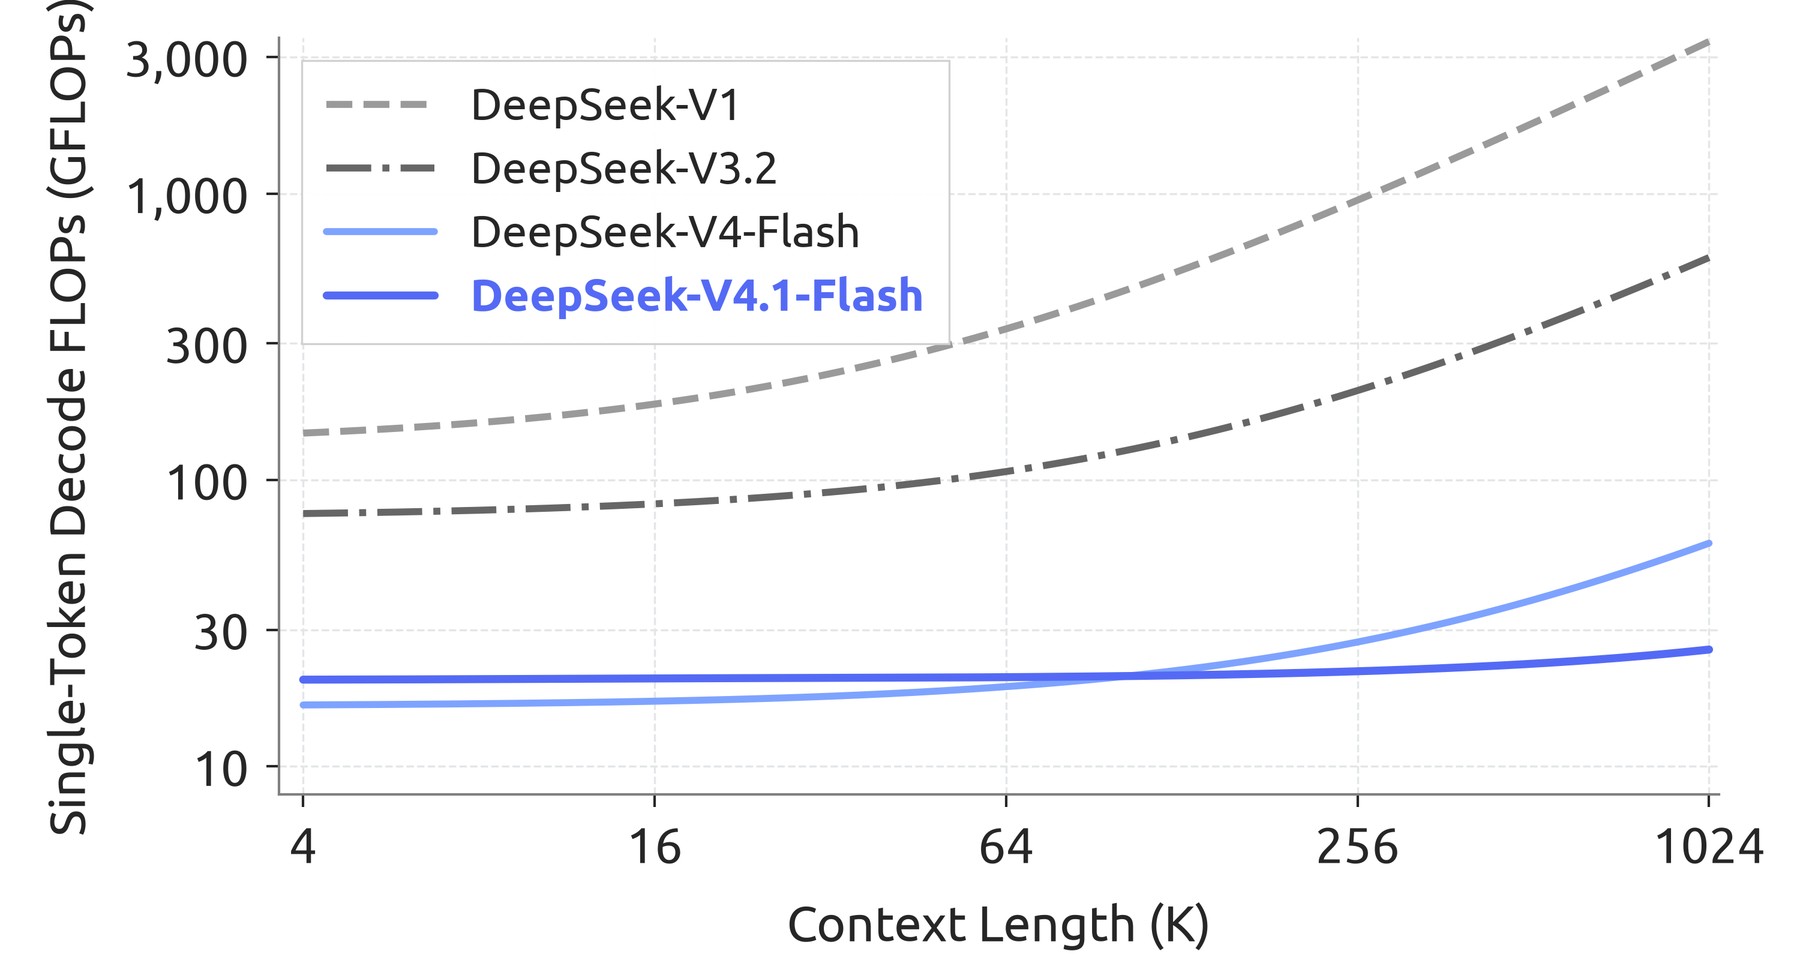 그림: 컨텍스트 길이가 1M까지 확장됨에 따라 단일 토큰 디코딩에 필요한 연산량 변화. 출처: DeepSeek-V4.1-Flash 기술 보고서
슬라이딩 윈도우 어텐션 경계 재생 메커니즘을 결합하여 영구 캐시 요구량도 이전 세대의 8분의 1로 줄어들었다. 연산 비용 곡선 역시 평탄하다. 컨텍스트가 4K에서 1M으로 256배 확장되는 동안, 단일 토큰 디코딩에 필요한 부동소수점 연산량은 고작 4분의 1(25%) 증가하는 데 그쳤다. 이로써 긴 컨텍스트는 값비싼 사치품에서 당연한 기본 옵션으로 탈바꿈했다.
Jinja 템플릿 폐기: 프롬프트 엔지니어링의 자리를 대체한 자동화 프로토콜
추론 비용의 극적인 하락은 상위 도구 생태계의 진화를 직접적으로 이끌어냈다. 호스팅 플랫폼인 OpenRouter에서 해당 모델의 입력 단가는 100만 토큰당 0.10달러로 책정되었다. 출력 단가는 0.50달러를 유지하며, 캐시 읽기 비용은 0.002달러라는 극저가 수준으로 낮아졌다.
DeepSeek는 자체 개발한 Search 및 Fetch API 인터페이스도 함께 개방했다. 매일 수억 건의 외부 요청을 처리하는 이 검색 인프라는 엔드포인트 호출 1,000회당 0.75달러에 제공된다. 공식 도구와 주요 코딩 어시스턴트 생태계에서는 2026년 10월 31일까지 무료 이용이 지원된다. 저렴한 실시간 검색 덕분에 에이전트는 사전 학습 시점의 지식 제약에서 완전히 해방되었다.
이번 릴리스에서는 전통적인 Jinja 템플릿 파일이 완전히 폐기되었다. 개발팀은 대신 자체 완결형 Python 레퍼런스 구현체와 Python 바인딩을 지원하는 Rust 코어 라이브러리를 제공한다. 이 파서는 멀티 턴 대화, 생각의 사슬(Chain-of-Thought) 흐름, 대화 도중 주입되는 시스템 메시지, 텍스트-이미지 혼합 마크업을 매끄럽게 처리한다. 저수준 라이브러리가 파싱을 전담하면서 포맷 불일치로 인한 오작동 위험을 원천 차단했다.
권장 샘플링 하이퍼파라미터에서도 명확한 철학이 드러난다. 샘플링 온도(Temperature)와 핵 샘플링 확률(Top-P)은 모두 1.0으로 설정되었으며, 최대 출력 시퀀스 길이는 최소 256K 토큰 이상을 요구한다. 100만 토큰에 달하는 윈도우 전반에서 모델은 장기적 제약 조건을 엄격히 준수해야 한다. 구조화된 통신 라이브러리의 도입은 다중 도구 호출 환경에서 템플릿 계층이 안고 있던 파싱 취약점을 깔끔하게 해소했다.
상호작용 환경이 가르는 분수령: 벤치마크 경쟁은 엔지니어링 처리량 싸움으로 회귀
1017 스냅샷이 전달하는 메시지는 매우 분명하다. 알고리즘 최적화에서 얻는 이익은 체감하고 있으며, 검증 가능한 환경의 규모를 키우고 데이터 교정 파이프라인을 탄탄하게 다지는 것만으로도 벤치마크 점수를 두 자릿수 끌어올릴 수 있다는 사실이다.
그리고 890바이트 수준의 캐시는 대규모 배포를 위한 실질적인 토대를 놓았다. 읽기 및 쓰기 비용이 사실상 무시할 수 있는 수준으로 떨어져야 고빈도 시행착오를 전제로 한 에이전트 시스템이 온전히 작동한다. 오픈소스 생태계의 승부처는 이미 모델 가중치 자체에서 환경 파이프라인과 시스템 간 유기적 결합으로 옮겨갔다. 검증 가능한 상호작용 환경을 더 낮은 비용으로 지속 공급할 수 있는 주체가 다음 인공지능의 성능 경계를 정의하게 될 것이다.
참고 링크:
- DeepSeek-V4.1-Flash-1017 공식 릴리스 공지 및 오픈소스 모델 가중치
- DeepSeek-V4.1-Flash 기술 보고서: Pushing the Limits of KV Cache Compression
- Terminal-Bench 4.0 및 DeepSWE v1.1 벤치마크 기술 규격
- Hacker News 커뮤니티 기술 토론 기록