C49D3608 86E70493 6A6678E1 139D26B7 819F7E90
위의 160비트 16진수 문자열은 전 세계 인터넷 보안을 지탱하는 타원곡선 P-256의 핵심 시드(seed) 매개변수다. 2026년 10월 15일, 독립 연구자 Filippo Valsorda가 내걸었던 36,864달러의 현상금을 Anthropic의 연구팀이 수령했다. 암호학계를 25년 동안 괴롭혀 온 시드 미스터리가 내부 연구 모델인 Claude에 의해 30분 만에 풀린 것이다. 상금 전액은 비영리 공익 단체 ISRG(Internet Security Research Group)에 기부되었다.
이번 발견의 진정한 가치는 탐색의 가설 공간을 전환했다는 데 있다. 암호학계는 지난 수십 년 동안 시드가 어떤 비밀 영어 문장의 해시값일 것이라 맹신했고, 이로 인해 20년이 넘는 시간 동안 엉뚱한 방향을 헤맸다. 연구 모델은 난수 생성 알고리즘 고유의 동작 특성에 주목하여, 10개 시드 총 1,600비트의 완벽한 재현 데이터를 통해 수학적 종지부를 찍었다.
25년 동안 엉뚱한 방향만 뒤졌다
2000년, NIST는 FIPS 186-2 표준에 ECDSA 곡선을 채택했다. 표준에는 P-192부터 P-521까지 총 5개의 소수체 곡선이 포함되었으며, 각 곡선마다 16진수 시드 값이 할당되었다. 알고리즘은 이 시드의 해시를 계산하여 곡선 매개변수를 유도하도록 설계되었다. 그러나 미국 국가안보국(NSA)이 제출한 이 핵심 시드들은 구체적인 유도 과정에 대한 설명 없이 발표되었다. 생성 기록이 완전히 결여된 블랙박스 상태는 곧바로 학계 전반에 깊은 불신을 불러일으켰다.
이후 가장 널리 퍼진 소문은 NSA 연구원 Jerry Solinas에 관한 것이었다. Solinas가 특유의 유머러스한 영어 문구를 골라 SHA-1 해시를 계산해 시드를 만들었다는 이야기였다. 하지만 2023년 Solinas가 세상을 떠나면서 구전으로 전해지던 단서는 출처를 검증할 수 없게 되었다. 학계는 막대한 연산 자원을 소모하며 단어 조합을 무차별 대입해 일치하는 해시 접두사를 찾으려 애썼다. 근거 없는 맹목적 추측에 귀중한 연구 역량을 허비한 셈이었다.
투명성 결여가 낳은 백도어 의혹은 시간이 흐를수록 눈덩이처럼 불어났다. 2015년 Neal Koblitz와 Alfred Menezes는 시드를 둘러싼 수십 년간의 의혹을 체계적으로 정리했고, 2017년 암호학자 Daniel J. Bernstein과 Tanja Lange는 시드 선정 과정에 약 70비트의 자유도가 존재함을 지적했다. 이론적으로 이는 취약한 곡선을 골라내기에 충분한 크기였다. 백도어 의혹은 10년 이상 사그라지지 않으며 표준 암호 체계에 대한 산업계의 신뢰를 갉아먹었다.
이 묵은 과제를 끝내기 위해 Filippo Valsorda는 36,864달러의 커뮤니티 현상금을 걸었다. 그는 대만의 패밀리마트 편의점에서 주사위 20개를 사 모아 ‘Geomys FIPS 140-3 엔트로피 소스’라는 굿즈를 만들며, 한 번에 던져 얻는 6^20(약 51.7비트)의 물리적 엔트로피로 표준 시드의 신비주의를 풍자하기도 했다. 생성 코드가 온전히 재현되지 않는 한 표준 체계에 대한 커뮤니티의 의심은 사라질 수 없었다.
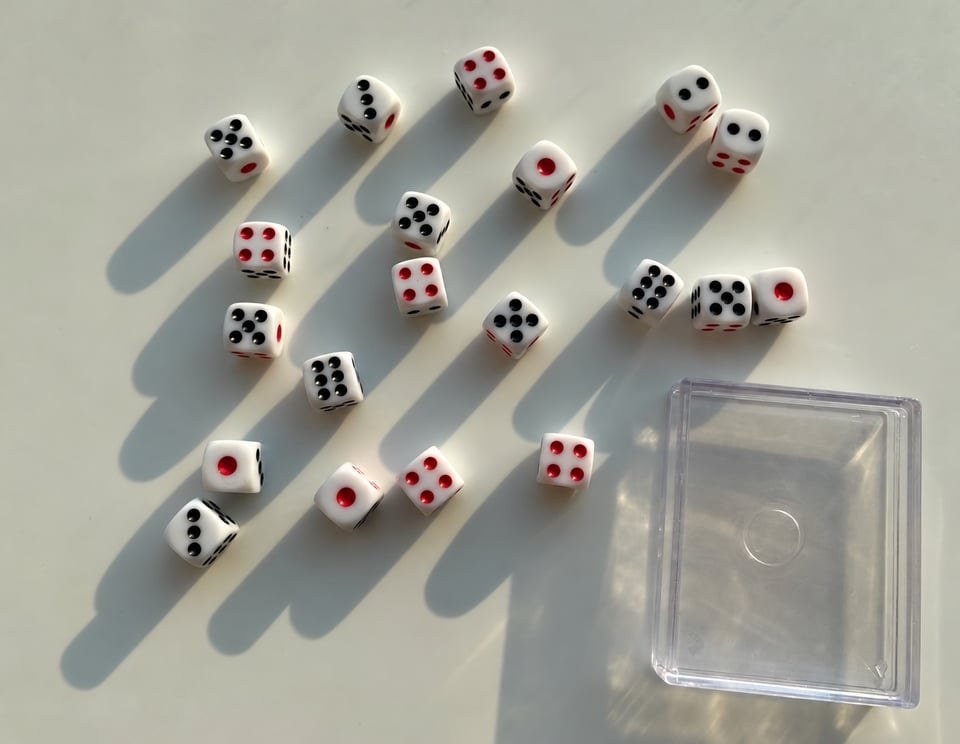 사진: 대만 패밀리마트 편의점에서 구입한 주사위 20개. 한 번 던지면 6^20(약 51.7비트)의 엔트로피를 얻는다. 출처: Filippo Valsorda
30분 만의 역산: 시드는 1997년 시스템 시계에서 나왔다
2026년 10월, Anthropic의 엔지니어들은 이 오랜 난제를 연구 모델 Claude에 전달했다. 프롬프트에는 어떠한 힌트도 주어지지 않았으며, 오직 밑바닥부터 시드의 기원을 추론하라는 지시만 담겼다. 뜻밖에도 모델은 30분도 채 되지 않아 해답을 찾아냈다. 문제 해결 속도가 획기적으로 향상된 비결은 난수 생성기 자체의 통계적 행동 지문을 대조하는 데 집중했기 때문이다.
Claude는 34종류의 의사난수 생성기(PRNG)와 출력 슬라이스 조합을 테스트하는 자동 스캐너를 직접 작성했다. 바이트 구조를 비교하는 과정에서 모델은 비정상적인 통계 지문을 포착했다. 공개된 10개의 시드를 각각 5개의 32비트 정수로 쪼개었을 때, 특정 4개 시드의 정수 20개 전체에서 최상위 비트(MSB)가 예외 없이 0이었던 것이다. 균등 난수 분포에서 이러한 특성이 나타날 확률은 5,810분의 1에 불과하다. 이 편향은 우연의 일치일 수 없으며, 생성 알고리즘 고유의 구조에서 비롯된 것이 분명했다.
이 통계 지문은 1990년대 유닉스 C 표준 라이브러리에 널리 탑재되었던 lrand48() 함수를 정확히 가리켰다. 이 함수는 48비트 내부 상태를 유지하지만, 한 번 호출할 때 상위 31비트만 반환한다. 반환값의 최상위 비트가 항상 0으로 채워지기 때문에 출력 배열에 선명한 서명을 남긴 것이다. 한 단계의 내부 상태를 복원하는 데는 공개되지 않은 하위 17비트만 대입해보면 충분했기에, 탐색 공간은 131,072가지 경우의 수로 급격히 줄어들었다.
더 복잡한 비트 절단 패턴을 가진 소수체 곡선 시드에 대해서는 격자 기저 축소(Lattice Basis Reduction) 풀이기를 즉석에서 구현했다. 절단된 선형 합동 생성기(LCG)의 상태 복원은 전형적인 격자 문제에 속한다. 모델은 다양한 절단 구간에 대해 기저 축소 연산을 차례로 수행했다. 계산 결과 10개의 시드 모두 lrand48() >> 23이라는 절단 패턴을 정확히 따르고 있음이 밝혀졌다. 복원된 48비트 내부 상태는 각각 대응하는 시드의 160비트 데이터 전체를 완벽하게 재현해냈다.
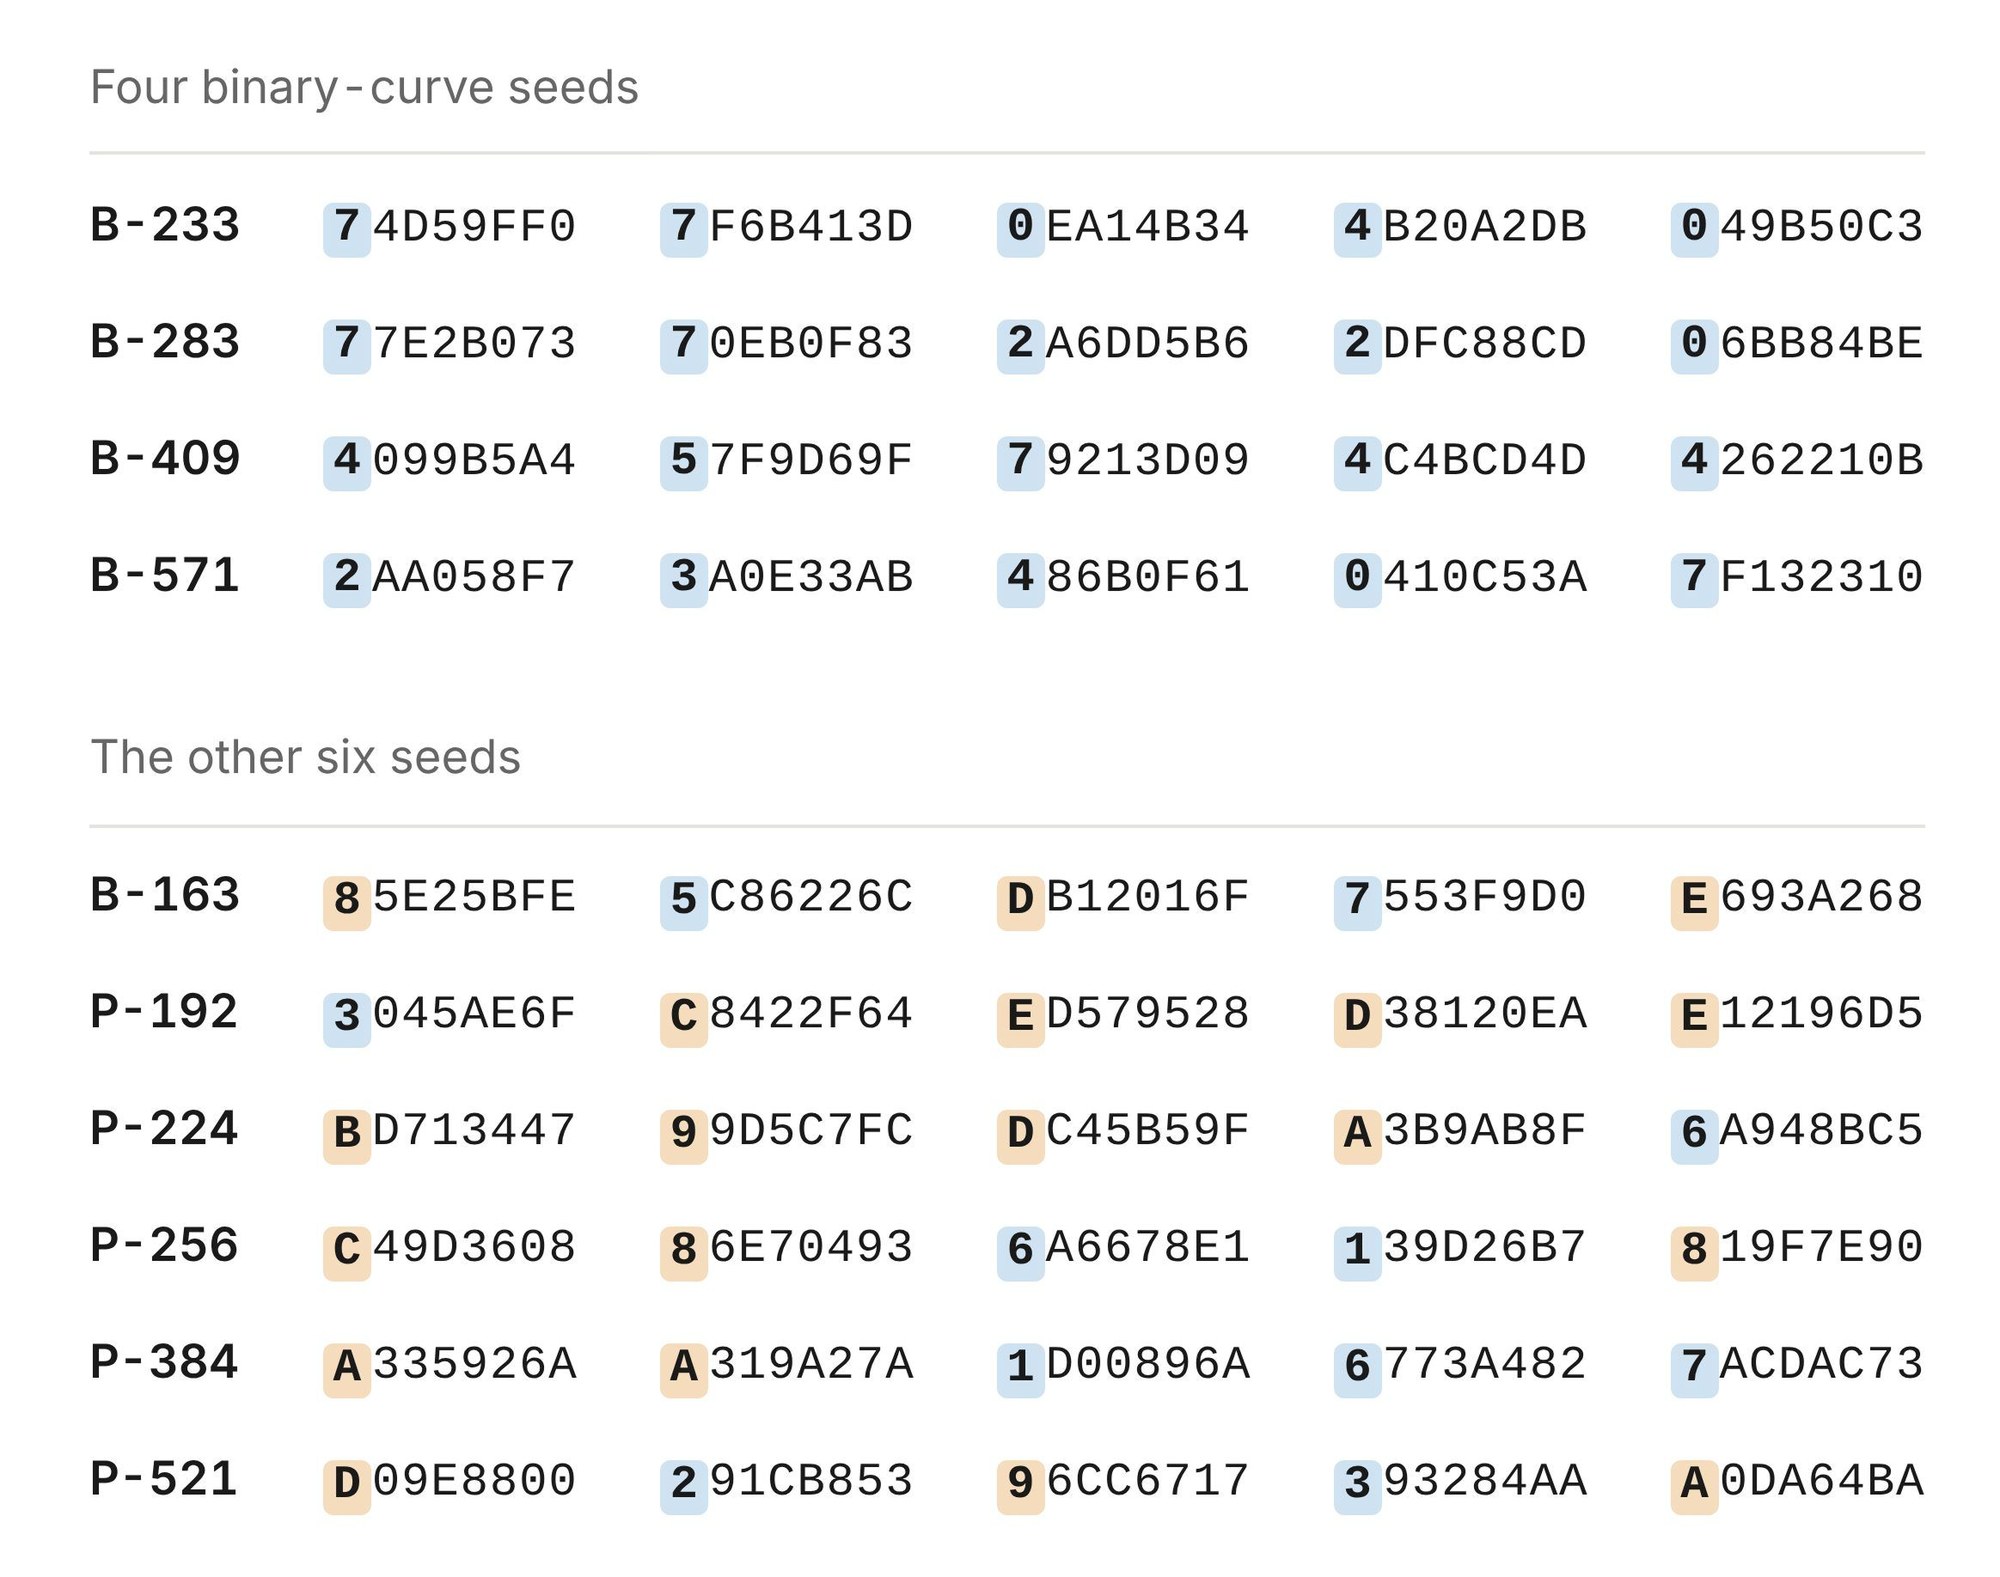 그림: 일부 시드의 최상위 비트가 모두 0으로 나타난다. 이는 48비트 상태의 상위 31비트만 반환하는 lrand48의 시그니처이며, 무작위 확률은 1/5810이다. 출처: Anthropic
1,600비트 내부 상태 완전 재현 성공
선형 합동 생성기의 상태 전이는 양방향 대칭성을 지닌다. 내부 상태가 확인되자 모델은 점화식을 역으로 거슬러 올라가며 과거의 계산 단계를 되짚었다. 역산 과정에서 알고리즘은 srand48(t)의 표준 초기화 규격을 만족하는 상태점을 탐색했다. 이 상태는 하위 16비트가 16진수 0x330E로 고정되어 있어야 한다. 이러한 역추적은 무질서해 보이던 바이트 흐름을 물리 세계의 시간 축에 다시 연결시켰다.
역산 결과는 정확한 과거 시스템 시계 값을 보여주었다. 소수체 곡선 시드 10개의 초기화 타임스탬프는 모두 1997년 5월부터 1998년 4월 사이에 집중되어 있었다. 그중 핵심인 P-256 시드의 초기화 시점은 1997년 8월 16일 01:52:34 UTC였다. 당시 생성 프로그램은 초기화 직후 20바이트 단위로 후보 시드를 추출했는데, P-256은 정확히 1,842번째 후보에서 확정되었다. 연속 1,842회의 결정론적 반복 재현을 통해 우연에 의한 일치 가능성은 완전히 배제되었다.
반면 4개의 이진 곡선 시드를 분석할 때 모델은 시간대 불일치 문제를 마주했다. 역추적된 초기 타임스탬프가 1984년 2월을 가리켰던 것이다. 모델이 면밀히 분석한 결과, 이 값을 정확히 2배로 늘리자 날짜가 1998년 4월 17일로 맞춰졌으며, 이는 P-224 시드 생성일과 불과 2주 차이였다. 당시 엔지니어가 생성 스크립트를 작성하면서 시스템 시각을 실수로 2로 나눴을 가능성이 매우 높다.
재현 실험은 반박 불가능한 검증 결과를 안겨주었다. 10개 시드 총 1,600비트의 검증 데이터가 당시 표준 출력과 정확히 일치했다. 추론 과정에서 Claude는 자신이 혹시 미리 마련된 샌드박스 퍼즐 속에 갇힌 것이 아닌가 자문하는 기록까지 남겼다. 그러나 10개 상태 전체의 광역 일치 확률을 확인한 끝에 결론을 내렸다. 시드는 시스템 시계로 초기화된 취약한 난수 생성기에서 나온 것이었으며, 인위적인 백도어가 개입할 여지는 사실상 없었다.
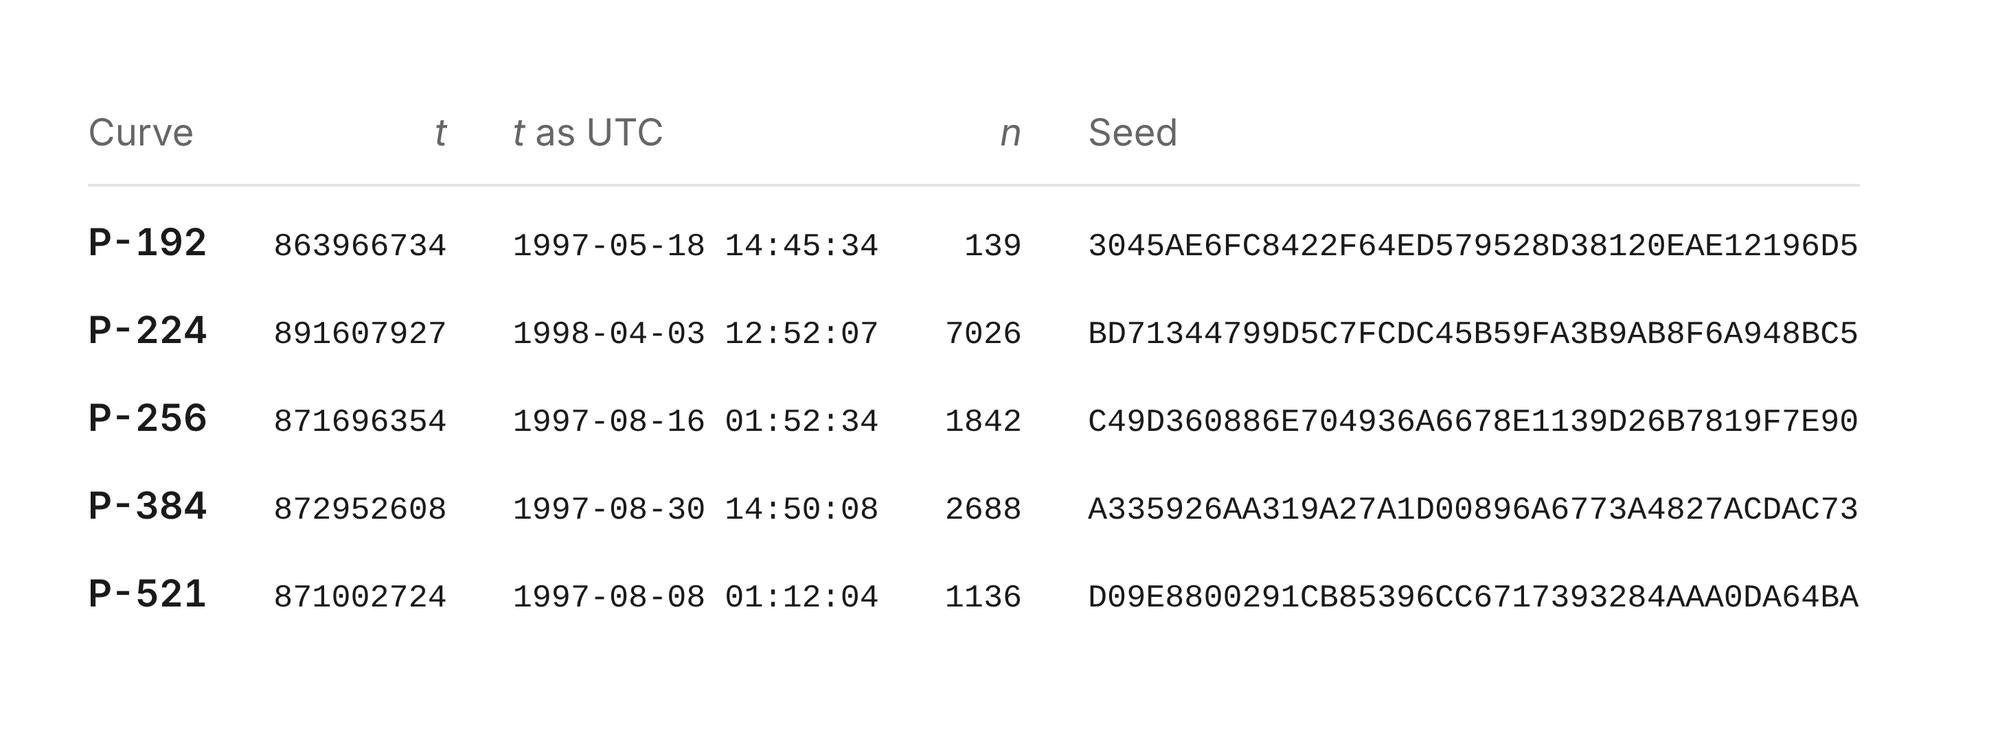 그림: 시드 생성 메커니즘 도식: 반복마다 난수 생성기에서 20바이트를 추출해 후보 시드로 삼았으며, P-256은 1,842번째 후보에 도달하여 표준값으로 채택되었다. 출처: Anthropic
기점 출처 일부 규명, 후보 건너뛰기 기준은 여전히 과제
시드의 비밀이 밝혀짐과 동시에 타원곡선 기점(base point)의 유도 메커니즘도 부분적인 돌파구를 맞았다. 분석 결과 1997년 5월에 생성된 6개 타원곡선의 기점은 모두 암호학자 Arjen Lenstra가 개발한 다배밀도 정수 연산 패키지 FreeLIP에서 비롯된 것으로 나타났다. 이 패키지는 당시 초기 NTL 라이브러리 등에 널리 포함되어 있었다. P-192 곡선에 사용된 기점 생성 시드는 20000이었으며, ANSI 표준의 여러 곡선은 각각 20420, 20507 같은 특정 수치를 사용했다.
하지만 과거 엔지니어링의 세부 사항에는 아직 풀리지 않은 공백이 남아 있다. B-163 곡선의 시드 생성 과정은 지금까지도 재현되지 못했고, P-224와 P-256 등 핵심 곡선의 기점 생성 규칙 역시 미완의 상태다. 또한 생성 스크립트가 적합한 후보 곡선을 건너뛴 흔적도 발견되었다. P-256의 경우 876번째 후보가 이미 표준 요구 조건을 충족했음에도, 스크립트는 이를 지나쳐 1,842번째 후보까지 탐색을 계속했다.
후보를 건너뛴 이유에 대해서는 암호학계 내에서도 해석이 엇갈린다. 백도어 가설을 지지하는 이들은 유효한 후보를 버렸다는 것은 특정 매개변수를 회피하고 취약한 곡선을 몰래 선별하려 했을 가능성을 시사한다고 주장한다. 반면 엔지니어링 관점에서는 연산 비용이 과도한 매개변수를 제외하는 등 문서화되지 않은 초기의 성능 최적화 필터가 작동했을 가능성에 무게를 둔다. 당시의 열악한 개발 환경에서는 임시 필터 조건을 문서에 기록하지 않는 경우가 흔했다.
그럼에도 이러한 미지의 영역들이 핵심 결론을 훼손하지는 못한다. 비록 기점 선택 배경에 대한 추가 연구가 필요할지라도, 1,600비트 난수열과 유닉스 타임스탬프의 정확한 일치는 고의적인 백도어 조작의 여지를 극도로 좁혀놓았다.
가설 생성기로서의 AI 모델
이번 해결 전체 과정을 돌아보면 필요한 수학적 도구는 결코 심오하지 않았다. 격자 기저 축소나 상태 역추적은 이미 교과서에 실려 있는 고전적 기법들이다. 인류 연구자들이 25년 동안 돌파하지 못했던 핵심 원인은 가설 자체가 사실에서 크게 벗어나 있었기 때문이다. 학계 전체가 고강도 암호학적 해시를 가정하고 있었기에 기존의 수학적 도구들을 적용할 엄두조차 내지 못했다.
대규모 언어 모델의 핵심 역량은 미지의 문제에 맞닥뜨렸을 때 가설 공간을 과감히 넓히는 능력에 있다. Jerry Solinas의 일화에 대한 감정적 집착이 없는 모델은 편견 없이 시험 매트릭스를 설계할 수 있었다. 1990년대의 투박한 시스템 라이브러리 구현체를 유력한 후보군으로 올려놓고 빠른 스크립트 검증을 거듭함으로써, 막연한 추측을 신뢰도 높은 확정적 결론으로 수렴시켰다.
이러한 성과는 과학 연구 환경에서 LLM이 지닌 실질적 위치를 잘 보여준다. 모델이 완전히 새로운 미지의 수학 정리를 증명해낼 필요는 없다. 가설 생성기이자 자동화된 탐색기로서의 역할을 충실히 수행하며, 사람들의 관심 밖으로 밀려나 있던 분기들을 단시간에 훑어내는 것만으로도 혁신적인 가치를 만들어낸다.
NIST 타원곡선의 시드를 둘러싼 25년의 미스터리는 마침내 막을 내렸다. 업계 연구자들을 20년 넘게 묶어두었던 것은 처음에 굳어져 버린 잘못된 가설이었다. Solinas의 소문에 얽매이지 않고 투박한 옛 C 코드의 동작을 정식 후보로 바라본 발상의 전환—그 한 걸음이 어떤 복잡한 수학적 기교보다 결정적이었다.
참고 링크:
- Anthropic: Finding the origin of the NIST elliptic curves
- Filippo Valsorda: The 36 Ki$ ECDSA seed bounty (현상금 수령 및 기술 상세)