C49D3608 86E70493 6A6678E1 139D26B7 819F7E90
La cadena hexadecimal de 160 bits anterior constituye el parámetro semilla central de la curva P-256, una curva elíptica que protege miles de millones de conexiones en internet en todo el mundo. El 15 de octubre de 2026, la recompensa comunitaria de 36.864 dólares ofrecida por Filippo Valsorda fue reclamada por un equipo de investigadores de Anthropic. El misterio que desconcertó a la comunidad criptográfica durante un cuarto de siglo fue resuelto en apenas media hora por su modelo interno de investigación, Claude. El importe íntegro del premio se donó a la organización sin ánimo de lucro ISRG (Internet Security Research Group).
El verdadero valor de este avance radica en haber cambiado el espacio de hipótesis. Durante décadas, el mundo académico asumió que las semillas eran el resultado de aplicar una función hash SHA-1 a contraseñas o frases secretas en inglés, una suposición que desvió la investigación durante más de veinte años. En lugar de insistir en ataques de fuerza bruta sobre diccionarios, el modelo analizó las firmas de comportamiento de generadores de números pseudoaleatorios históricos, reproduciendo de forma determinista 10 conjuntos de semillas y 1.600 bits para cerrar matemáticamente el caso.
Veinticinco años buscando en la dirección equivocada
En el año 2000, el NIST incorporó las curvas ECDSA en el estándar FIPS 186-2, incluyendo cinco curvas sobre campos primos que iban desde P-192 hasta P-521. Cada curva iba acompañada de un valor semilla en formato hexadecimal a partir del cual el algoritmo generaba los parámetros mediante cálculo hash. Sin embargo, estas semillas críticas presentadas por la NSA se publicaron sin ninguna explicación sobre su derivación. Aquella opaca caja negra provocó de inmediato una crisis de confianza en la comunidad académica.
El rumor más extendido apuntaba al investigador de la NSA Jerry Solinas, sugiriendo que había utilizado frases ingeniosas en inglés y calculado su hash SHA-1 para obtener las semillas. Tras el fallecimiento de Solinas en 2023, la posibilidad de verificar aquella tradición oral se desvaneció. La comunidad académica dedicó ingentes recursos de cómputo a explorar combinaciones de palabras por fuerza bruta intentando dar con prefijos hash coincidentes, desperdiciando un tiempo valioso en conjeturas infundadas.
La falta de transparencia alimentó a lo largo de los años las sospechas de la existencia de puertas traseras (backdoors). En 2015, Neal Koblitz y Alfred Menezes elaboraron un análisis histórico exhaustivo sobre las dudas en torno a estas semillas. En 2017, los criptógrafos Daniel J. Bernstein y Tanja Lange señalaron que el proceso de selección de las semillas contenía unos 70 bits de libertad, margen teóricamente suficiente para elegir curvas deliberadamente débiles. Estas sospechas socavaron durante más de una década la confianza de la industria en los componentes criptográficos estándar.
Decidido a cerrar este capítulo, el investigador independiente Filippo Valsorda lanzó una recompensa comunitaria de 36.864 dólares. Durante una estancia en Taiwán, compró 20 dados en una tienda FamilyMart, los bautizó con sorna como «Fuente de entropía Geomys FIPS 140-3» y se burló del misticismo de las semillas estándar recordando que una sola tirada de 6^20 genera unos 51,7 bits de entropía física. Mientras el código de generación no pudiera reproducirse, la desconfianza de la comunidad hacia los estándares persistiría.
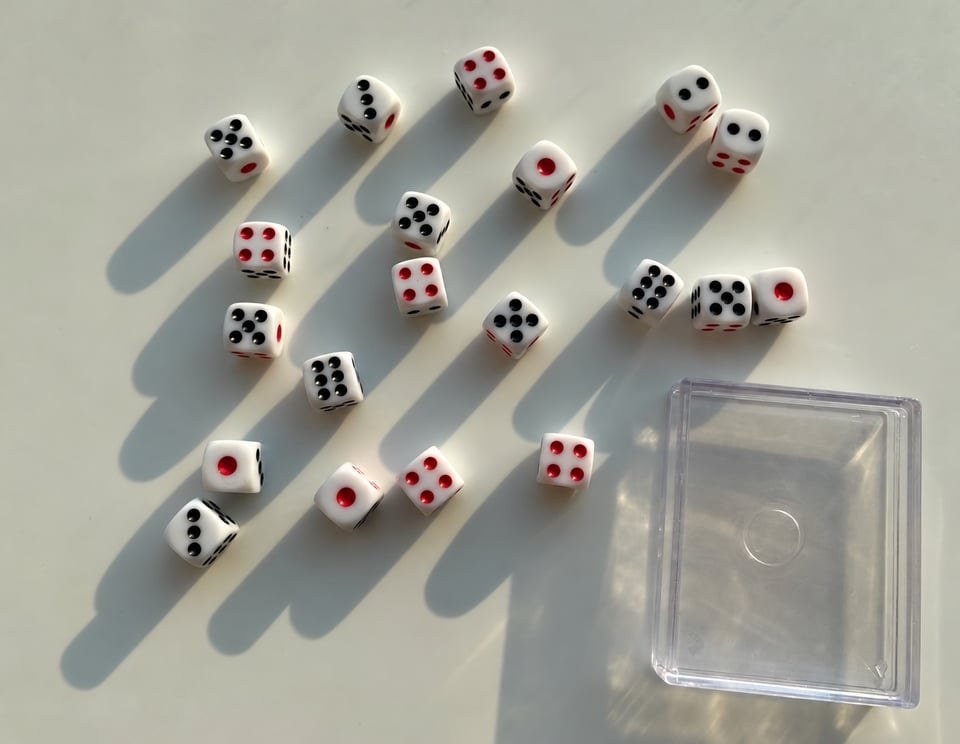 Figura: 20 dados comprados en un FamilyMart de Taiwán, capaces de generar unos 51,7 bits de entropía física en una sola tirada. Fuente: Filippo Valsorda
Deducción en media hora: las semillas nacieron del reloj de un sistema de 1997
En octubre de 2026, ingenieros de Anthropic plantearon este problema sin resolver a su modelo de investigación Claude. La consigna no incluía pista alguna y solo le pedía deducir el origen de las semillas desde cero. De manera sorprendente, el modelo dio con la respuesta en menos de treinta minutos. La clave de esta rapidez radicó en enfocar el análisis en los patrones estadísticos de los generadores algorítmicos.
Claude programó un escáner automatizado que probó 34 combinaciones de generadores pseudoaleatorios (PRNG) y patrones de recorte de bits. Al examinar la estructura de los bytes, el modelo detectó una huella estadística reveladora: al dividir las 10 semillas públicas en cinco enteros de 32 bits, los 20 enteros de cuatro de ellas tenían el bit más significativo (MSB) fijado en cero. En una secuencia de bytes distribuida uniformemente, la probabilidad de que esto ocurra es de apenas 1 entre 5.810. Aquel sesgo no era una casualidad; procedía necesariamente de la arquitectura del generador.
Esta firma estadística apuntaba de lleno a lrand48(), una función estándar de la biblioteca C de Unix ampliamente utilizada en los años noventa. Dicha función maneja un estado interno de 48 bits, pero solo devuelve los 31 bits superiores en cada llamada. Al completarse el bit superior con un cero por diseño, deja un rastro inconfundible. Para recuperar el estado interno de un paso solo hacía falta enumerar los 17 bits inferiores no revelados, reduciendo el espacio de búsqueda a únicamente 131.072 posibilidades.
Para las semillas de curvas sobre campos primos con esquemas de truncamiento más complejos, el modelo construyó un algoritmo de reducción de bases de retículos (Lattice Basis Reduction). La recuperación del estado en generadores congruenciales lineales truncados es un problema clásico de retículos. Al aplicar la reducción de base sobre diversas ventanas de truncamiento, los cálculos demostraron que las 10 semillas seguían el patrón lrand48() >> 23. A partir de cada estado de 48 bits recuperado, fue posible reconstruir de forma exacta los 160 bits íntegros de cada semilla.
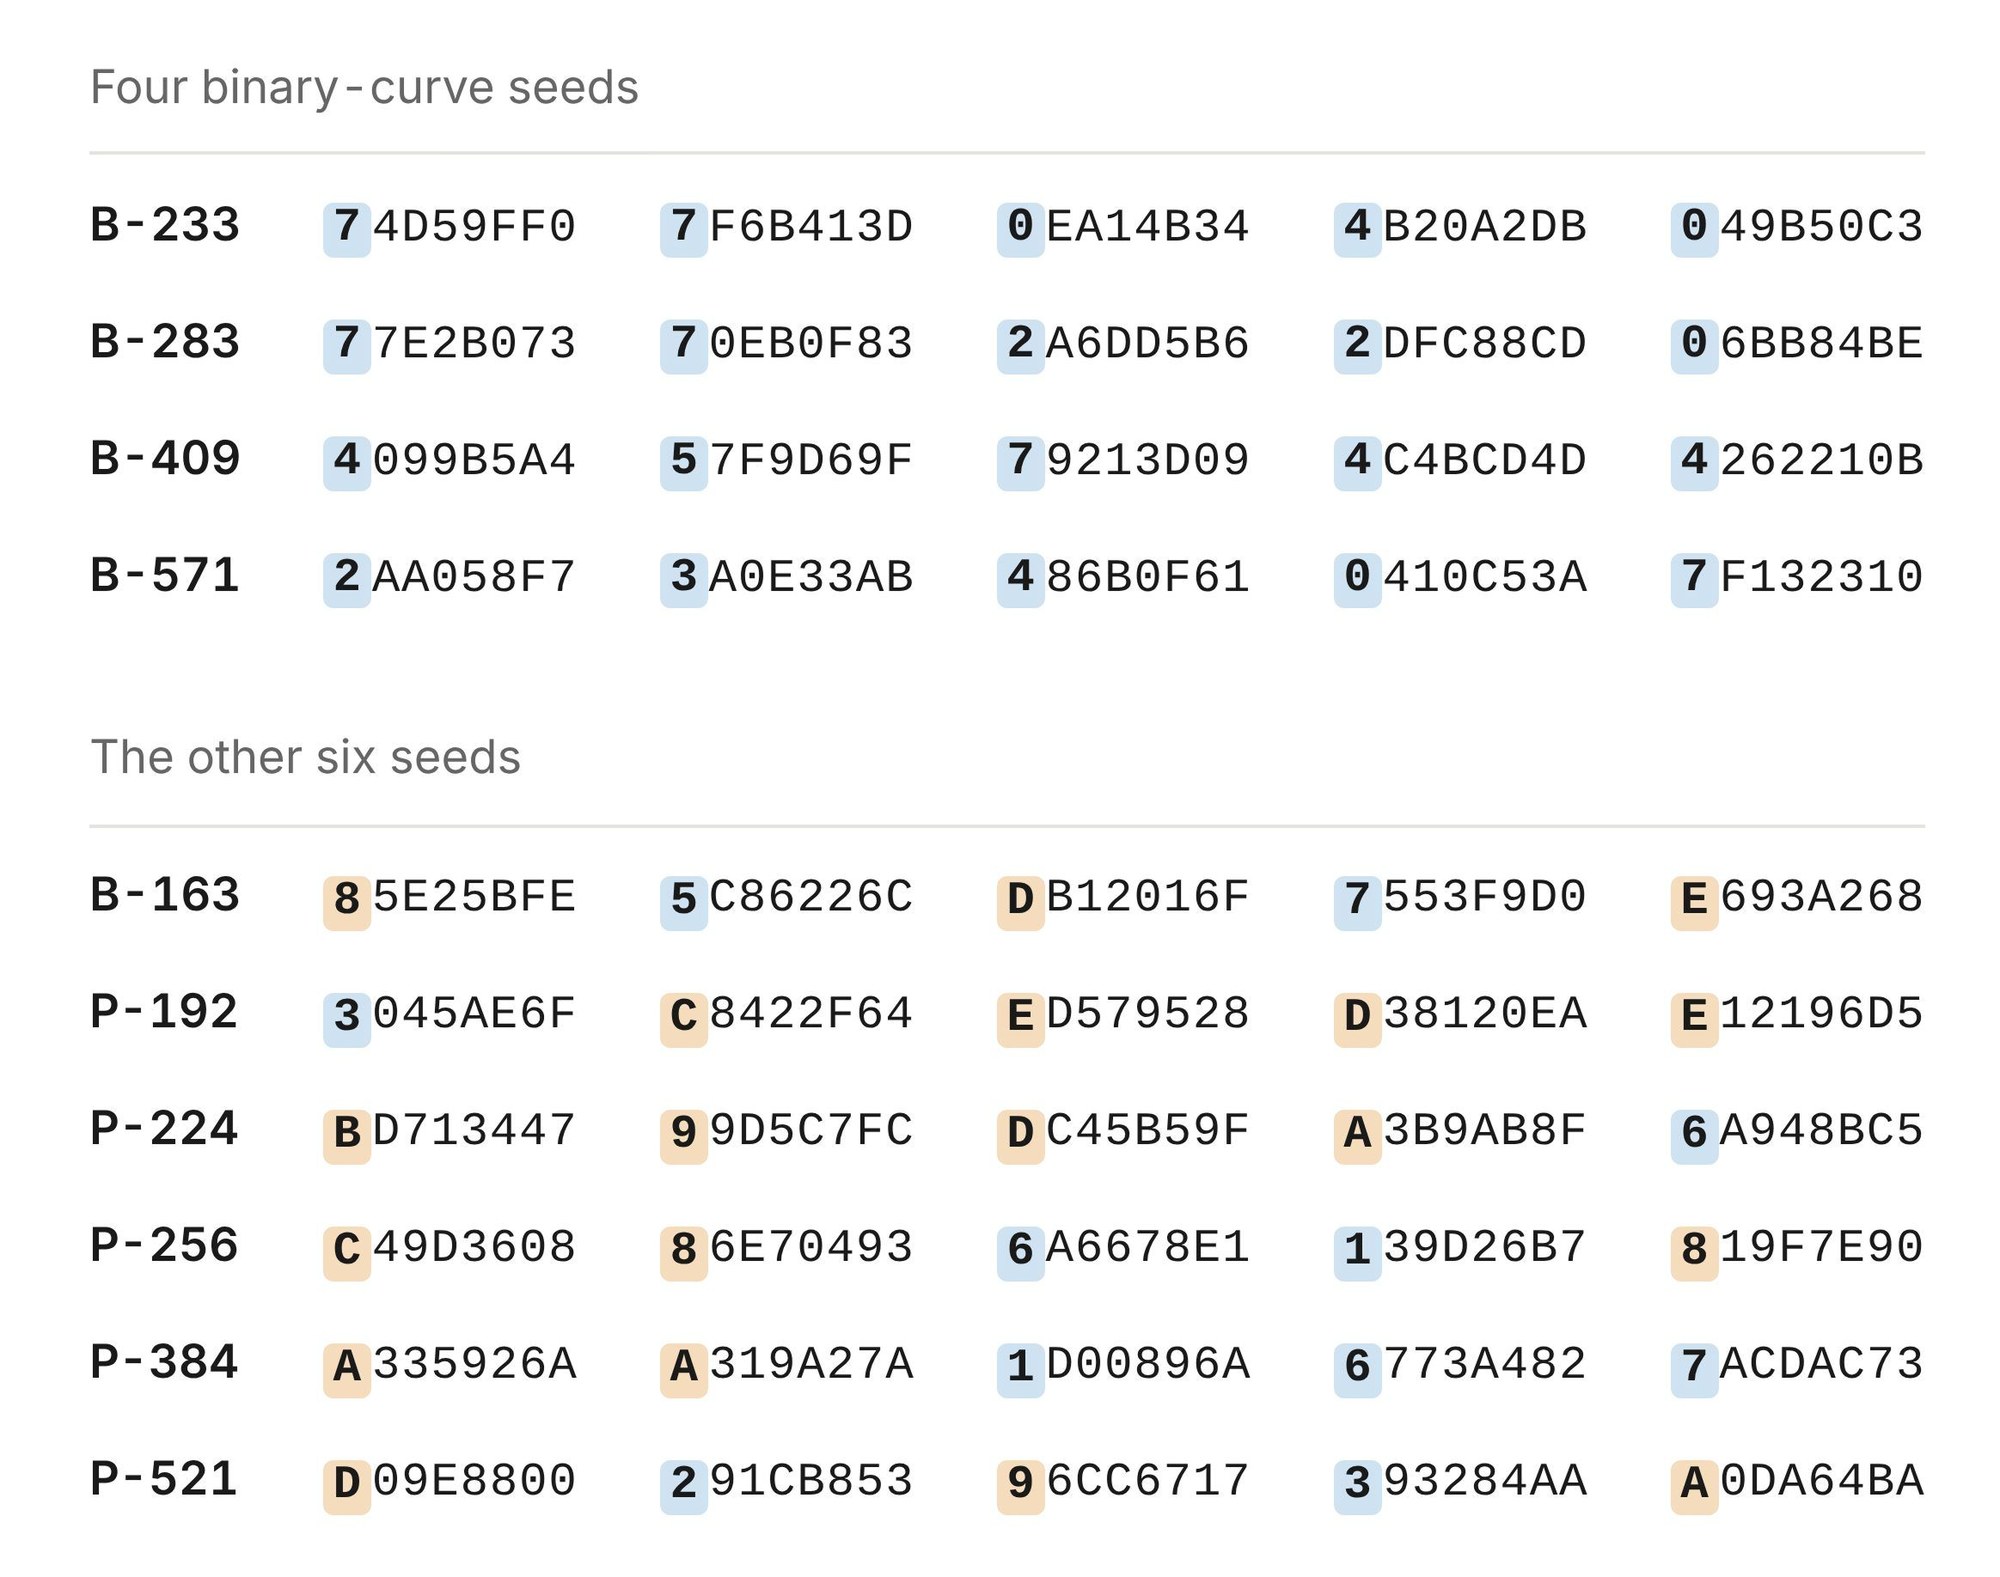 Figura: Los bits superiores de ciertas semillas son todos 0, firma característica de lrand48 al devolver solo los 31 bits más altos de un estado de 48 bits (probabilidad aleatoria: 1/5810). Fuente: Anthropic
Reconstrucción exitosa de 1.600 bits de estado
Las transiciones de estado de un generador congruencial lineal poseen simetría bidireccional. Una vez determinado el estado interno, el modelo recorrió la fórmula de recurrencia hacia atrás en el tiempo. Durante este retroceso, el algoritmo buscó estados conformes con la inicialización estándar srand48(t), donde los 16 bits inferiores quedan fijados en el valor hexadecimal 0x330E. Este rastreo inverso volvió a situar una secuencia de bytes aparentemente caótica sobre el eje del tiempo real.
El resultado arrojó lecturas temporales exactas. Las marcas de tiempo de inicialización de las 10 semillas sobre campos primos se concentraban con precisión entre mayo de 1997 y abril de 1998. La semilla fundamental de P-256 coincidía exactamente con el 16 de agosto de 1997 a las 01:52:34 UTC. Tras inicializarse, el programa de generación extraía candidatos en bloques de 20 bytes; P-256 apareció exactamente en la posición 1.842. La reproducción determinista a lo largo de 1.842 iteraciones descartó de raíz cualquier posibilidad de coincidencia accidental.
Al abordar las cuatro semillas de curvas binarias, el modelo se topó con un desfase temporal: la marca de tiempo inicial apuntaba a febrero de 1984. Sin embargo, al duplicar dicho valor numérico, la fecha se trasladaba exactamente al 17 de abril de 1998, apenas dos semanas antes de la generación de P-224. Es muy probable que el ingeniero que redactó el script dividiera por error el tiempo del sistema entre dos.
Los experimentos de reproducción ofrecieron una confirmación irrebatible: los 1.600 bits de prueba de los 10 conjuntos de semillas coincidieron al 100% con los datos oficiales de la época. En sus notas de razonamiento, Claude llegó a manifestar dudas sobre si se encontraba dentro de un ejercicio preparado. La verificación global probabilística disipó cualquier incertidumbre: las semillas procedían de un generador débil inicializado con el reloj del sistema, lo que dejaba un margen prácticamente nulo para la manipulación deliberada.
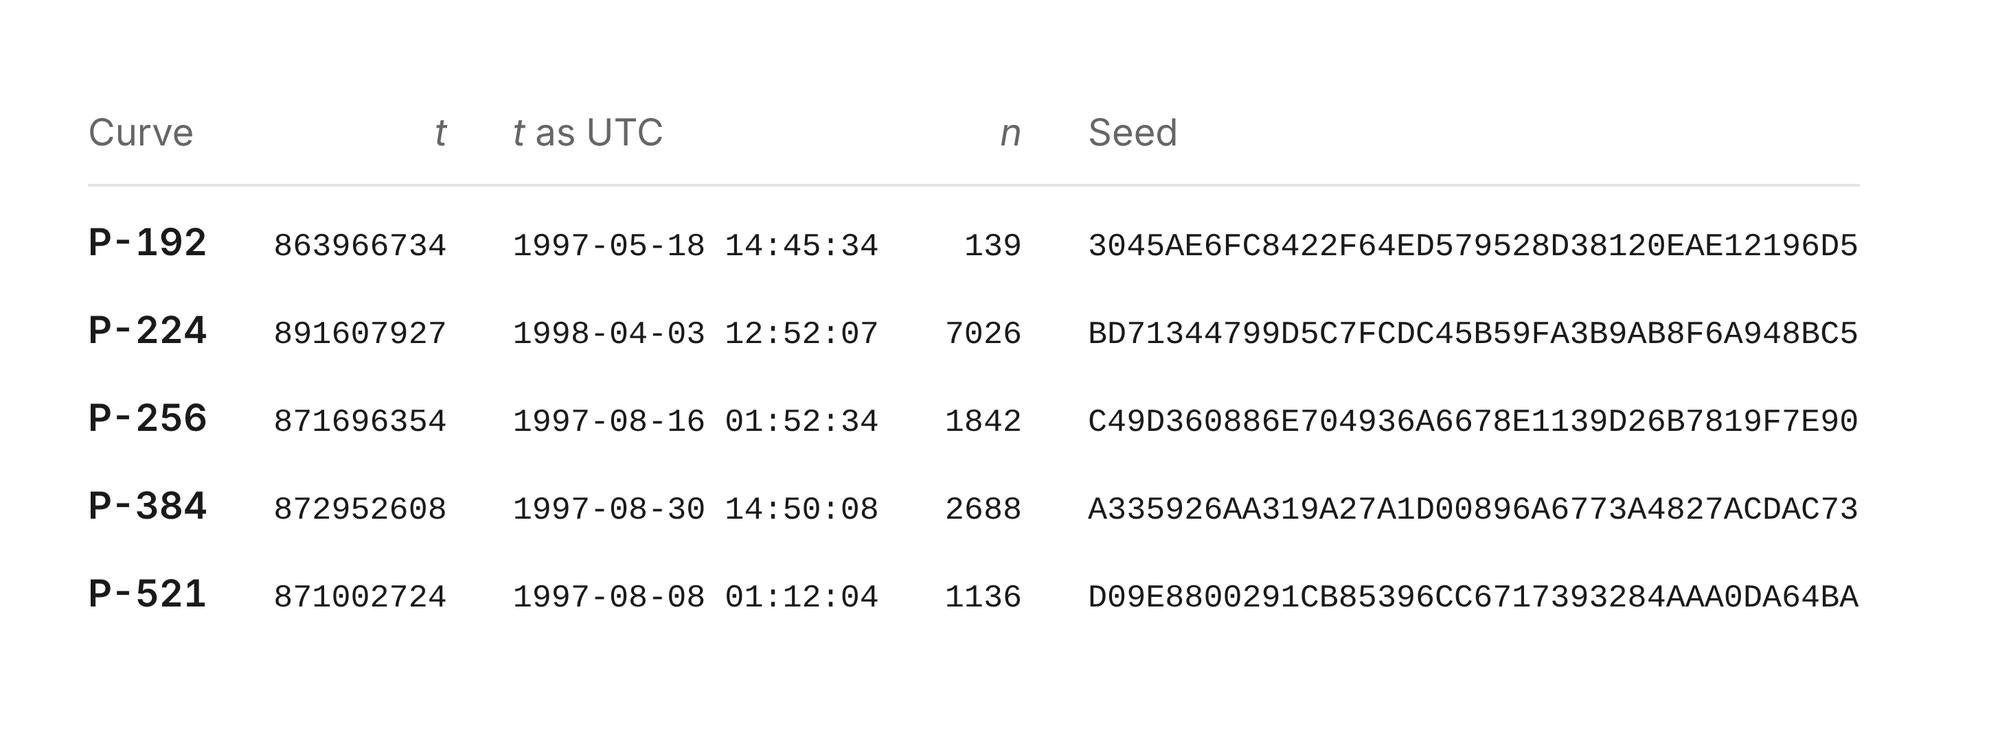 Figura: Esquema del mecanismo de generación: en cada iteración se extraían 20 bytes del PRNG como candidato; P-256 fue aceptado en el candidato número 1.842. Fuente: Anthropic
Origen parcial de los puntos base, incógnita en el descarte de candidatos
En paralelo al descubrimiento de las semillas, la deducción de los puntos base de las curvas experimentó un avance significativo. El análisis demostró que los puntos base de seis curvas elípticas generadas en mayo de 1997 procedían de FreeLIP, un paquete de cálculo con enteros de precisión múltiple desarrollado por el criptógrafo Arjen Lenstra e integrado en las primeras versiones de la biblioteca NTL. La curva P-192 utilizó una semilla de punto base de 20000, mientras que varias curvas ANSI emplearon valores discretos como 20420 y 20507.
Aun así, persisten ciertas lagunas históricas de ingeniería. El origen de la semilla para la curva B-163 sigue sin poder reproducirse, y las reglas exactas de derivación de los puntos base en curvas fundamentales como P-224 y P-256 continúan sin resolverse. Asimismo, se detectó que el script de generación descartó curvas válidas: en el caso de P-256, el candidato 876 ya satisfacía todos los criterios requeridos, pero el script lo pasó por alto y continuó hasta el candidato 1.842.
Este salto de candidatos ha sido objeto de interpretaciones contrapuestas en el mundo criptográfico. Quienes defienden la hipótesis de una puerta trasera sostienen que desechar candidatos válidos permitía esquivar ciertos parámetros para seleccionar curvas con debilidades ocultas. Por su parte, la perspectiva pragmática de la ingeniería sugiere que los descartes respondían a filtros heurísticos no documentados para optimizar el rendimiento, como evitar configuraciones con un coste de cómputo elevado. En el contexto informal de desarrollo de finales de los noventa, era habitual no dejar constancia de filtros provisionales en la documentación.
Estas incógnitas secundarias no restan solidez a la conclusión principal. Aunque la elección de los puntos base amerite mayor investigación histórica, la correspondencia matemática de 1.600 bits pseudoaleatorios con marcas de tiempo de Unix reduce al mínimo cualquier sospecha de manipulación deliberada.
El modelo de lenguaje como generador de hipótesis
Al repasar el proceso, se constata que las herramientas matemáticas requeridas no eran complejas: la reducción de retículos y la inversión de estados en generadores congruenciales son técnicas clásicas explicadas en los libros de texto. El obstáculo que impidió avanzar a los investigadores humanos durante 25 años fue una hipótesis de partida equivocada: al suponer que las semillas procedían de funciones hash de alta seguridad, las herramientas algebraicas existentes quedaban inutilizadas.
La principal ventaja de los grandes modelos de lenguaje en la investigación científica radica en su capacidad para ensanchar el espacio de hipótesis. Sin apego emocional a las anécdotas sobre Jerry Solinas, el modelo pudo diseñar una matriz de pruebas sin sesgos previos. Al considerar como una opción legítima una implementación rudimentaria de C de los noventa, Claude validó rápidamente la hipótesis mediante scripts y transformó conjeturas abiertas en una certeza matemática irrebatible.
Este hito perfila el papel práctico de la IA en la ciencia: los modelos no necesitan inventar nuevos teoremas matemáticos para generar descubrimientos; su verdadero valor reside en actuar como generadores de hipótesis y exploradores automatizados capaces de recorrer ramificaciones desatendidas en cuestión de minutos.
El misterio de un cuarto de siglo sobre las curvas del NIST queda resuelto. Lo que bloqueó a los criptógrafos durante dos décadas no fue la falta de matemáticas, sino una premisa inicial asumida como dogma. La máquina, ajena a mitos urbanos, evaluó el tosco código de sistemas de los años noventa como un candidato real: un cambio de perspectiva infinitamente más valioso que cualquier artificio algebraico.
Enlaces de referencia:
- Anthropic: Finding the origin of the NIST elliptic curves
- Filippo Valsorda: The 36 Ki$ ECDSA seed bounty (anuncio de adjudicación y detalles técnicos)