Am 21. Oktober 2026 veröffentlichten OpenAI und kooperierende Forschungsteams einen Meilenstein: 1.946 spezialisierte KI-Agenten analysierten im Verbund den vollständigen genetischen Atlas eines Mäusegehirns in lediglich 32 Minuten. Der Atlas erfasst die Reaktionen auf Genom-Editierungen von Millionen Gehirnzellen – eine hochdimensionale Datenmenge, deren systematische Auswertung menschliche Teams normalerweise Jahre kostet.
Dabei handelt es sich um weit mehr als eine Demonstration brachialer Rechenleistung. Der entscheidende Durchbruch liegt in der feinteiligen Zerlegung der wissenschaftlichen Arbeitsprozesse. Monolithische Großmodelle geraten bei hochdimensionalen biologischen Datensätzen regelmäßig an Kontextgrenzen und flüchten sich in vage Allgemeinplätze. Die Forscher verabschiedeten sich vom Ansatz, einem einzelnen Riesenmodell die gesamte Pipeline aufzubürden, und teilten die Analyse stattdessen in Tausende parallel prüfbare Mikro-Aufgaben auf.
Jahrelange Arbeit in 32 Minuten komprimiert: Woran rechneten fast 2.000 Modelle?
Das Gehirn einer Maus besteht aus einem hochkomplexen zellulären Netzwerk. Mittels CRISPR-Technologie schalteten die Wissenschaftler gezielt Schlüsselgene aus. Wurde ein Gen blockiert, geriet die Expression Tausender nachgelagerter Gene ins Wanken. Der resultierende Atlas dokumentiert die Störungsreaktionen von Millionen Einzelzellen – ein gigantischer Datenberg.
Menschliche Biologen müssen bei solchen Datensätzen endlos Expressionsmatrizen und Tabellen abgleichen und monatelang Fachliteratur wälzen, um mechanistische Hypothesen zu formulieren. Die 1.946 mit GPT-Rosalind betriebenen Agenten versuchten gar nicht erst, den gesamten Datensatz auf einmal zu verarbeiten. Das System zerlegte Perturbationsanalyse und Literaturrecherche in standardisierte Teilschritte, sodass sich jeder Agent auf die Untersuchung eines einzelnen mikroskopischen Mechanismus konzentrieren konnte.
Nach 32 Minuten Laufzeit lieferte der Agentenschwarm 3.397 eigenständige biologische Schlussfolgerungen. Nachgelagerte Algorithmen fügten diese Bausteine automatisch zu einem konsistenten Schlusssfolgerungsgraphen zusammen. Während der gesamten Inferenz griffen keine Menschen ein, um Hyperparameter nachzujustieren; die Hypothesen wurden direkt aus den zugrunde liegenden Genexpressionsmatrizen abgeleitet. Der vollständige Datensatz ist als Open-Source-Archiv auf GitHub frei zugänglich.
Monolithisches Modell zitierte 11 Arbeiten, Aufgabenzerlegung erschloss 7.600
Wie belastbar eine Schlussfolgerung ist, entscheidet sich an der Stärke der Beweiskette. Wurde der gesamte Datensatz einem einzelnen monolithischen Modell vorgelegt, nannte dieses für die gleiche Gesamtaufgabe lediglich 11 Literaturzitate. Dieser eklatante Mangel offenbart eine strukturelle Schwachstelle monolithischer Architekturen: Überschreitet das Datenvolumen die Aufnahmekapazität, brechen Recherchebreite und Aufmerksamkeit drastisch ein.
Der verteilte Schwarm revolutionierte den Informationsfluss. Fast zweitausend Agenten übernahmen spezialisierte Rollen – von der Literaturrecherche über Hypothesenbildung bis hin zur gegenseitigen Kreuzprüfung. Jedes Teilkollektiv nahm die auffällige Expression spezifischer Zell-Subpopulationen ins Visier. Laut dem bioRxiv-Preprint durchsuchte und validierte das verteilte System rund 7.600 Fachpublikationen – das 711-Fache der Zitationsabdeckung des monolithischen Modells.
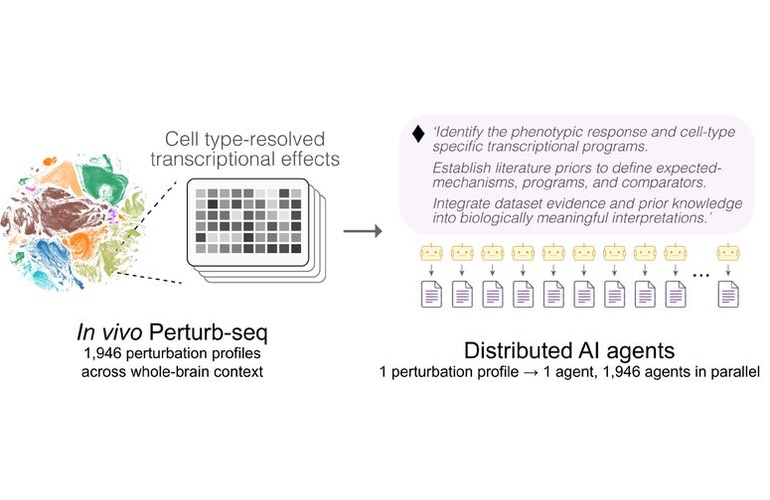 Abbildung: Hierarchische Scheduling-Architektur der verteilten Agenten. Jeder Knoten führt Literaturabgleich und Gegenprüfung für einzelne Genstörungen autonom durch. Quelle: R&D World (nach Sun et al., bioRxiv)
Ungefilterte Datenmengen verleiten Sprachmodelle zu Scheinkorrelationen und Halluzinationen. Indem die Gesamtaufgabe zerlegt wurde und Tausende Agenten gezielte Auszüge tiefgehend studierten, entstand ein lückenloses Belegnetzwerk. Die Tiefe der Aufgabenzerlegung bestimmt unmittelbar die bibliografische Reichweite und Stichhaltigkeit wissenschaftlicher Ableitungen.
30 promovierte Biologen im Blindtest: 48 Kernbefunde ad hoc reproduziert
Hypothesen aufzustellen ist für eine KI trivial; peer-review-taugliche Qualität zu liefern, ist die wahre Hürde. Zur Qualitätsprüfung zog das Team 30 promovierte Biologen für ein Doppelblind-Gutachten heran. Ohne die Herkunft der Berichte zu kennen, bewerteten die Experten die Plausibilität und Tiefe der Schlussfolgerungen.
Die Agenten hatten die Originalmanuskripte der Vergleichsstudien zuvor nie gesehen. Dennoch reproduzierten sie im Blindtest 48 von 55 etablierten Schlüsselergebnissen der Fachliteratur – eine Übereinstimmungsquote von 87 %. Im direkten Qualitätsvergleich zogen die Fachexperten in 75 % der Bewertungsfälle die Berichte des Agentenschwarms dem monolithischen Modell vor.
 Abbildung: Links die Genexpressions-Perturbationsmatrix aus Millionen Gehirnzellen; rechts die von fast 2.000 Agenten parallel entwickelte Argumentationstopologie. Quelle: madrobot.blog
Analysen monolithischer Modelle bleiben häufig an der Oberfläche von Lehrbuchwissen hängen und vermissen konkrete molekulare Interaktionsdetails. Im verteilten Cluster hingegen decken die Knoten gegenseitig logische Brüche auf und verwerfen unbegründete Spekulationen frühzeitig. Der systemische Kreuzverhör-Mechanismus drückt die Halluzinationsrate im wissenschaftlichen Arbeiten drastisch nach unten.
Verborgene Genpfade aufgespürt: KI liefert neue Spuren an die Laborbank
Bekannte Resultate zu reproduzieren ist nur der erste Schritt. Der eigentliche Wert liegt im Aufspüren blinder Flecken, die der menschlichen Aufmerksamkeit entgehen. Bei der Analyse des Gens DCTN1 stieß der Schwarm auf ein überraschendes Signal: Wurde das Gen blockiert, stieg die Expression cholesterinsynthetisierender Gene in den Zellen signifikant an.
DCTN1 codiert eine Dynactin-Untereinheit und steht in engem Zusammenhang mit neurodegenerativen Erkrankungen wie der Amyotrophen Lateralsklerose (ALS). Bisherige Forschungen konzentrierten sich fast ausschließlich auf gestörte axonale Transportprozesse; eine Verbindung zum Cholesterinstoffwechsel zog kaum jemand in Betracht. Durch den Abgleich Dutzender Nischenpublikationen formulierten die Agenten eine schlüssige mechanistische Hypothese.
Demnach führt der gestörte axonale Transport dazu, dass Cholesterin nicht mehr zum Zellkörper zurückgeführt wird. Der Zellkern registriert ein lokales Defizit und aktiviert den SREBP-Signalweg zur kompensatorischen Synthese, was letztlich den Untergang von Nervenzellen beschleunigt. Eine präzise Aufgabenzerlegung überwindet Fachsilos: Diese Herleitung liefert einen völlig neuen Ansatzpunkt für die pharmazeutische Wirkstoffforschung.
Rechenleistung löst den Hypothesen-Engpass, das Nasslabor bleibt letzte Instanz
Tausende wissenschaftliche Herleitungen in 32 Minuten sind ein beeindruckender Benchmark. Die Letztentscheidung in den Biowissenschaften obliegt jedoch stets den realen Molekülen der physischen Welt. Umfangreiche Literaturzitate belegen einen weiten Recherchehorizont, aber keine absolute Wahrheit. Vorhersagen, die nicht an Petrischale und Pipette überprüft wurden, bleiben letztlich eine Liste plausibler Arbeitshypothesen.
Auch die beteiligten Forscher betonen, dass die vorgeschlagenen Mechanismen im Nasslabor validiert werden müssen. KI ersetzt nicht das experimentelle Handwerk der Biologen, sondern revolutioniert die Methode, mit der wissenschaftliche Hypothesen generiert werden. Statt Monate auf das Finden eines Ansatzes zu verwenden, liefert der Algorithmus nun solide untermauerte Hypothesen direkt an den Labortisch.
Erst wenn Forschungsabläufe feingliedrig zerlegt werden, wird Rechenleistung zum echten Katalysator wissenschaftlicher Entdeckungen. Die Marschrichtung für KI in den Lebenswissenschaften zeichnet sich deutlich ab: Anstatt auf ein allwissendes Supermodell zu warten, formen Hunderte spezialisierter Mikro-Agenten mit disziplinierten Prüfroutinen die schlagkräftigste wissenschaftliche Speerspitze.
Weiterführende Links:
- Offizieller OpenAI-Forschungsbericht: Skalierung von KI-Forschung für komplexe biologische Daten
- bioRxiv-Preprint: Verteilte KI-Agenten ermöglichen skalierbare Synthese biologischer Erkenntnisse
- R&D World-Bericht: OpenAI setzt knapp 2.000 GPT-Rosalind-Agenten ein, um biologische Forschungsansätze in 32 Minuten zu generieren
- GitHub Open Source: Distributed Agent Framework für biologische Inferenz