2026年10月21日、OpenAIと共同研究チームは画期的な実験成果を発表した。1,946体もの特化型AIエージェントが協調して動作し、マウス全脳遺伝子アトラスの解析をわずか32分で完了させたのだ。このアトラスには数百万個に及ぶ細胞のゲノム編集応答が記録されており、これほど高次元なデータを読み解くには通常、人間の研究チームが数年を費やす必要がある。
これは単なる計算リソースの物量作戦ではない。本質的な転換点は、エンジニアリングにおけるタスク分解の粒度にある。従来の大規模モデルは、膨大な生物学的データに直面するとコンテキストの過負荷に陥り、通り一遍の抽象論を出力しがちだった。研究陣は単一モデルに全工程を背負わせるアプローチを捨て、複雑な研究プロセスを数千の微細な検証工程へと分割した。
数年分の作業を32分で完了、約2000体のモデルは何を計算していたのか
マウスの脳には極めて高密度の細胞ネットワークが存在する。研究者らはCRISPR技術を用いて重要遺伝子をピンポイントで標的阻害した。特定の遺伝子が損なわれると、連鎖的に数千の遺伝子発現量が変動する。アトラス全体には数百万の細胞にわたる擾乱応答が記録されており、そのデータ規模は途方もない。
人間の研究者がこの種のデータを分析する場合、膨大なヒートマップや一覧表を行き来し、文献調査に何カ月も費やしてようやく分子メカニズムを仮説化する。しかしGPT-Rosalindを搭載した1,946体のエージェントは、すべてのデータを単独で丸呑みしようとはしなかった。システムは擾乱分析と文献探索を標準化されたサブタスクに切り分け、各エージェントが単一の微視的メカニズムの検証に専念した。
パイプラインが32分間稼働した結果、エージェント群は3,397件の独立した生物学的推論を出力した。アルゴリズムはこれらの推論を自動的に統合し、推論トポロジーグラフへと再構築した。推論の全過程で人間によるハイパーパラメータ調整は一切行われず、生の遺伝子発現行列から仮説が自律的に導き出された。この推論群はGitHub上で公開され、神経疾患研究のための共有アーカイブとなっている。
単一モデルは11本の文献しか引用できず、タスク分割後は7600本に急拡大
科学的推論が信頼に足るかどうかは、背景にある証拠の鎖にかかっている。同一の大規模タスクに対し、データ全体を一度に読み込ませた単一モデルはわずか11本の文献しか引用できなかった。この重大な取りこぼしは、単一モノリシックモデルの限界を露呈している。入力負荷がキャパシティを超えると、モデルの検索視野とアテンション集中力は急激に減衰する。
分散型エージェント群は、情報流通のあり方を根底から変えた。約2,000体のエージェントが検索、仮説生成、相互検証といった役割を分担。特定の細胞亜集団で見られる異常発現に対して標的調査を展開した。bioRxivプレプリント論文によれば、分散システムは同一タスクにおいて約7,600本の学術文献を参照・検証しており、文献網羅規模は単一モデルの711倍に達した。
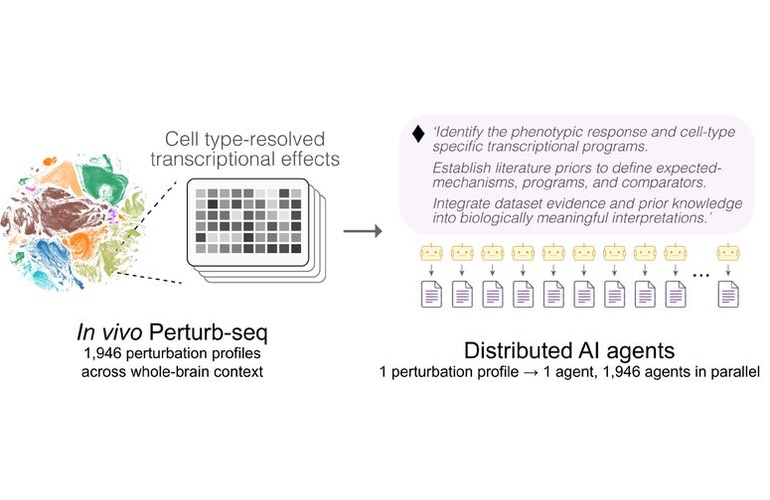 図:分散型エージェントの階層型スケジューリング構造。各ノードが単一遺伝子擾乱の文献照合と逆方向検証を独立して実行する。出典:R&D World(Sun et al., bioRxiv より引用)
大容量データを無差別に与えると、AIは容易に偽相関を見出してしまう。タスクを微細に切り刻み、数千のエージェントが手分けして精読と照合を重ねることで、堅固なエビデンスネットワークが形成された。タスク分解の深さこそが、科学推論における証拠の広がりを直接左右する。
30名の生物学博士によるブラインド審査、48件の発見を忠実に再現
AIが推論を立てること自体は難しくない。真に困難なのは、査読に耐えうる水準を担保することだ。推論の妥当性を評価するため、研究チームは30名の生物学博士を招いて二重盲検審査を実施した。審査員はレポートの作成元を知らされない状態で、推論の妥当性を厳しく採点した。
エージェント群は元の論文原稿を事前学習していない。にもかかわらず盲検テストにおいて、既知の主要発見55項目のうち48項目(再現率87%)を独自に再現した。レポートの完成度比較においても、専門家の75%が単一モデルではなく分散エージェントの出力を高く評価した。
 図:左は数百万細胞のマウス全脳遺伝子発現擾乱マトリックス、右は約2000体のエージェントが並行して展開する推論トポロジー。出典:madrobot.blog
単一モデルの分析は教科書的な一般論にとどまりがちで、具体的な分子間相互作用の記述を欠く。対照的に分散クラスタでは、異なるノード同士が互いの論理の綻びを指摘し合うことで、飛躍した推論を事前に排除する。複数ノードによるクロス尋問機構が、モデル出力のハルシネーション発生率を大幅に抑え込んでいる。
埋もれた遺伝子経路を発見、AIが実験台へ新たな仮説を届ける
既知の結論をなぞるだけなら通過点に過ぎない。このシステムの真価は、人間が見落としがちな盲点を発見することにある。DCTN1 遺伝子の解析において、エージェント群はある異常シグナルを捉えた。同遺伝子が破壊されると、細胞内のコレステロール合成に関わる遺伝子発現量が顕著に上昇していたのだ。
DCTN1 はダイニンサブユニットをコードし、筋萎縮性側索硬化症(ALS)などの神経変性疾患に深く関与している。従来の先行研究は主に軸索輸送の停滞に着目しており、この遺伝子とコレステロール代謝を結びつけて考える研究者はほとんどいなかった。エージェント群は数十件のマイナーな文献を突き合わせ、首尾一貫した分子メカニズム仮説を構築した。
レポートによれば、軸索輸送の障害によりコレステロールが細胞体へ正常に戻れなくなり、局所的な欠乏を感知した細胞核がSREBP経路を作動させて代償的合成を行い、結果として神経細胞障害を悪化させているという。精密なタスク分担は、分野の壁を軽々と越えた。この推論は、その後の創薬研究において全く新しい治療標的を提示している。
計算資源が仮説のボトルネックを解消、それでも最終審判はウェット実験にある
32分で膨大な推論を導き出した数字は鮮烈だ。しかし生命科学における真実の判定権は、常に物理世界に実在する生体分子の手にある。文献引用数の多さは検索視野の広範さを示すものであり、推論が絶対的に正しいことを保証するわけではない。シャーレとピペットによる実証を経ていない推測は、検証を待つ有望な候補リストに過ぎない。
研究に参加した科学者たちも、エージェントが提示したメカニズムは必ずウェットラボでの実験検証を経なければならないと明言している。AIは実験生物学者の手作業を置き換えるものではなく、科学仮説の生み出し方を再構築するツールなのだ。かつては数カ月かけて1つの仮説に辿り着いていた作業を、アルゴリズムは強固な証拠とともに実験台へと直接届けてくれる。
研究工程を十分に細分化して初めて、計算能力は科学的発見の真の加速器となる。ライフサイエンスにおけるAIの進化の道筋は明確になりつつある。すべてを1体で解決する万能モデルを待つ必要はない。精緻な工学的役割分担と相互検証メカニズムを整えれば、数百数千のマイクロエージェントが結集し、高効率な科学探査チームとして機能するのだ。
参考リンク:
- OpenAI 公式研究レポート:複雑な生物学的データに向けた AI 研究のスケール展開
- bioRxiv プレプリント論文:分散型 AI エージェントによる大規模な生物学的知見の統合
- R&D World 報道:OpenAIが約2000体のGPT-Rosalindを展開し32分で生物学的研究リードを生成
- GitHub オープンソース:分散エージェントによる生物学的推論グラフ